Когда в 2016 году программа AlphaGo победила чемпиона мира по го Ли Седоля, это стало поворотным моментом для искусственного интеллекта. За этим успехом стоял Демис Хассабис — человек, который с детства мыслил категориями игр, науки и систем. Его компания DeepMind не просто создала мощный AI, но и показала, как игры могут стать полигоном для решения реальных научных проблем. Понимание этого подхода даёт ключ к тому, как строить технологии, которые обучаются самостоятельно.
- Кто такой Демис Хассабис: краткая биография предпринимателя
- Как DeepMind объединила науку, игры и искусственный интеллект
- От игр к науке: AlphaFold и другие прорывы
- Принципы работы DeepMind: как это работает простыми словами
- Влияние на науку и технологическое предпринимательство
- Ключевые уроки из биографии Демиса Хассабиса для предпринимателей
- Факты о Демисе Хассабисе, которые стоит знать
- Будущее DeepMind и роль Демиса Хассабиса
- Практическое значение подхода DeepMind для других сфер
- Выводы: почему история Демиса Хассабиса важна сегодня
Кто такой Демис Хассабис: краткая биография предпринимателя
Демис Хассабис родился 27 июля 1976 года в Лондоне в семье грека-киприота и сингапурской китаянки. Его путь к искусственному интеллекту начался с шахмат. В четыре года он наблюдал за игрой отца, а уже в 13 достиг рейтинга мастера — второго в мире среди игроков своего возраста. Именно шахматы научили его мыслить стратегически, просчитывать ходы наперёд и распознавать паттерны. Эти навыки стали фундаментом для последующего интереса к когнитивным процессам.
Образование Хассабиса отражает его междисциплинарный подход. Он окончил Кембриджский университет с отличием по специальности компьютерные науки (1997). Затем, чувствуя потребность глубже понять человеческий мозг, получил степень PhD по когнитивной нейронауке в Университетском колледже Лондона (2009). Его исследования касались памяти, воображения и планирования — тех самых функций, которые он позже пытался воссоздать в AI. Это сочетание компьютерных наук и нейронауки оказалось критическим для создания DeepMind.
Перед тем как основать DeepMind, Хассабис успел поработать в сфере видеоигр. В подростковом возрасте он работал дизайнером над игрой Theme Park (1994) в Bullfrog Productions, а впоследствии основал собственную студию Elixir Studios. Там он руководил созданием амбициозных игр, таких как Republic: The Revolution и Evil Genius. Этот опыт дал ему понимание сложных симуляций, поведения агентов и важности игровой среды для тестирования алгоритмов. Именно в играх он увидел идеальную площадку для развития интеллекта машин.
В 2010 году Хассабис вместе с Шейном Леггом и Мустафой Сулейманом основал DeepMind Technologies. Название отражало цель: глубокое сочетание машинного обучения и нейронауки для создания общего искусственного интеллекта. В 2014 году Google приобрёл компанию за более чем 500 миллионов долларов, что стало одной из крупнейших сделок в сфере AI на тот момент. После этого Хассабис продолжил руководить DeepMind как независимым подразделением, сохраняя научный фокус.
Как DeepMind объединила науку, игры и искусственный интеллект
Базовый принцип DeepMind заключается в том, что игры являются идеальной средой для тренировки алгоритмов. В отличие от реального мира, игры имеют чёткие правила, измеримые результаты и безопасную среду для экспериментов. Это позволяет AI быстро перебирать миллионы вариантов, обучаясь методом проб и ошибок. Компания использует обучение с подкреплением — метод, при котором агент получает вознаграждение за правильные действия и штраф за неправильные, постепенно улучшая свою стратегию.
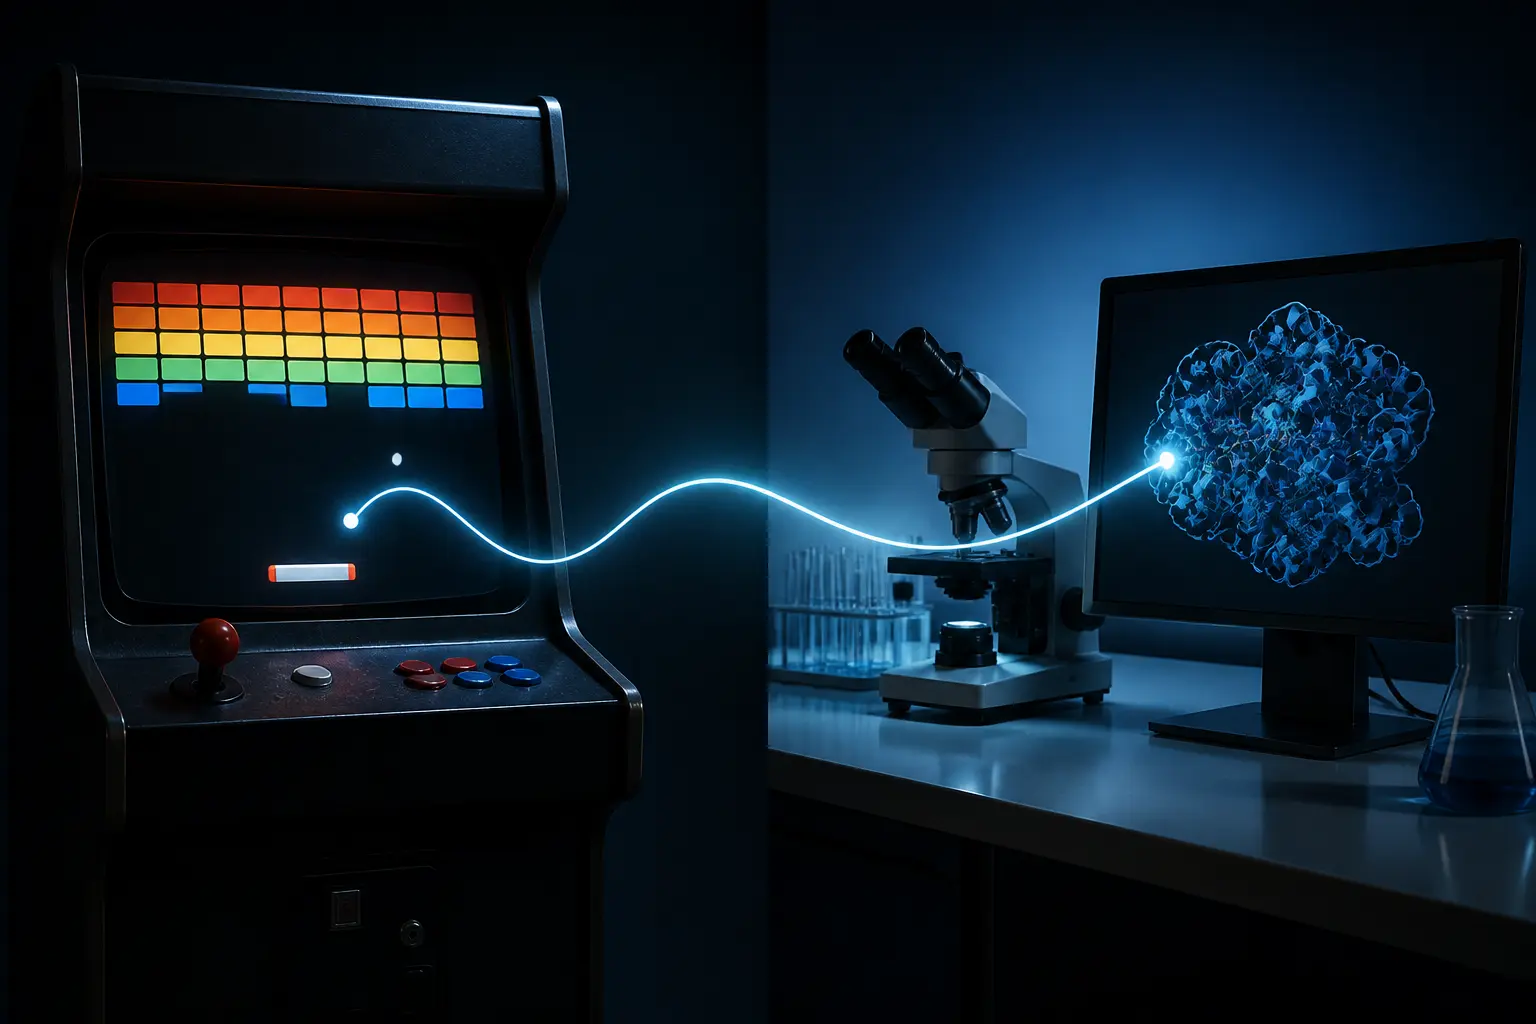
Первым громким успехом стала система DQN (Deep Q-Network). В 2013-2015 годах она научилась играть в 49 классических игр Atari 2600, не имея ни одной заранее запрограммированной стратегии. Единственными входными данными были пиксели на экране и счёт. В некоторых играх DQN превзошла профессиональных игроков-людей. Это продемонстрировало ключевую идею: AI может самостоятельно формировать понимание игры, просто взаимодействуя с ней.
Следующим шагом стала AlphaGo. В 2016 году она обыграла Ли Седоля, одного из сильнейших игроков в истории го. Сложность игры го заключается в огромном количестве возможных позиций — больше, чем атомов во Вселенной. AlphaGo сочетала глубокое обучение и метод поиска по дереву Монте-Карло. Но настоящим прорывом стала способность системы к творческим ходам, которые выходили за пределы человеческой интуиции. Победа над Ли Седолем показала, что AI может осваивать сверхсложные задачи, которые считались исключительно человеческими.
После AlphaGo команда DeepMind разработала AlphaZero. Эта система училась играть в шахматы, сёги и го, не имея никаких начальных знаний об игре, кроме правил. Через несколько часов самостоятельной игры AlphaZero победила лучшие специализированные программы. Это было важным шагом к идее общего AI, который не нуждается в человеческом опыте для освоения новых доменов.
Отдельно стоит упомянуть AlphaStar, которая достигла гроссмейстерского уровня в стратегической видеоигре StarCraft II. Здесь задача была сложнее из-за неполной информации, необходимости долгосрочного планирования и управления многими юнитами одновременно. AlphaStar тренировалась на сотнях лет игрового времени, используя многоагентное обучение с подкреплением. Эти разработки непосредственно повлияли на практические применения AI в науке.
От игр к науке: AlphaFold и другие прорывы
Наиболее значимым научным достижением DeepMind стал AlphaFold. Эта система предсказывает трёхмерную структуру белков на основе их аминокислотной последовательности. Проблема сворачивания белков оставалась нерешённой на протяжении 50 лет. В 2020 году на конкурсе CASP14 AlphaFold2 показал точность, сравнимую с экспериментальными методами. Это открыло новые возможности для разработки лекарств, понимания болезней и биотехнологий.
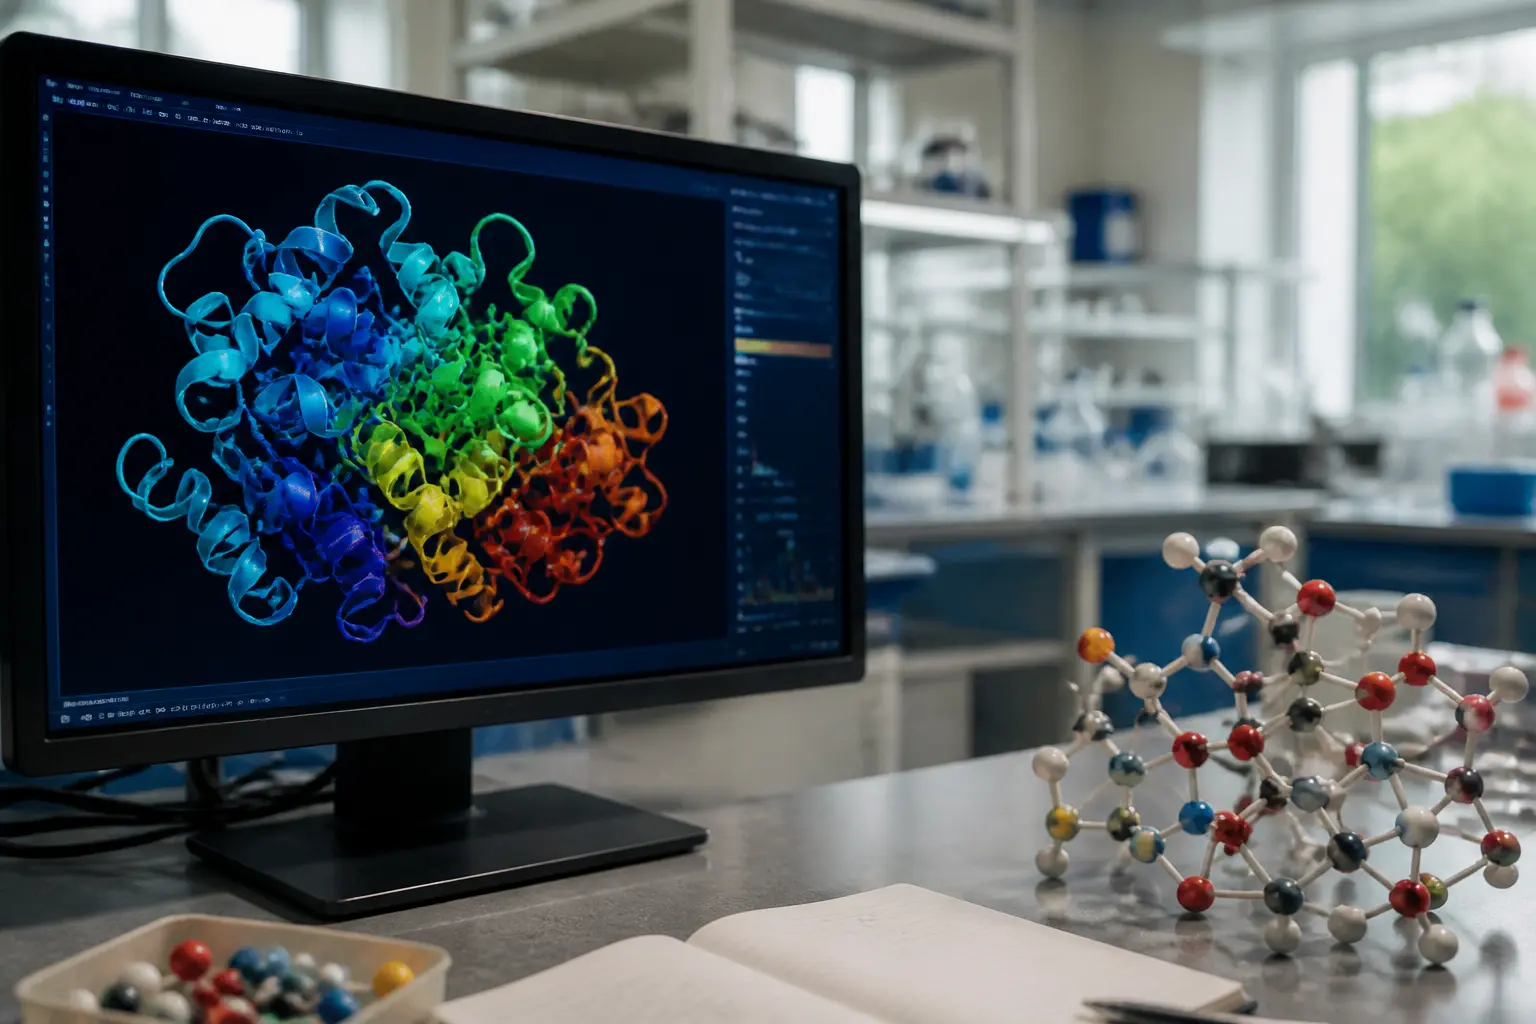
Подход, применённый в AlphaFold, базировался на тех же принципах, что и в игровых системах: обучение на огромных массивах данных, использование нейросетей для выявления закономерностей и итеративное улучшение. DeepMind также применила AI для оптимизации энергопотребления в центрах обработки данных Google, сократив расходы на охлаждение на 40%. Эти примеры доказывают, что методы, отточенные на играх, имеют прямую практическую ценность.
Принципы работы DeepMind: как это работает простыми словами
Чтобы понять подход DeepMind, стоит выделить несколько ключевых компонентов. Во-первых, это нейронные сети — математические модели, имитирующие работу мозга. Они состоят из слоёв искусственных нейронов, которые обрабатывают информацию и обучаются на примерах. Во-вторых, это обучение с подкреплением, где агент взаимодействует со средой, получая обратную связь. Этот метод не требует готовых ответов; система сама находит оптимальное поведение.
В-третьих, DeepMind активно использует симуляции. Вместо того чтобы обучать AI в реальном мире, что медленно и дорого, компания создаёт виртуальные среды, где алгоритмы могут безопасно экспериментировать. Например, для тренировки роботов применяются физические симуляторы, где AI учится ходить, манипулировать объектами и выполнять задания. Это позволяет ускорить обучение в тысячи раз.
Важным является также сочетание различных типов обучения. AlphaGo использовала как обучение с учителем (на основе партий людей), так и обучение с подкреплением (играя против себя). AlphaZero вообще отказалась от человеческих данных, полагаясь только на самоигру. Этот переход к самообучению является центральным в философии компании. Цель — создать системы, которые могут осваивать любое задание без вмешательства человека.
Ещё один принцип — масштабируемость. DeepMind инвестирует в огромные вычислительные мощности, в частности тензорные процессоры Google. Но дело не только в мощности. Архитектура систем разрабатывается так, чтобы эффективно использовать ресурсы. Например, AlphaFold2 использовала механизм внимания для фокусировки на наиболее важных частях данных, что значительно повысило точность предсказаний.
Влияние на науку и технологическое предпринимательство
Успех DeepMind изменил ландшафт AI-исследований. Во-первых, компания показала, что фундаментальная наука может быть коммерчески успешной. Приобретение Google подтвердило, что глубокие исследования имеют огромную ценность. Это стимулировало инвестиции в AI-стартапы по всему миру. Во-вторых, Хассабис стал примером нового типа технологического лидера — учёного-предпринимателя, который сочетает академическую глубину с бизнес-амбициями.
Для научного сообщества DeepMind открыла новые инструменты. AlphaFold сделала предсказание структуры белков доступным для исследователей во всём мире через открытую базу данных. Это ускорило работу в области молекулярной биологии, разработки лекарств и борьбы с болезнями. Компания также публикует свои исследования в ведущих научных журналах, придерживаясь принципов открытости, хотя некоторые критики указывают на ограниченный доступ к коду.
Опыт Хассабиса также подчёркивает важность междисциплинарности. Его карьера охватывает нейронауку, компьютерные науки, игровую индустрию и предпринимательство. Именно на стыке этих сфер возникли прорывные идеи. Для тех, кто интересуется созданием AI-компаний, это служит напоминанием: не бойтесь сочетать разные знания. Самые интересные решения часто лежат на границе дисциплин.
Ключевые уроки из биографии Демиса Хассабиса для предпринимателей
Опыт основателя DeepMind даёт несколько практических уроков. Первое: ставьте амбициозные, почти невозможные цели. Хассабис с самого начала стремился создать общий искусственный интеллект, а не просто коммерческий продукт. Это привлекло талантливых людей и долгосрочные инвестиции. Второе: используйте игры и симуляции для быстрого тестирования идей. Это дешевле и безопаснее, чем реальные испытания.
Третье: инвестируйте в фундаментальные исследования, даже если они не приносят немедленной прибыли. AlphaFold не была коммерческим продуктом при запуске, но её влияние на науку и репутацию компании оказалось колоссальным. Четвёртое: стройте сильную команду. Хассабис привлёк ведущих экспертов по нейронауке, машинному обучению и инженерии, создав среду, где научная любознательность ценится превыше всего.
Наконец, важно сохранять этическую позицию. DeepMind с первых дней уделяла внимание безопасности AI и его влиянию на общество. Это не просто пиар, а осознание ответственности, что вызывает доверие. Для предпринимателей это означает, что долгосрочный успех невозможен без учёта социальных последствий технологий.
Факты о Демисе Хассабисе, которые стоит знать
Вот несколько менее известных, но показательных фактов. Хассабис был членом сборной Англии по шахматам среди юниоров. В подростковом возрасте он также увлекался созданием видеоигр на компьютере ZX Spectrum. Его любимая настольная игра — «Цивилизация», что отражает его интерес к системному мышлению. В 2017 году он получил звание командора Ордена Британской империи (CBE) за заслуги в науке и технологиях.
Хассабис известен своей способностью к глубокой концентрации. По свидетельствам коллег, он может часами обдумывать проблему, не отвлекаясь. Эта черта, вероятно, сформировалась ещё в шахматах, где требуется длительная умственная выносливость. Также он активно выступает за использование AI для решения глобальных проблем, таких как изменение климата, здравоохранение и образование.
Интересно, что несмотря на работу в Google, Хассабис сохранил значительную автономию. DeepMind имеет собственную культуру, офисы в Лондоне и исследовательский фокус. Это редкий случай, когда приобретённый стартап продолжает действовать почти независимо. Такая модель может быть примером для других основателей, которые хотят сохранить контроль над видением.
Будущее DeepMind и роль Демиса Хассабиса
Хассабис возглавляет Google DeepMind, созданную после объединения DeepMind и Google Brain в 2023 году. В 2024 году Демис Хассабис и Джон Джампер получили половину Нобелевской премии по химии за предсказание структуры белков с помощью AlphaFold2; вторую половину присудили Дэвиду Бейкеру за вычислительный дизайн белков. Его текущая цель — продвижение к общему искусственному интеллекту (AGI). Это система, способная выполнять любое интеллектуальное задание, которое под силу человеку. Хотя до AGI ещё далеко, Хассабис считает, что ключ лежит в сочетании обучения с подкреплением, нейронауки и больших вычислительных ресурсов.
Одним из перспективных направлений является создание мультимодальных систем, которые могут работать с текстом, изображениями, видео и физическим миром одновременно. Другое — применение AI в робототехнике, где агенты обучаются манипулировать объектами в реальном мире. DeepMind также исследует возможности AI для научных открытий, например, в материаловедении или синтезе новых соединений.
Хассабис часто подчёркивает важность международного сотрудничества и этических стандартов. Он выступает за осторожное развитие AI, с акцентом на безопасность и пользу для человечества. Это не просто слова: DeepMind имеет внутреннюю команду по безопасности и этике, а также участвует в глобальных дискуссиях по регулированию AI.
Практическое значение подхода DeepMind для других сфер
Методы, разработанные в DeepMind, уже находят применение за пределами компании. Например, алгоритмы обучения с подкреплением используются в логистике для оптимизации маршрутов, в финансах для управления портфелями, в энергетике для балансировки сетей. Главная идея — создание агентов, которые самостоятельно обучаются в сложных средах — универсальна.
Для бизнеса важный урок заключается в том, что симуляции могут значительно снизить риски. Прежде чем внедрять AI в реальные процессы, компании могут создать цифровые двойники и протестировать алгоритмы. Это экономит время и деньги. Также стоит обратить внимание на важность данных: успех DeepMind базируется на огромных объёмах качественных данных, будь то партии го или белковые последовательности.
Для исследователей и стартапов пример Хассабиса демонстрирует ценность долгосрочного мышления. Вместо быстрого выхода на рынок, он инвестировал годы в фундаментальные исследования. Это рискованно, но может принести гораздо большие плоды. Кроме того, открытость к сотрудничеству с академическим миром помогает привлекать лучшие умы и оставаться на передовой науки.
Выводы: почему история Демиса Хассабиса важна сегодня
Путь Демиса Хассабиса — это не просто биография успешного предпринимателя. Это демонстрация того, как сочетание науки, игр и технологий может создать нечто большее, чем сумма частей. Его подход показывает, что игры — это не развлечение, а мощный инструмент для обучения AI. А глубокое понимание человеческого мозга может подсказать, как строить более умные машины.
Для тех, кто интересуется искусственным интеллектом или планирует собственный стартап, история Хассабиса даёт практические ориентиры. Ставьте амбициозные цели, используйте игры для тестирования, инвестируйте в исследования и не бойтесь сочетать разные дисциплины. И главное — помните об ответственности. Настоящий успех измеряется не только прибылью, но и влиянием на мир.