Коли говорять про штучний інтелект, зазвичай згадують алгоритми, нейромережі або готові продукти на кшталт чат-ботів. Але за лаштунками залишається те, без чого жодна модель не запрацює — AI infrastructure. Це не просто залізо чи софт, а цілісна система, яка забезпечує обробку даних, навчання моделей та їхнє розгортання в реальному середовищі. Розберімося, що саме входить до цього поняття, як воно працює і чому без нього неможливий сучасний бізнес.
- AI infrastructure: що це простими словами
- Основні компоненти AI infrastructure
- Апаратне забезпечення
- Сховища даних
- Мережева інфраструктура
- Програмні платформи та фреймворки
- Як працює AI infrastructure: життєвий цикл моделі
- Приклади AI infrastructure у різних галузях
- Виробництво
- Ланцюги постачання
- Охорона здоров’я
- Ключові виклики при побудові AI infrastructure
- Хмарна AI infrastructure vs власна: що обрати
- Майбутнє AI infrastructure: що далі
- Практичні поради для тих, хто починає будувати AI infrastructure
- Часті запитання
- Яка різниця між AI infrastructure та звичайною IT-інфраструктурою?
- Чи можна використовувати звичайні сервери для AI?
- Скільки коштує побудувати AI infrastructure?
- Які навички потрібні для роботи з AI infrastructure?
- Чи обов’язково використовувати хмару?
AI infrastructure: що це простими словами
Уявіть, що ви будуєте будинок. Алгоритми та моделі — це проєкт і дизайн, але без фундаменту, стін, комунікацій і будівельної техніки нічого не вийде. Саме цю роль виконує AI infrastructure — сукупність апаратних, програмних і мережевих компонентів, які дають змогу створювати, тренувати та використовувати системи штучного інтелекту.
Якщо говорити зовсім просто, AI infrastructure — це все, що потрібно для запуску ШІ-проєкту, окрім самих алгоритмів. Вона охоплює обчислювальні потужності, системи зберігання даних, мережі, програмні платформи та інструменти для керування життєвим циклом моделей.
Основні компоненти AI infrastructure
Щоб зрозуміти, як це працює, варто розглянути ключові складові. Кожна з них вирішує конкретне завдання, а разом вони утворюють єдиний організм.
Апаратне забезпечення
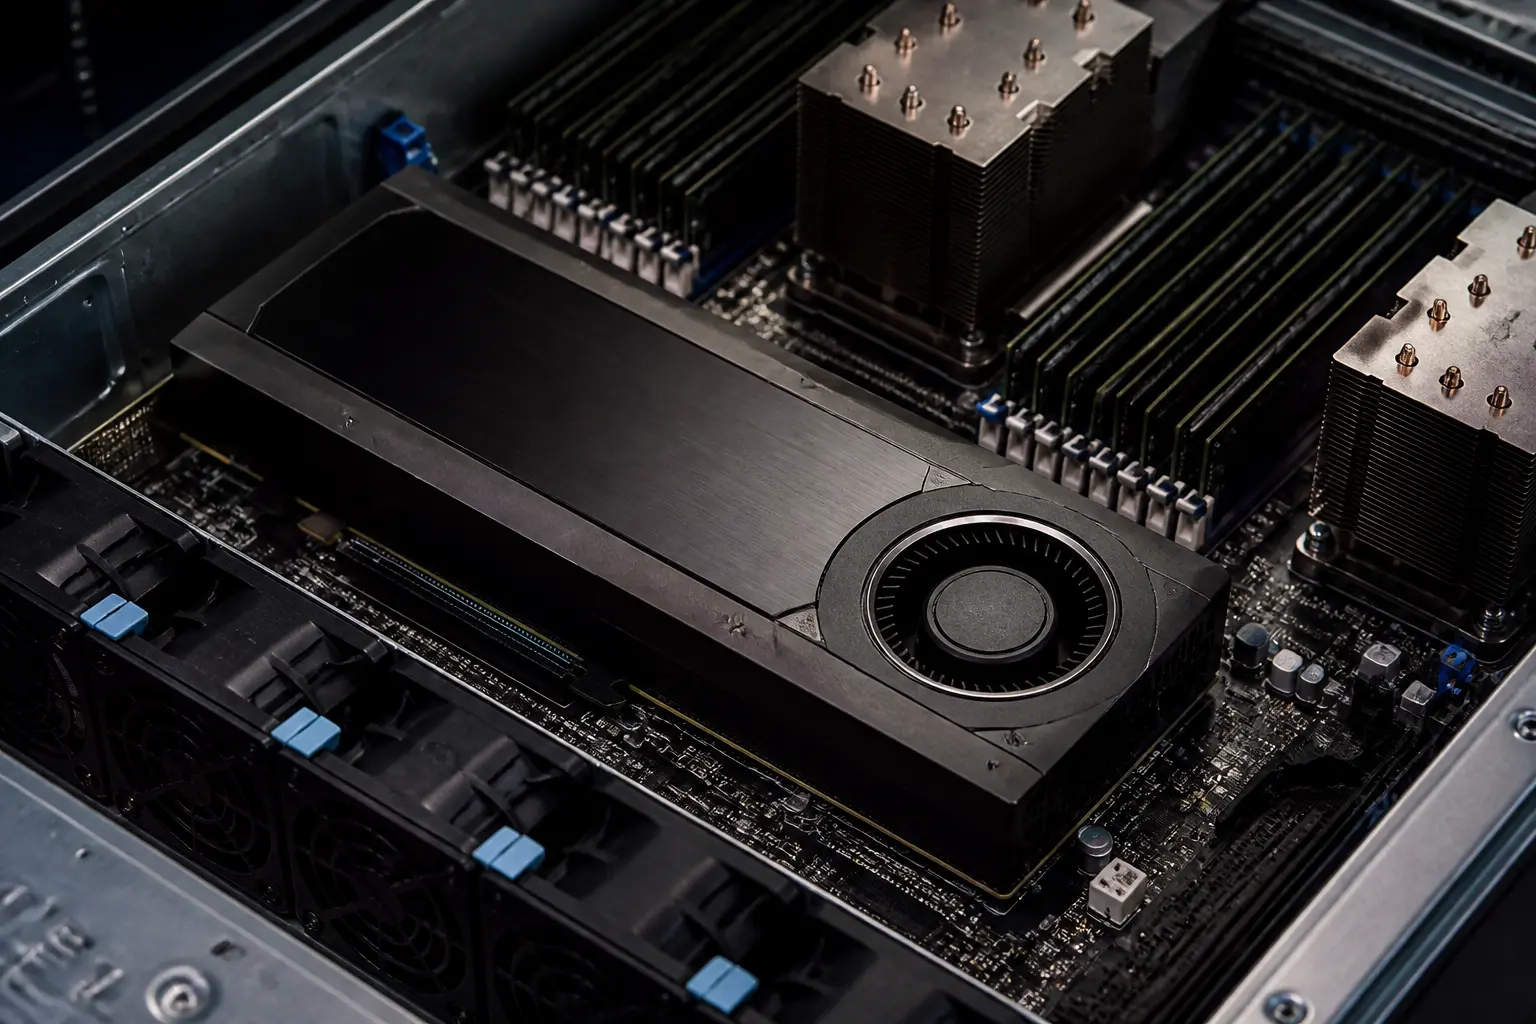
Обчислювальна потужність — серце будь-якої AI-системи. Для тренування складних моделей, особливо глибоких нейромереж, потрібні спеціалізовані процесори. Найчастіше це графічні процесори (GPU) — наприклад, NVIDIA A100 або H100, які можуть виконувати тисячі паралельних обчислень. У деяких випадках застосовують тензорні процесори (TPU) від Google або спеціалізовані чипи на кшталт AWS Trainium.
Окрім процесорів, апаратна частина включає сервери з великим обсягом оперативної пам’яті, високошвидкісні системи зберігання даних (SSD, NVMe) та мережеве обладнання з низькою затримкою. Для великих проєктів часто використовують кластери — сотні або тисячі з’єднаних між собою серверів.
Сховища даних
Дані — це сировина для ШІ. Без якісного та швидкого доступу до них неможливо навчати моделі. AI infrastructure передбачає розподілені файлові системи, об’єктні сховища (наприклад, Amazon S3), озера даних та бази даних, оптимізовані для аналітики. Важливо не лише зберігати петабайти інформації, а й забезпечувати високу пропускну здатність, щоб дані надходили до обчислювальних вузлів без затримок.
Мережева інфраструктура
Коли йдеться про розподілене навчання на сотнях GPU, швидкість передачі даних між вузлами стає критичною. Тому в AI-інфраструктурі використовують високошвидкісні мережі InfiniBand, RoCE або спеціалізовані фабрики NVLink. Вони зменшують затримки та підвищують пропускну здатність, що безпосередньо впливає на час тренування моделей. Подібні принципи розподіленої обробки сигналів використовують і в що таке робототехніка: просте пояснення з прикладами, де рішення ухвалюються в реальному часі.
Програмні платформи та фреймворки
Апаратне забезпечення марне без програмного прошарку. До нього належать фреймворки для глибокого навчання (PyTorch, TensorFlow, JAX), системи управління контейнерами (Docker, Kubernetes), платформи для оркестрації обчислень (Apache Spark, Ray) та інструменти MLOps для автоматизації життєвого циклу моделей.
Ці інструменти дають змогу інженерам абстрагуватися від фізичного заліза й керувати ресурсами програмно: запускати експерименти, масштабувати навчання, відстежувати версії моделей і даних.
Як працює AI infrastructure: життєвий цикл моделі
Щоб краще зрозуміти роль інфраструктури, простежмо шлях типового ШІ-проєкту. Уявімо, що компанія хоче створити систему прогнозування попиту для роздрібної мережі.
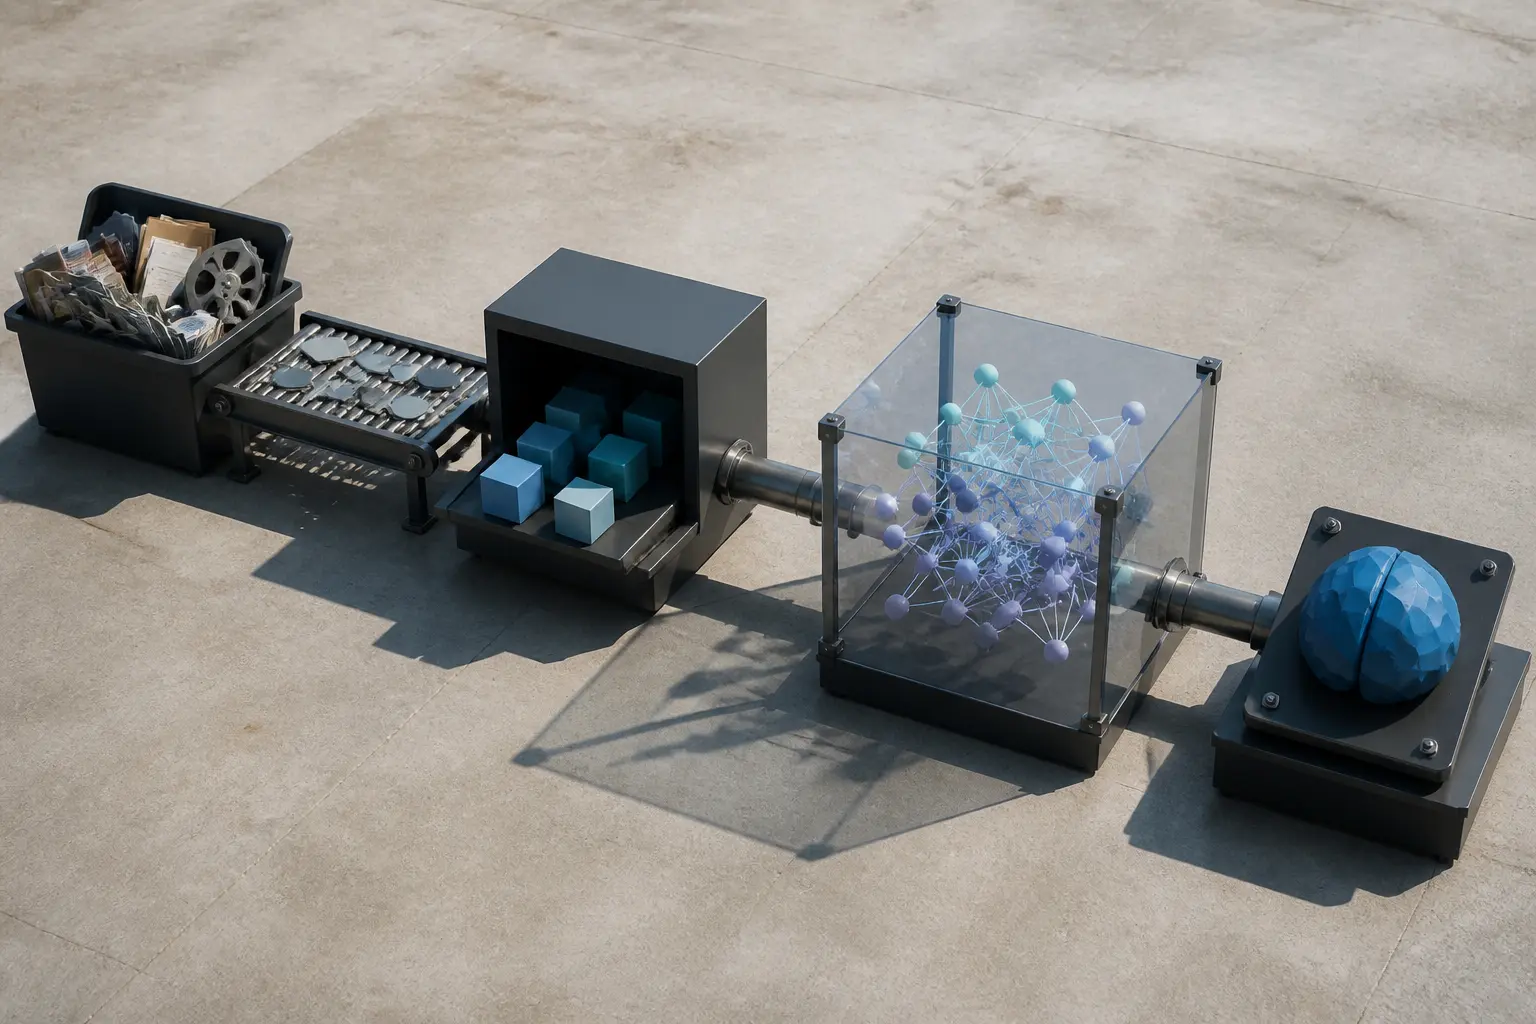
Спочатку дані з касових апаратів, складів і зовнішніх джерел надходять до озера даних. Там вони проходять очищення, нормалізацію та агрегацію — це завдання конвеєрів даних, які працюють на розподілених обчислювальних кластерах. Потім підготовлені дані завантажуються в середовище для тренування, де на десятках GPU запускається навчання нейромережі. Процес може тривати години або дні, і весь цей час інфраструктура має забезпечувати стабільне живлення, охолодження та мережевий зв’язок.
Після тренування модель оцінюють на тестових даних, і якщо результати задовільні, її розгортають у продуктивному середовищі. Тут вона працює в режимі реального часу, отримуючи нові дані через API та видаючи прогнози. Для цього потрібна окрема інфраструктура з балансувальниками навантаження, контейнерами та моніторингом. І весь цей цикл повторюється регулярно, оскільки моделі потребують перенавчання на свіжих даних.
Приклади AI infrastructure у різних галузях
Теорія стає зрозумілішою, коли бачиш реальні застосування. Ось кілька прикладів із різних секторів.
Виробництво
На сучасному заводі сотні датчиків фіксують температуру, вібрацію, тиск та інші параметри обладнання. Ці дані потоком надходять до центральної системи, де моделі машинного навчання прогнозують поломки за кілька днів до того, як вони стануться. Така система потребує потужної периферійної інфраструктури для попередньої обробки даних безпосередньо на виробничій лінії (edge computing) та хмарних ресурсів для тренування й аналізу історичних даних.
Наприклад, виробник може навчати моделі комп’ютерного зору для перевірки зварних швів, а потім запускати їх на периферійних пристроях біля виробничої лінії. Конкретна кількість прискорювачів залежить від моделі, обсягу даних і потрібної швидкості навчання.
Ланцюги постачання
У логістиці ШІ допомагає оптимізувати маршрути, прогнозувати затримки та керувати запасами. Уявіть велику дистрибуційну компанію, яка щодня обробляє мільйони посилок. Її AI-інфраструктура включає хмарні сховища для зберігання історичних даних про перевезення, потокову обробку даних із GPS-трекерів та спеціалізовані сервери для виконання алгоритмів оптимізації.
Конкретний приклад: система прогнозування часу доставки аналізує погоду, трафік, завантаженість складів та історичні патерни. Для цього потрібні не лише навчені моделі, а й механізми швидкого доступу до різнорідних даних, що є прямим завданням AI-інфраструктури.
Охорона здоров’я
У медичних установах ШІ допомагає аналізувати знімки МРТ, КТ та рентгенівські зображення. Для цього потрібні величезні обсяги даних — один томографічний знімок може займати сотні мегабайт. Інфраструктура тут включає захищені сховища, що відповідають вимогам конфіденційності (наприклад, HIPAA), обчислювальні кластери для тренування моделей сегментації та спеціалізоване програмне забезпечення для розгортання моделей у клінічних умовах.
Цікаво, що дедалі частіше використовують федеративне навчання: необроблені навчальні дані можуть залишатися в локальних сховищах, а між учасниками передаються оновлення моделі. Це зменшує потребу централізувати дані, але не усуває ризиків витоку через оновлення, метадані чи помилки конфігурації.
Ключові виклики при побудові AI infrastructure
Розгортання інфраструктури для ШІ — не лише технічне, а й організаційне завдання. Ось із чим стикаються компанії найчастіше.
- Вартість обладнання. Сучасні GPU коштують десятки тисяч доларів, а для великих проєктів потрібні сотні таких пристроїв. Не всі можуть дозволити собі власний кластер, тому популярні хмарні рішення з оплатою за використання.
- Енергоспоживання та охолодження. Споживання GPU залежить від моделі й налаштувань, а повна потужність сервера включає процесори, пам’ять, мережу та охолодження. Тому енергетичний бюджет рахують для всієї системи, а не за паспортом одного прискорювача.
- Масштабування. Коли обсяги даних зростають, інфраструктура має масштабуватися лінійно або майже лінійно. Це складне інженерне завдання, особливо для розподіленого навчання.
- Управління даними. Дані часто розрізнені, неструктуровані та потребують постійної валідації. Без налагоджених конвеєрів даних навіть найпотужніше залізо простоюватиме.
- Безпека та відповідність нормам. Особливо критично в регульованих галузях — фінансах, медицині, державному секторі. Інфраструктура має забезпечувати шифрування, контроль доступу та аудит.
Хмарна AI infrastructure vs власна: що обрати
Це одне з перших питань, яке постає перед компанією. Однозначної відповіді немає — усе залежить від масштабу, бюджету та специфіки завдань.
| Критерій | Хмарна інфраструктура | Власна інфраструктура |
|---|---|---|
| Початкові витрати | Низькі, оплата за використання | Високі, потрібні значні капіталовкладення |
| Масштабованість | Практично необмежена, швидке масштабування | Обмежена фізичними ресурсами, потребує часу на розширення |
| Контроль над безпекою | Залежить від провайдера, можливі обмеження | Повний контроль, але потребує власної експертизи |
| Загальна вартість при великих обсягах | Може бути вищою за тривалого використання | Нижча за умови високого завантаження |
| Гнучкість конфігурації | Обмежена доступними типами інстансів | Можна оптимізувати під конкретні завдання |
На практиці багато компаній використовують гібридний підхід: тренування моделей — у хмарі, а розгортання — на власних серверах, ближче до джерел даних. Це дає змогу балансувати між гнучкістю та контролем.
Майбутнє AI infrastructure: що далі
Технології не стоять на місці, і AI-інфраструктура активно еволюціонує. Ось кілька тенденцій, які вже помітні.
- Спеціалізовані чипи. Окрім GPU, з’являються процесори, створені виключно для ШІ-навантажень, — наприклад, TPU, IPU (Graphcore), Cerebras. Вони ефективніші для певних типів обчислень.
- Рідинне охолодження. Через зростання тепловиділення традиційні повітряні системи вже не справляються. Рідинне охолодження дає змогу розміщувати компоненти щільніше та знижувати енергоспоживання.
- Федеративне та розподілене навчання. Це дає змогу тренувати моделі на даних, які ніколи не залишають локальних пристроїв, — важливо для конфіденційності.
- Автоматизація MLOps. Інструменти на кшталт Kubeflow, MLflow та спеціалізовані платформи дедалі більше автоматизують рутинні операції, знижуючи поріг входу для команд.
Окремо варто згадати концепцію AI Factory — це цілісні інфраструктурні рішення, які постачальники (наприклад, NVIDIA з DGX SuperPOD) пропонують «під ключ». Вони включають оптимізоване залізо, мережі, програмне забезпечення та навіть системи охолодження, що значно пришвидшує розгортання.
Практичні поради для тих, хто починає будувати AI infrastructure
Якщо ви тільки плануєте впровадження ШІ у своїй компанії, ось кілька рекомендацій, які допоможуть уникнути типових помилок.
- Почніть з хмари. Це дасть змогу швидко експериментувати, не вкладаючись у дороге залізо. Коли проєкти стануть стабільними, можна розглянути гібридні або власні рішення.
- Інвестуйте в конвеєри даних. Якість даних впливає на результат більше, ніж вибір моделі. Автоматизуйте збір, очищення та валідацію даних із самого початку.
- Не нехтуйте моніторингом. Відстежуйте не лише технічні метрики (використання GPU, температура), а й бізнес-показники моделей у продуктивному середовищі. Без цього ви не дізнаєтеся, коли модель застаріла.
- Будуйте з урахуванням масштабування. Навіть якщо зараз використовується один сервер, архітектура має давати змогу додавати нові вузли без перебудови всієї системи.
- Залучайте інженерів із досвідом. AI infrastructure — це окрема спеціалізація, яка потребує знань у системному адмініструванні, мережах, хмарних технологіях та MLOps.
Пам’ятайте, що AI infrastructure — це не одноразова покупка, а постійний процес удосконалення. Технології швидко змінюються, і ваша інфраструктура має бути достатньо гнучкою, щоб адаптуватися до нових вимог.
Часті запитання
Яка різниця між AI infrastructure та звичайною IT-інфраструктурою?
Звичайна IT-інфраструктура орієнтована на типові бізнес-застосунки — вебсервери, бази даних, корпоративні системи. AI-інфраструктура вимагає значно більшої обчислювальної потужності, спеціалізованих процесорів (GPU/TPU), високошвидкісних мереж і сховищ, оптимізованих для послідовного читання великих обсягів даних. Крім того, вона включає специфічні інструменти для життєвого циклу моделей.
Чи можна використовувати звичайні сервери для AI?
Для простих моделей або невеликих наборів даних — так. Але для глибокого навчання на великих даних продуктивність CPU-серверів буде недостатньою. Навіть якщо тренування завершиться, воно може тривати тижні замість годин. Тому для серйозних проєктів використовують GPU або спеціалізовані прискорювачі.
Скільки коштує побудувати AI infrastructure?
Вартість дуже варіюється. Невеликий сервер із одним GPU може коштувати $10–20 тис. Кластер для компанії середнього розміру — від $100 тис. до кількох мільйонів. Хмарні рішення дають змогу почати з кількох доларів на годину, але за постійного використання можуть бути дорожчими за власне обладнання.
Які навички потрібні для роботи з AI infrastructure?
Це міждисциплінарна сфера. Потрібні знання системного адміністрування Linux, мережевих технологій, хмарних платформ (AWS, GCP, Azure), інструментів контейнеризації (Docker, Kubernetes), а також розуміння принципів MLOps і фреймворків глибокого навчання. Часто в командах є окремі інженери з інфраструктури та спеціалісти з машинного навчання.
Чи обов’язково використовувати хмару?
Ні, але для більшості компаній це найпростіший спосіб розпочати. Хмара дає доступ до найсучаснішого обладнання без капітальних витрат. Однак у деяких випадках — наприклад, через регуляторні обмеження або потребу в низькій затримці — виправдана власна інфраструктура або гібридний підхід.