Уявіть таблицю з замовленнями інтернет-магазину: у половині рядків місто записане як «Київ», у третині — «Kyiv», десь — «киев» маленькою літерою, а в кількох рядках міста взагалі немає. Дати записані в трьох різних форматах, ціни місцями стоять у гривнях, місцями в доларах, а один і той самий клієнт фігурує під чотирма варіантами імені. Поки цю таблицю не привести до ладу, жоден звіт, жоден рейтинг товарів і жодна інфографіка не будуть правдивими. Саме цю роботу і називають data cleaning. Кожен такий рядок приходить із власного джерело даних, тож формати й домовленості в них різняться.
- Що таке data cleaning простими словами
- Чому очищення даних займає більшу частину роботи аналітика
- Які проблеми ховаються в сирих даних
- Дублікати
- Пропущені значення
- Неконсистентні формати
- Помилки введення та аномалії
- Неактуальні та суперечливі дані
- Як працює процес очищення: методологія даних крок за кроком
- Data cleaning на практиці: два приклади
- Інструменти: чим очищають дані
- Data cleaning і якість аналітики: рейтинги та інфографіка
- Типові помилки під час очищення даних
- Короткий чекліст перед аналізом
- Часті запитання про data cleaning
- Чим data cleaning відрізняється від data preprocessing?
- Скільки часу має займати очищення?
- Чи можна повністю автоматизувати data cleaning?
- Що робити, якщо даних із пропусками забагато?
Що таке data cleaning простими словами
Data cleaning (очищення даних) — це процес виявлення та виправлення помилок, неточностей і суперечностей у наборі даних, щоб зробити його придатним для аналізу, звітності або навчання моделей. Термін простими словами означає «прибирання в таблиці»: видалити дублікати, заповнити пропуски, уніфікувати формати, виправити очевидні помилки та прибрати значення, яких не може бути в реальності.
Значення цього поняття найкраще розкривається через аналогію з кухнею. Кухар не починає готувати, поки не помиє овочі, не викине зіпсовані продукти і не наріже інгредієнти однаковими шматками. Аналітик даних робить те саме: сирі дані — це інгредієнти, а очищення — обов’язкова підготовка. Якщо пропустити цей етап, страва вийде несмачною незалежно від того, наскільки вправний кухар. У світі даних це правило відоме як garbage in, garbage out: якісь б на вході — якісь б на виході.
Data cleaning часто плутають із суміжними поняттями. Data wrangling (чи data munging) — ширший процес, який окрім очищення включає перетворення структури даних, об’єднання джерел і збагачення. ETL (extract, transform, load) — інженерний конвеєр, де очищення є лише частиною кроку transform. Тобто data cleaning — це не окрема професія і не разова акція, а обов’язковий етап будь-якої роботи з даними.
Чому очищення даних займає більшу частину роботи аналітика
У професійному середовищі сталося спостереження, що на підготовку та очищення даних аналітики й дата-саєнтисти витрачають від половини до 80% робочого часу, тоді як сам аналіз і побудова візуалізацій — решту. Точні цифри залежать від галузі та якості джерел, але порядок величини стабільний: очищення — найтрудомістіший етап.
Причина проста: реальні дані народжуються в хаосі. Їх вводять люди, які помиляються й поспішають. Їх генерують системи з різними налаштуваннями. Їх передають між відділами через експорт у Excel, де формати «пливуть». Їх накопичують роками, і за цей час змінюються назви полів, одиниці виміру та бізнес-правила. Кожен із цих факторів додає шар бруду, який треба зчищати перед тим, як рахувати рейтинги, будувати інфографіку чи навчати модель.
Ще один важливий факт: помилка, закладена на етапі очищення, не зникає далі по ланцюжку — вона множиться. Якщо ви не помітили, що частина продажів записана в іншій валюті, то середній чек, прогноз виручки й рейтинг регіонів будуть хибними, а рішення, ухвалені на їх основі, — шкідливими. Саме тому досвідчені аналітики ставляться до очищення не як до нудної рутини, а як до найвідповідальнішої частини роботи.
Які проблеми ховаються в сирих даних
Щоб data cleaning перестав бути абстракцією, варто розібрати типові категорії бруду. У практиці вони трапляються майже завжди в комбінації.
Дублікати
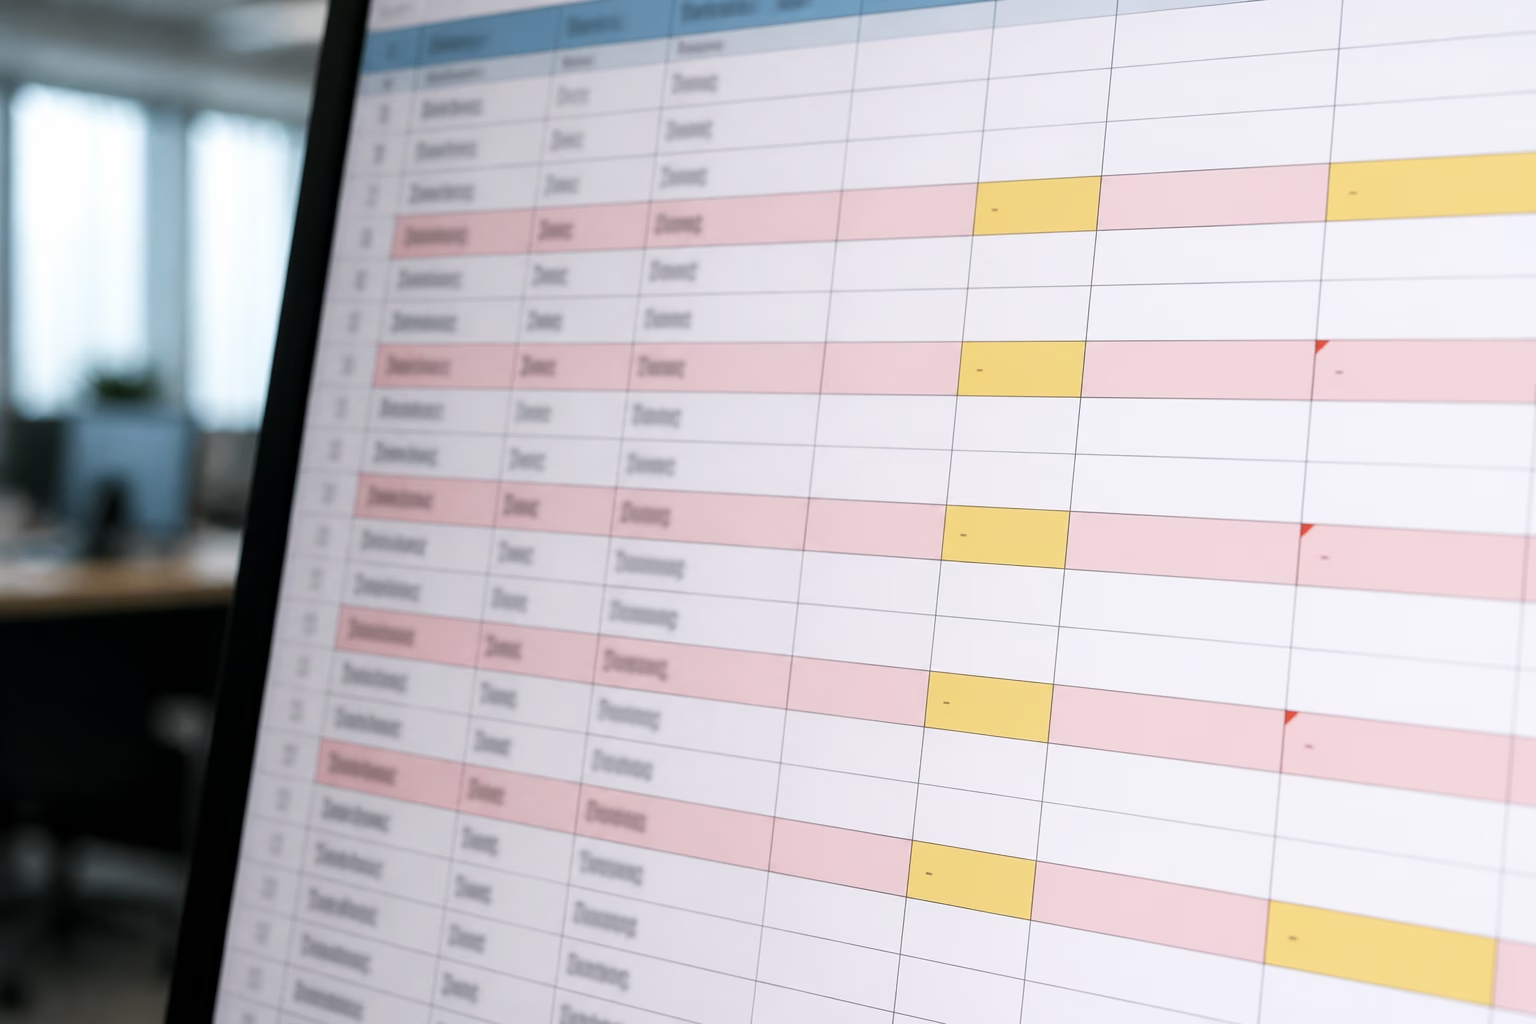
Один і той самий запис зустрічається кілька разів. Класичний приклад — клієнт, який зареєструвався двічі з різних email-адрес, або транзакція, що продублювалася через збій при імпорті. Дублікати спотворюють підсумки: кількість клієнтів, обсяг продажів, середні значення. Складність у тому, що дублікати бувають не лише точними, а й нечіткими — «Олександр Шевченко» і «О. Шевченко» з однаковою адресою доставки, ймовірно, одна людина, але просте порівняння рядків цього не побачить.
Пропущені значення
Порожні клітинки, нулі замість реальних нулів, «N/A», «—» і «невідомо» — усе це різні обличчя однієї проблеми. Важливо розрізняти, чому значення пропущене: поле не було обов’язковим, система не зібрала дані, чи сам факт не стався. Від цього залежить стратегія: заповнювати пропуск середнім, видаляти рядок чи залишати як окрему категорію.
Неконсистентні формати
Дати у форматах «01.02.2024», «2024-02-01» і «Feb 1, 2024» виглядають однаково для людини, але для програми це три різні значення. Те саме з телефонами («+380…», «380…», «068…»), валютами, одиницями виміру та регістром літер. Без нормалізації групування й підрахунки дають безглузді результати: «Київ» і «KYIV» потраплять у різні рядки звіту.
Помилки введення та аномалії
Вік клієнта 214 років, від’ємна кількість товару, дата народження в майбутньому, ціна з двома зайвими нулями. Такі викиди виникають через друкарські помилки, збої датчиків або помилкові одиниці виміру. Частина виявляється простими перевірками діапазону, частина — лише статистичним аналізом розподілу.
Неактуальні та суперечливі дані
Клієнт переїхав, а стара адреса лишилася. У двох системах для одного замовлення різні статуси. Назва компанії змінилася після ребрендингу. Такі проблеми найважче виявити автоматично, бо кожне значення окремо виглядає коректним — суперечність видно лише в порівнянні або в контексті часу.
Як працює процес очищення: методологія даних крок за кроком
Data cleaning — не хаотичне виправлення помилок, а повторювана методологія. Умовно її можна подати як цикл із шести кроків.
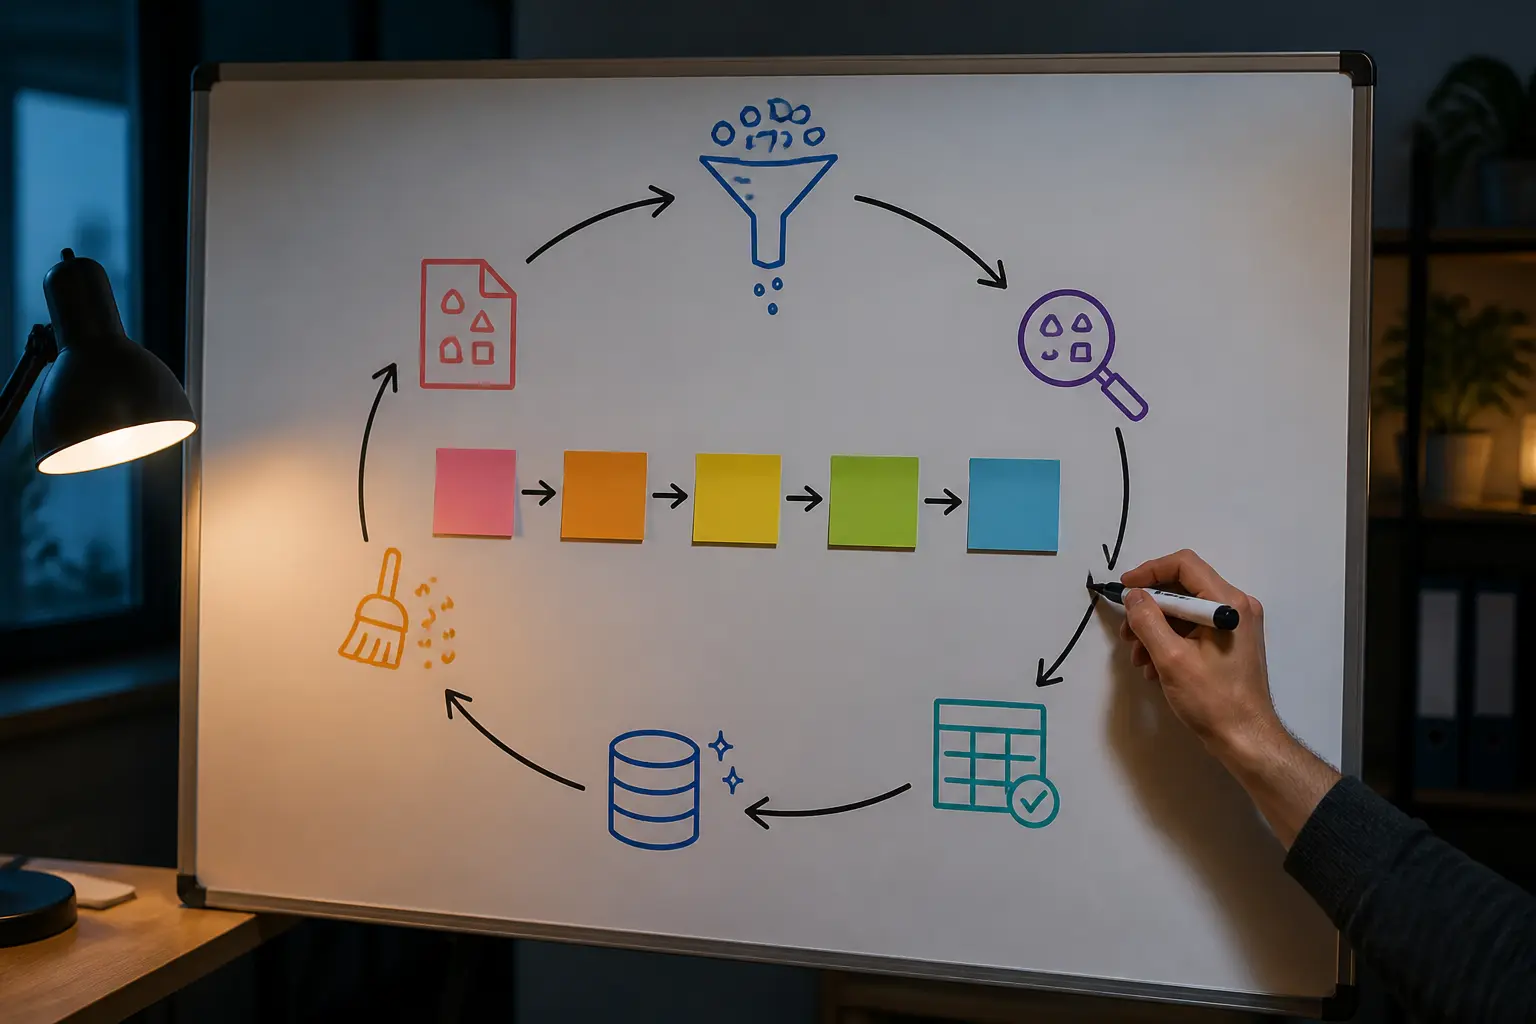
- Профілювання даних. Перш ніж щось чистити, треба зрозуміти, що перед вами: скільки рядків і колонок, які типи даних, скільки пропусків у кожному полі, які мінімальні й максимальні значення, скільки унікальних варіантів у категоріях. Профілювання — це діагностика, яка показує, де саме сидить бруд.
- Видалення або об’єднання дублікатів. Спочатку точні збіги, потім — нечіткі: за нормалізованими іменами, телефонами, адресами. Важливо перед видаленням визначити, який запис вважати головним, щоб не втратити інформацію з решти.
- Робота з пропусками. Для кожного поля обирається стратегія: видалити рядки (якщо пропусків небагато і вони випадкові), заповнити типовим значенням (середнє, медіана, мода), поставити маркер «невідомо» або скласти правило відновлення з інших полів. Універсальної відповіді немає — рішення залежить від природи пропусків.
- Нормалізація форматів. Приведення дат до єдиного стандарту, телефонів — до міжнародного вигляду, текстових категорій — до контрольованого словника, чисел — до однієї одиниці виміру та валюти.
- Пошук і обробка аномалій. Перевірки діапазонів (вік від 0 до 120), логічні правила (дата доставки не раніше дати замовлення), статистичні методи для викидів. Аномалію не завжди видаляють: іноді це справжнє, хоч і рідкісне значення, іноді — сигнал про помилку в джерелі.
- Валідація та документація. Фінальна перевірка: чи зійшлися контрольні суми, чи не зникло забагато рядків, чи логічні зв’язки між полями збережені. Усі виконані перетворення фіксують, щоб процес можна було повторити й пояснити колегам.
Ключовий принцип цієї методології — очищення має бути відтворюваним. Якщо ви вручну правите клітинки в Excel без жодного запису, через місяць ніхто, включно з вами, не зрозуміє, що саме було зроблено і чому. Тому професійні команди оформлюють очищення як код або як налаштований конвеєр із журналом змін.
Data cleaning на практиці: два приклади
Розглянемо, як працює очищення на двох реалістичних сценаріях.
Приклад перший: база email-підписників. Маркетолог експортує 50 000 контактів із трьох систем: сайту, CRM і старого розсилального сервісу. Після зведення виявляється: 8% адрес продубльовані з різним регістром літер, у 3% адрес немає символу «@» або є зайві пробіли, частина імен записана як «іван», «ІВАН» і «Ivan», а поле «місто» містить 47 варіантів написання одного обласного центру. Очищення: привести email до нижнього регістру й прибрати пробіли, перевірити формат адрес регулярним виразом, видалити дублікати зі збереженням найсвіжішої дати підписки, зіставити варіанти міст з довідником. Після цього реальна кількість унікальних підписників виявляється на 11% меншою за початкову — і всі метрики розсилок перераховуються.
Приклад другий: звіт з продажів для рейтингу регіонів. Аналітик збирає дані з касових систем, щоб побудувати рейтинги міст за виручкою та інфографіку для керівництва. У вигрузці: суми частково в гривнях, частково в євро (одна з систем експортує по-іншому); повернення товарів записані від’ємними сумами і впереміш з продажами; у 5% рядків не заповнене поле регіону, але заповнена адреса точки. Без очищення рейтинг виглядає абсурдно: одне місто «лидирує» через суму в євро, сприйняту як гривні. Методологія: нормалізувати валюту за курсом на дату операції, відокремити повернення в окремий показник, відновити регіон з довідника адрес, перепровірити контрольні суми з бухгалтерією. Лише після цього рейтинг і візуалізація отримують право на існування.
Зверніть увагу: в обох прикладах очищення змінило висновки. Це і є головна практична цінність data cleaning — не естетика таблиць, а коректність рішень.
Інструменти: чим очищають дані
Вибір інструмента залежить від обсягу даних, навичок команди та вимог до відтворюваності.
- Електронні таблиці (Excel, Google Таблиці). Підходять для малих наборів і разових задач: пошук дублікатів, фільтри, формули TRIM, PROPER, функції заміни, зведені таблиці для профілювання. Обмеження очевидні: ручні правки складно відтворити, а великі обсяги таблиці не тягнуть.
- OpenRefine. Безкоштовний інструмент, створений саме для очищення: кластеризація схожих значень («Kyiv», «kyiv», «Kiev» зливаються в один), масові перетворення, історія всіх операцій. Добрий вибір для тих, хто не програмує.
- SQL. Коли дані вже в базі, значну частину очищення роблять запитами: пошук дублікатів через GROUP BY, нормалізація регістру, перевірки діапазонів, видалення тестових записів.
- Python (pandas) і R. Стандарт для серйозної роботи: очищення описується кодом, який можна перевірити, повторити й застосувати до нових даних. Типові операції — drop_duplicates, fillna, astype, регулярні вирази, z-score для викидів.
- ETL- та data quality-платформи. У корпоративному середовищі правила очищення вбудовують у конвеєри (Talend, dbt, Great Expectations для автоматичних перевірок якості), щоб бруд відсіювався ще до потрапляння в аналітичну базу.
Починати вчитися варто з таблиць і OpenRefine — вони дають відчуття типових проблем. Але як тільки задачі стають регулярними, перехід на код (Python + pandas) стає питанням часу: ручне очищення не масштабується.
Data cleaning і якість аналітики: рейтинги та інфографіка
Зв’язок між очищенням і візуалізацією недооцінюють. Рейтинги та інфографіка — це фасад, за яким стоїть методологія даних. Якщо під візуалізацією лежать неочищені дані, гарна картинка лише переконливіше бреше.
Типові спотворення, які виправляє очищення перед візуалізацією: зірвані вершини графіків через викиди (один запис у мільйон «стискає» решту стовпчиків), подвоєні категорії в легенді («Україна» і «Украина» як дві країни), провали на часовій осі через змішані формати дат, неправильні частки в кругових діаграмах через пропуски, які потрапили в знаменник. Окрема історія — карти: без нормалізації назв населених пунктів частина даних просто не прив’яжеться до географії.
Тому дисциплінована команда перед публікацією будь-якого рейтингу проходить короткий чеклист: джерело та дата вигрузки відомі, дублікати видалені, одиниці виміру єдині, пропуски оброблені за задокументованим правилом, викиди перевірені оком, контрольні суми збігаються з первинним джерелом. Це займає години, але рятує від ситуації, коли опубліковану інфографіку доводиться виправляти з вибаченнями.
Типові помилки під час очищення даних
- Чистити «на око» без профілювання. Не знаючи масштабу проблеми, легко витратити день на дрібниці й пропустити головне.
- Видаляти всі рядки з пропусками. Якщо пропуски не випадкові (наприклад, поле не заповнюють певні категорії клієнтів), видалення зміщує вибірку й спотворює висновки.
- Мовчки викидаю аномалії. Викид може бути помилкою, а може бути найважливішим фактом у всьому наборі — шахською транзакцією, рекордним замовленням, збоєм обладнання.
- Не зберігати сиру копію. Очищення без можливості відкотитися — це операція без страховки. Оригінал даних має лишатися недоторканим.
- Не документувати правила. Через квартал ніхто не пояснить, чому частина рядків зникла, і довіра до звітів буде підірвана.
- Очікувати, що очищення — разова подія. Дані продовжують надходити, і без автоматизованих перевірок бруд повертається з кожною новою вигрузкою.
Короткий чекліст перед аналізом
Якщо потрібно швидко оцінити, чи готовий набір даних до роботи, пройдіться п’ятьма питаннями. Чи немає в таблиці дубльованих рядків і сутностей? Чи всі дати, числа, валюти й категорії записані в одному форматі? Чи зрозуміло, що означає кожен пропуск, і чи задокументовано, як його обробили? Чи перевірені значення, які виходять за межі здорового глузду? Чи зберігся недоторканий оригінал і опис усіх перетворень? П’ять відповідей «так» — мінімальна ознака того, що дані можна аналізувати, рахувати за ними рейтинги й будувати візуалізації без ризику отримати гарно оформлену помилку.
Часті запитання про data cleaning
Чим data cleaning відрізняється від data preprocessing?
Data preprocessing — ширше поняття: окрім очищення воно включає перетворення для конкретної задачі (масштабування ознак, кодування категорій, розбиття на вибірки для машинного навчання). Очищення — це фундамент, перший і обов’язковий шар preprocessing.
Скільки часу має займати очищення?
Жорсткої норми немає, але якщо очищення займає менше ніж третину часу проєкту, варто запитати себе, чи не пропущено якісь перевірки. У задачах із кількома джерелами і «живими» даними половина загального бюджету часу — нормальна практика.
Чи можна повністю автоматизувати data cleaning?
Рутинні перевірки — так, і їх варто автоматизувати: формати, діапазони, дублікати, контрольні суми. Але рішення про нестандартні випадки (видаляти чи лишати аномалію, як заповнити специфічний пропуск) вимагають розуміння бізнес-контексту, і тому лишаються за людиною.
Що робити, якщо даних із пропусками забагато?
Спочатку з’ясуйте причину: можливо, поле з’явилося нещодавно або не заповнюється для певного сегмента. Якщо пропуски систематичні, корисніше додати категорію «невідомо» або проаналізувати цей сегмент окремо, ніж масово видаляти рядки чи механічно підставляти середнє.