Представьте таблицу с заказами интернет-магазина: в половине строк город записан как «Київ», в трети — «Kyiv», где-то — «киев» маленькой буквой, а в нескольких строках города вообще нет. Даты записаны в трёх разных форматах, цены местами стоят в гривнах, местами в долларах, а один и тот же клиент фигурирует под четырьмя вариантами имени. Пока эту таблицу не привести в порядок, ни один отчёт, ни один рейтинг товаров и ни одна инфографика не будут правдивыми. Именно эту работу и называют data cleaning.
- Что такое data cleaning простыми словами
- Почему очистка данных занимает большую часть работы аналитика
- Какие проблемы скрываются в сырых данных
- Дубликаты
- Пропущенные значения
- Неконсистентные форматы
- Ошибки ввода и аномалии
- Неактуальные и противоречивые данные
- Как работает процесс очистки: методология данных шаг за шагом
- Data cleaning на практике: два примера
- Инструменты: чем очищают данные
- Data cleaning и качество аналитики: рейтинги и инфографика
- Типичные ошибки при очистке данных
- Короткий чек-лист перед анализом
- Частые вопросы о data cleaning
- Чем data cleaning отличается от data preprocessing?
- Сколько времени должна занимать очистка?
- Можно ли полностью автоматизировать data cleaning?
- Что делать, если данных с пропусками слишком много?
Что такое data cleaning простыми словами
Data cleaning (очистка данных) — это процесс выявления и исправления ошибок, неточностей и противоречий в наборе данных, чтобы сделать его пригодным для анализа, отчётности или обучения моделей. Термин простыми словами означает «уборка в таблице»: удалить дубликаты, заполнить пропуски, унифицировать форматы, исправить очевидные ошибки и убрать значения, которых не может быть в реальности.
Значение этого понятия лучше всего раскрывается через аналогию с кухней. Повар не начинает готовить, пока не помоет овощи, не выбросит испорченные продукты и не нарежет ингредиенты одинаковыми кусками. Аналитик данных делает то же самое: сырые данные — это ингредиенты, а очистка — обязательная подготовка. Если пропустить этот этап, блюдо получится невкусным независимо от того, насколько умел повар. В мире данных это правило известно как garbage in, garbage out: какой мусор на входе — такой мусор на выходе.
Data cleaning часто путают со смежными понятиями. Data wrangling (или data munging) — более широкий процесс, который кроме очистки включает преобразование структуры данных, объединение источников и обогащение. ETL (extract, transform, load) — инженерный конвейер, где очистка является лишь частью шага transform. То есть data cleaning — это не отдельная профессия и не разовая акция, а обязательный этап любой работы с данными.
Почему очистка данных занимает большую часть работы аналитика
В профессиональной среде сложилось наблюдение, что на подготовку и очистку данных аналитики и дата-сайентисты тратят от половины до 80% рабочего времени, тогда как сам анализ и построение визуализаций — остальное. Точные цифры зависят от отрасли и качества источников, но порядок величины стабилен: очистка — самый трудоёмкий этап.
Причина проста: реальные данные рождаются в хаосе. Их вводят люди, которые ошибаются и спешат. Их генерируют системы с разными настройками. Их передают между отделами через экспорт в Excel, где форматы «плывут». Их накапливают годами, и за это время меняются названия полей, единицы измерения и бизнес-правила. Каждый из этих факторов добавляет слой грязи, который нужно счищать перед тем, как считать рейтинги, строить инфографику или обучать модель.
Ещё один важный факт: ошибка, заложенная на этапе очистки, не исчезает дальше по цепочке — она умножается. Если вы не заметили, что часть продаж записана в другой валюте, то средний чек, прогноз выручки и рейтинг регионов будут ошибочными, а решения, принятые на их основе, — вредными. Именно поэтому опытные аналитики относятся к очистке не как к скучной рутине, а как к самой ответственной части работы.
Какие проблемы скрываются в сырых данных
Чтобы data cleaning перестал быть абстракцией, стоит разобрать типичные категории грязи. На практике они встречаются почти всегда в комбинации.
Дубликаты
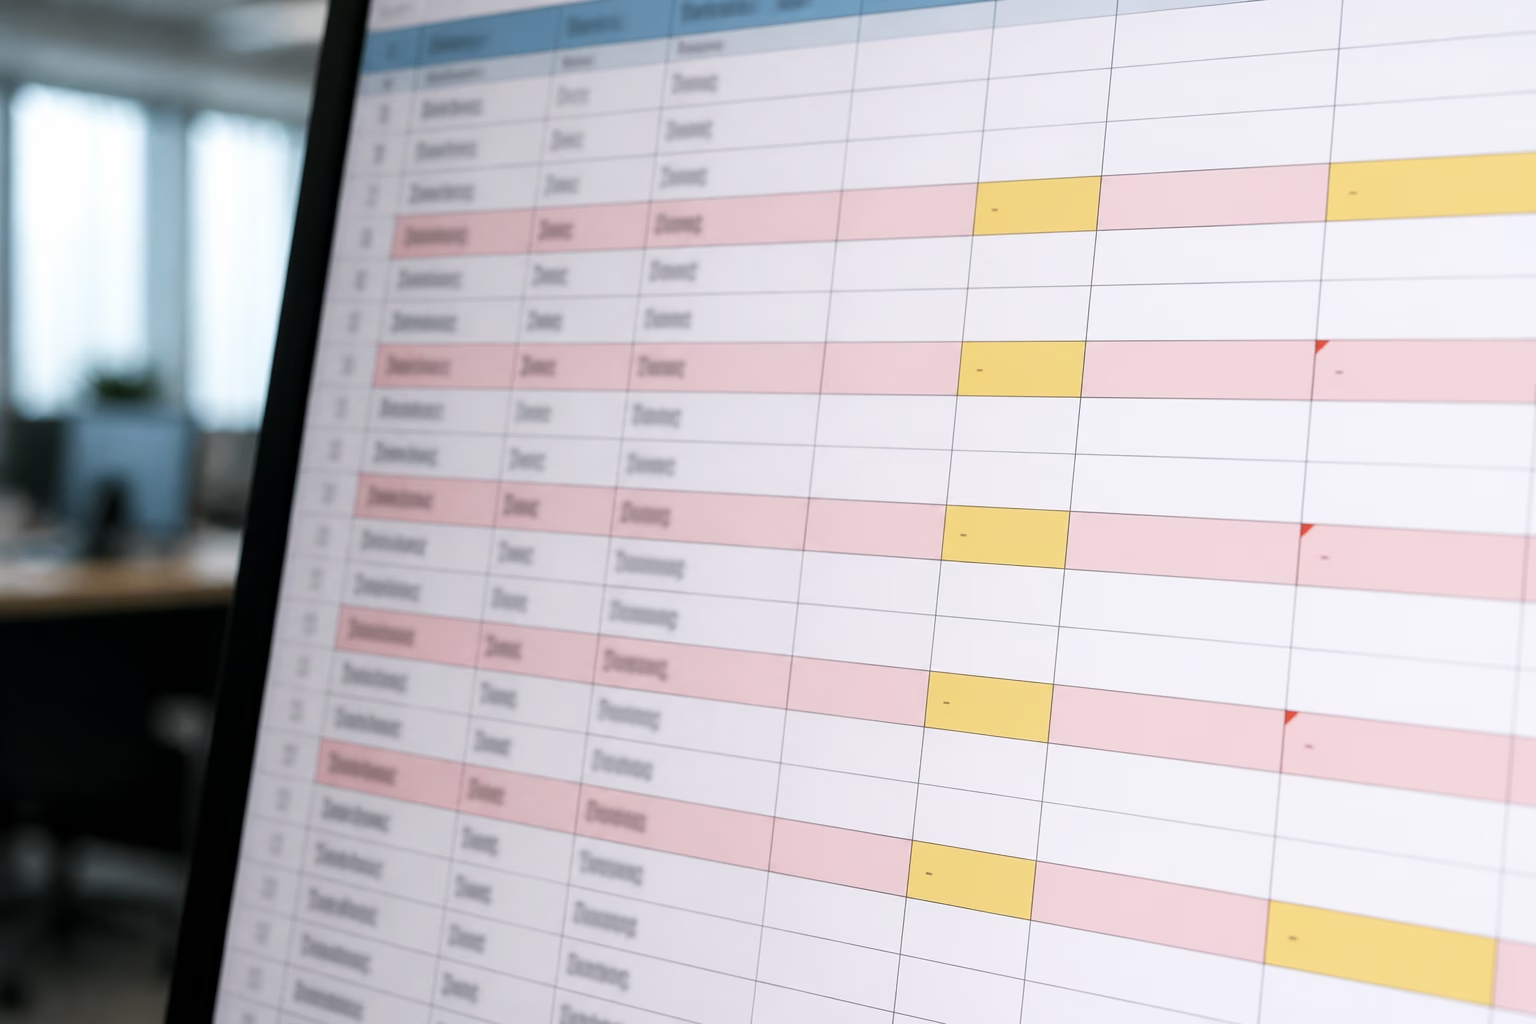
Одна и та же запись встречается несколько раз. Классический пример — клиент, который зарегистрировался дважды с разных email-адресов, или транзакция, продублировавшаяся из-за сбоя при импорте. Дубликаты искажают итоги: количество клиентов, объём продаж, средние значения. Сложность в том, что дубликаты бывают не только точными, но и нечёткими — «Олександр Шевченко» и «О. Шевченко» с одинаковым адресом доставки, вероятно, один человек, но простое сравнение строк этого не увидит.
Пропущенные значения
Пустые ячейки, нули вместо реальных нулей, «N/A», «—» и «неизвестно» — всё это разные лица одной проблемы. Важно различать, почему значение пропущено: поле не было обязательным, система не собрала данные, или сам факт не произошёл. От этого зависит стратегия: заполнять пропуск средним, удалять строку или оставлять как отдельную категорию.
Неконсистентные форматы
Даты в форматах «01.02.2024», «2024-02-01» и «Feb 1, 2024» выглядят одинаково для человека, но для программы это три разных значения. То же с телефонами («+380…», «380…», «068…»), валютами, единицами измерения и регистром букв. Без нормализации группировка и подсчёты дают бессмысленные результаты: «Київ» и «KYIV» попадут в разные строки отчёта.
Ошибки ввода и аномалии
Возраст клиента 214 лет, отрицательное количество товара, дата рождения в будущем, цена с двумя лишними нулями. Такие выбросы возникают из-за опечаток, сбоев датчиков или ошибочных единиц измерения. Часть выявляется простыми проверками диапазона, часть — только статистическим анализом распределения.
Неактуальные и противоречивые данные
Клиент переехал, а старый адрес остался. В двух системах для одного заказа разные статусы. Название компании изменилось после ребрендинга. Такие проблемы труднее всего выявить автоматически, потому что каждое значение по отдельности выглядит корректным — противоречие видно только в сравнении или в контексте времени.
Как работает процесс очистки: методология данных шаг за шагом
Data cleaning — не хаотичное исправление ошибок, а повторяемая методология. Условно её можно представить как цикл из шести шагов.
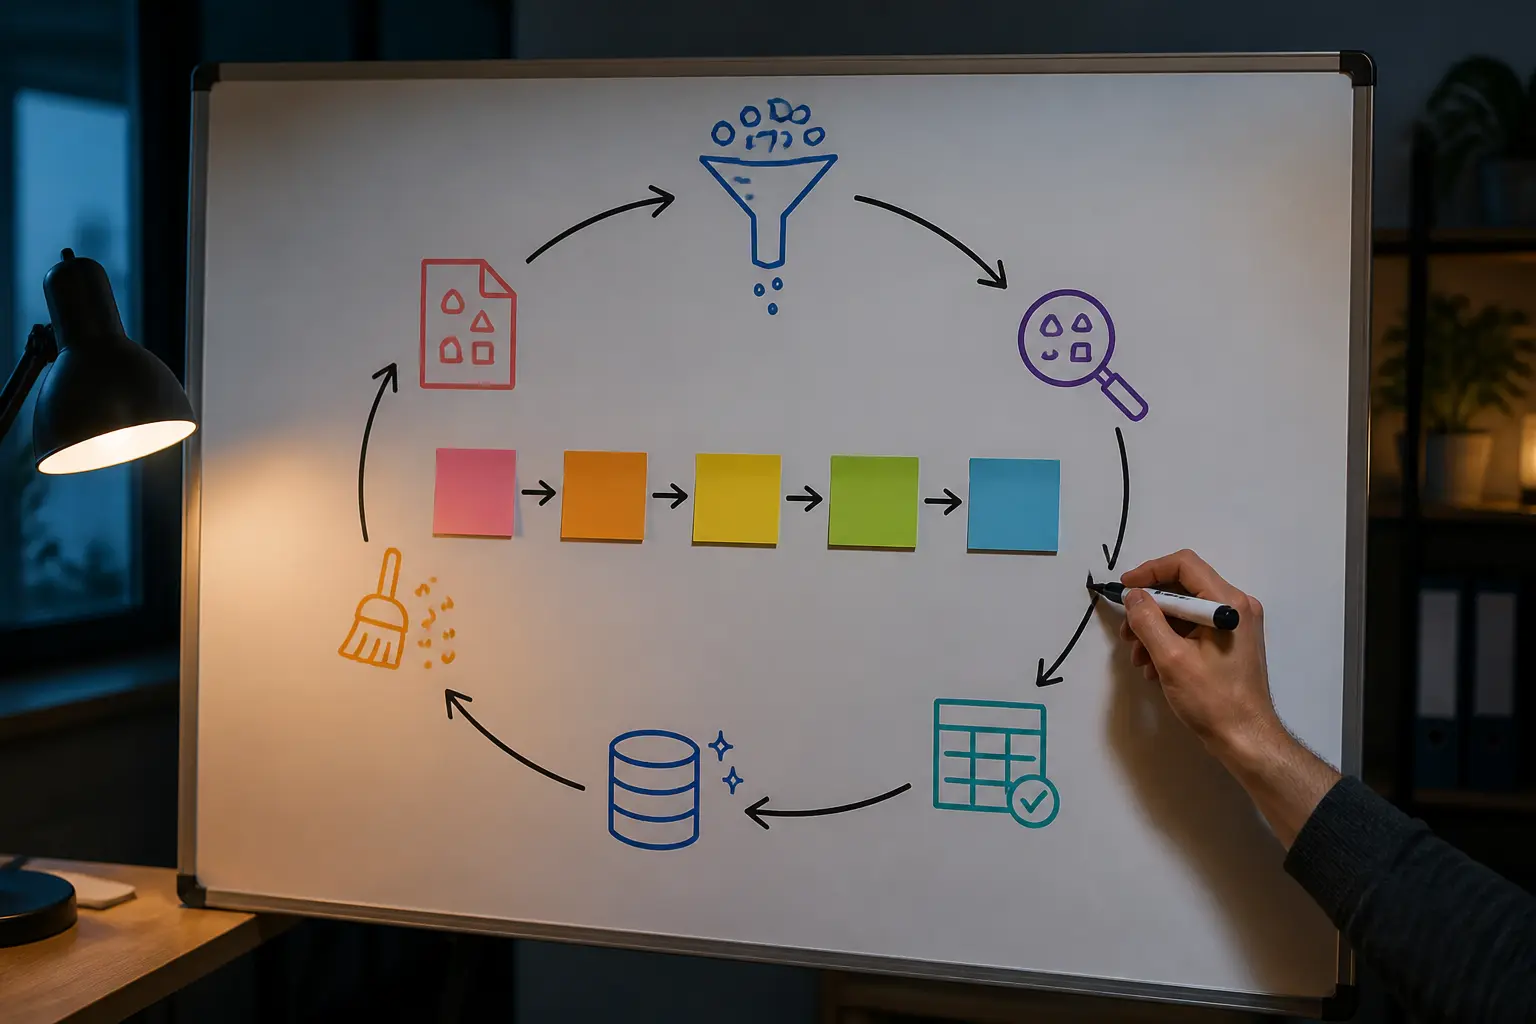
- Профилирование данных. Прежде чем что-то чистить, нужно понять, что перед вами: сколько строк и колонок, какие типы данных, сколько пропусков в каждом поле, какие минимальные и максимальные значения, сколько уникальных вариантов в категориях. Профилирование — это диагностика, которая показывает, где именно сидит грязь.
- Удаление или объединение дубликатов. Сначала точные совпадения, затем — нечёткие: по нормализованным именам, телефонам, адресам. Важно перед удалением определить, какую запись считать главной, чтобы не потерять информацию из остальных.
- Работа с пропусками. Для каждого поля выбирается стратегия: удалить строки (если пропусков немного и они случайны), заполнить типичным значением (среднее, медиана, мода), поставить маркер «неизвестно» или составить правило восстановления из других полей. Универсального ответа нет — решение зависит от природы пропусков.
- Нормализация форматов. Приведение дат к единому стандарту, телефонов — к международному виду, текстовых категорий — к контролируемому словарю, чисел — к одной единице измерения и валюте.
- Поиск и обработка аномалий. Проверки диапазонов (возраст от 0 до 120), логические правила (дата доставки не раньше даты заказа), статистические методы для выбросов. Аномалию не всегда удаляют: иногда это настоящее, хоть и редкое значение, иногда — сигнал об ошибке в источнике.
- Валидация и документация. Финальная проверка: сошлись ли контрольные суммы, не исчезло ли слишком много строк, сохранены ли логические связи между полями. Все выполненные преобразования фиксируют, чтобы процесс можно было повторить и объяснить коллегам.
Ключевой принцип этой методологии — очистка должна быть воспроизводимой. Если вы вручную правите ячейки в Excel без какой-либо записи, через месяц никто, включая вас, не поймёт, что именно было сделано и почему. Поэтому профессиональные команды оформляют очистку как код или как настроенный конвейер с журналом изменений.
Data cleaning на практике: два примера
Рассмотрим, как работает очистка на двух реалистичных сценариях.
Пример первый: база email-подписчиков. Маркетолог экспортирует 50 000 контактов из трёх систем: сайта, CRM и старого рассылочного сервиса. После сведения выясняется: 8% адресов продублированы с разным регистром букв, в 3% адресов нет символа «@» или есть лишние пробелы, часть имён записана как «іван», «ІВАН» и «Ivan», а поле «город» содержит 47 вариантов написания одного областного центра. Очистка: привести email к нижнему регистру и убрать пробелы, проверить формат адресов регулярным выражением, удалить дубликаты с сохранением самой свежей даты подписки, сопоставить варианты городов со справочником. После этого реальное количество уникальных подписчиков оказывается на 11% меньше исходного — и все метрики рассылок пересчитываются.
Пример второй: отчёт по продажам для рейтинга регионов. Аналитик собирает данные из кассовых систем, чтобы построить рейтинги городов по выручке и инфографику для руководства. В выгрузке: суммы частично в гривнах, частично в евро (одна из систем экспортирует по-другому); возвраты товаров записаны отрицательными суммами и вперемешку с продажами; в 5% строк не заполнено поле региона, но заполнен адрес точки. Без очистки рейтинг выглядит абсурдно: один город «лидирует» из-за суммы в евро, воспринятой как гривны. Методология: нормализовать валюту по курсу на дату операции, отделить возвраты в отдельный показатель, восстановить регион из справочника адресов, перепроверить контрольные суммы с бухгалтерией. Только после этого рейтинг и визуализация получают право на существование.
Обратите внимание: в обоих примерах очистка изменила выводы. Это и есть главная практическая ценность data cleaning — не эстетика таблиц, а корректность решений.
Инструменты: чем очищают данные
Выбор инструмента зависит от объёма данных, навыков команды и требований к воспроизводимости.
- Электронные таблицы (Excel, Google Таблицы). Подходят для малых наборов и разовых задач: поиск дубликатов, фильтры, формулы TRIM, PROPER, функции замены, сводные таблицы для профилирования. Ограничения очевидны: ручные правки сложно воспроизвести, а большие объёмы таблицы не выдерживают.
- OpenRefine. Бесплатный инструмент, созданный именно для очистки: кластеризация похожих значений («Kyiv», «kyiv», «Kiev» сливаются в один), массовые преобразования, история всех операций. Хороший выбор для тех, кто не программирует.
- SQL. Когда данные уже в базе, значительную часть очистки делают запросами: поиск дубликатов через GROUP BY, нормализация регистра, проверки диапазонов, удаление тестовых записей.
- Python (pandas) и R. Стандарт для серьёзной работы: очистка описывается кодом, который можно проверить, повторить и применить к новым данным. Типичные операции — drop_duplicates, fillna, astype, регулярные выражения, z-score для выбросов.
- ETL- и data quality-платформы. В корпоративной среде правила очистки встраивают в конвейеры (Talend, dbt, Great Expectations для автоматических проверок качества), чтобы грязь отсеивалась ещё до попадания в аналитическую базу.
Начинать учиться стоит с таблиц и OpenRefine — они дают ощущение типичных проблем. Но как только задачи становятся регулярными, переход на код (Python + pandas) становится вопросом времени: ручная очистка не масштабируется.
Data cleaning и качество аналитики: рейтинги и инфографика
Связь между очисткой и визуализацией недооценивают. Рейтинги и инфографика — это фасад, за которым стоит методология данных. Если под визуализацией лежат неочищенные данные, красивая картинка лишь убедительнее лжёт.
Типичные искажения, которые исправляет очистка перед визуализацией: сорванные вершины графиков из-за выбросов (одна запись в миллион «сжимает» остальные столбики), удвоенные категории в легенде («Україна» и «Украина» как две страны), провалы на временной оси из-за смешанных форматов дат, неправильные доли в круговых диаграммах из-за пропусков, попавших в знаменатель. Отдельная история — карты: без нормализации названий населённых пунктов часть данных просто не привяжется к географии.
Поэтому дисциплинированная команда перед публикацией любого рейтинга проходит короткий чек-лист: источник и дата выгрузки известны, дубликаты удалены, единицы измерения едины, пропуски обработаны по задокументированному правилу, выбросы проверены глазом, контрольные суммы совпадают с первичным источником. Это занимает часы, но спасает от ситуации, когда опубликованную инфографику приходится исправлять с извинениями.
Типичные ошибки при очистке данных
- Чистить «на глаз» без профилирования. Не зная масштаба проблемы, легко потратить день на мелочи и пропустить главное.
- Удалять все строки с пропусками. Если пропуски не случайны (например, поле не заполняют определённые категории клиентов), удаление смещает выборку и искажает выводы.
- Молча выбрасывать аномалии. Выброс может быть ошибкой, а может быть самым важным фактом во всём наборе — шахской транзакцией, рекордным заказом, сбоем оборудования.
- Не сохранять сырую копию. Очистка без возможности откатиться — это операция без страховки. Оригинал данных должен оставаться нетронутым.
- Не документировать правила. Через квартал никто не объяснит, почему часть строк исчезла, и доверие к отчётам будет подорвано.
- Ожидать, что очистка — разовое событие. Данные продолжают поступать, и без автоматизированных проверок грязь возвращается с каждой новой выгрузкой.
Короткий чек-лист перед анализом
Если нужно быстро оценить, готов ли набор данных к работе, пройдитесь по пяти вопросам. Нет ли в таблице дублированных строк и сущностей? Все ли даты, числа, валюты и категории записаны в одном формате? Понятно ли, что означает каждый пропуск, и задокументировано ли, как его обработали? Проверены ли значения, выходящие за пределы здравого смысла? Сохранился ли нетронутый оригинал и описание всех преобразований? Пять ответов «да» — минимальный признак того, что данные можно анализировать, считать по ним рейтинги и строить визуализации без риска получить красиво оформленную ошибку.
Частые вопросы о data cleaning
Чем data cleaning отличается от data preprocessing?
Data preprocessing — более широкое понятие: кроме очистки оно включает преобразование для конкретной задачи (масштабирование признаков, кодирование категорий, разбиение на выборки для машинного обучения). Очистка — это фундамент, первый и обязательный слой preprocessing.
Сколько времени должна занимать очистка?
Жёсткой нормы нет, но если очистка занимает меньше трети времени проекта, стоит спросить себя, не пропущены ли какие-то проверки. В задачах с несколькими источниками и «живыми» данными половина общего бюджета времени — нормальная практика.
Можно ли полностью автоматизировать data cleaning?
Рутинные проверки — да, и их стоит автоматизировать: форматы, диапазоны, дубликаты, контрольные суммы. Но решения о нестандартных случаях (удалять или оставлять аномалию, как заполнить специфический пропуск) требуют понимания бизнес-контекста, и поэтому остаются за человеком.
Что делать, если данных с пропусками слишком много?
Сначала выясните причину: возможно, поле появилось недавно или не заполняется для определённого сегмента. Если пропуски систематические, полезнее добавить категорию «неизвестно» или проанализировать этот сегмент отдельно, чем массово удалять строки или механически подставлять среднее.