У середині 2000-х комп’ютерний зір мав суттєві обмеження на складних реальних зображеннях. Алгоритми розпізнавали прості геометричні фігури, але на реальних фотографіях плутали кішку з диваном. Більшість дослідників намагалися покращити математичні моделі. А Фей-Фей Лі пішла іншим шляхом: вона вирішила дати комп’ютерам не кращі «мізки», а кращі «очі» — величезну кількість різноманітних прикладів. Так з’явився ImageNet — великий набір даних, що став важливим етапом у розвитку комп’ютерного зору.
- Хто така Фей-Фей Лі: від іммігрантки до керівника AI-досліджень
- Передумови: чому комп’ютерний зір застряг до 2006 року
- ImageNet: як набір із 14 мільйонів зображень змінив правила гри
- Чому саме WordNet і краудсорсинг
- Як ImageNet працює: структура даних і принцип навчання
- ImageNet Large Scale Visual Recognition Challenge (ILSVRC): щорічне змагання, яке прискорило прогрес
- Від AlexNet до сучасних систем: як ImageNet став стандартом індустрії
- Фей-Фей Лі як підприємець: AI-стартапи та роль у розвитку технологій
- Уроки від Фей-Фей Лі: що варто знати підприємцям і розробникам
- Критика та обмеження ImageNet
- Майбутнє комп’ютерного зору після ImageNet
- Часті запитання
- Що таке ImageNet простими словами?
- Як Фей-Фей Лі пов’язана з ImageNet?
- Чому ImageNet вважають проривом?
- Чи використовується ImageNet сьогодні?
- Які компанії заснувала Фей-Фей Лі?
- Практичний висновок: як мислити категорією даних, а не лише алгоритмів
- Перевірені джерела
Хто така Фей-Фей Лі: від іммігрантки до керівника AI-досліджень
Фей-Фей Лі народилася в Пекіні, а в 16 років переїхала з батьками до США. Сім’я не була заможною: перші роки вона підробляла в ресторані, допомагала батькам із прибиранням, але при цьому вступила до Прінстона. Її шлях — це не історія «генія з дитинства», а приклад того, як системна праця й готовність іти проти течії приводять до прориву. Сьогодні вона — професорка Стенфорда, співдиректорка Інституту AI, орієнтованого на людину (HAI), і одна з найвпливовіших постатей у штучному інтелекті.
Передумови: чому комп’ютерний зір застряг до 2006 року
До появи ImageNet типові датасети для тренування моделей містили десятки, максимум сотні зображень у кожній категорії. Алгоритми навчалися на обмеженому матеріалі, тому добре працювали лише в лабораторних умовах. Варто було змінити освітлення, ракурс або показати об’єкт на складному фоні — і точність різко падала. Крім того, більшість даних були закритими або вузькоспеціалізованими, що ускладнювало порівняння результатів між науковими групами. Фей-Фей Лі зрозуміла: проблема не в алгоритмах, а в масштабі та якості навчальних даних.
ImageNet: як набір із 14 мільйонів зображень змінив правила гри
У 2006 році Фей-Фей Лі почала працювати над амбітним проєктом — створити базу зображень, яка охоплювала б усі основні об’єкти реального світу. Для цього вона використала структуру WordNet — великої лексичної бази даних англійської мови, де слова згруповані за значенням. Кожне поняття з WordNet стало окремим класом. Потім дослідники вручну збирали й перевіряли зображення, залучаючи краудсорсинг через Amazon Mechanical Turk. До 2009 року ImageNet містив понад 14 мільйонів зображень у більш ніж 20 000 категорій. Це був безпрецедентний масштаб: попередні набори даних були меншими в тисячі разів.
Чому саме WordNet і краудсорсинг
WordNet дав готову таксономію — від загальних понять до конкретних. Наприклад, «тварина» → «ссавець» → «собака» → «лабрадор». Це дозволило не вигадувати категорії з нуля. А краудсорсинг вирішив проблему масштабування: сотні людей по всьому світу шукали й розмічали зображення за єдиною інструкцією. Важливо, що кожне зображення перевірялося кількома учасниками. Такий підхід забезпечив високу якість даних при величезному обсязі — саме те, чого бракувало комп’ютерному зору.
Як ImageNet працює: структура даних і принцип навчання
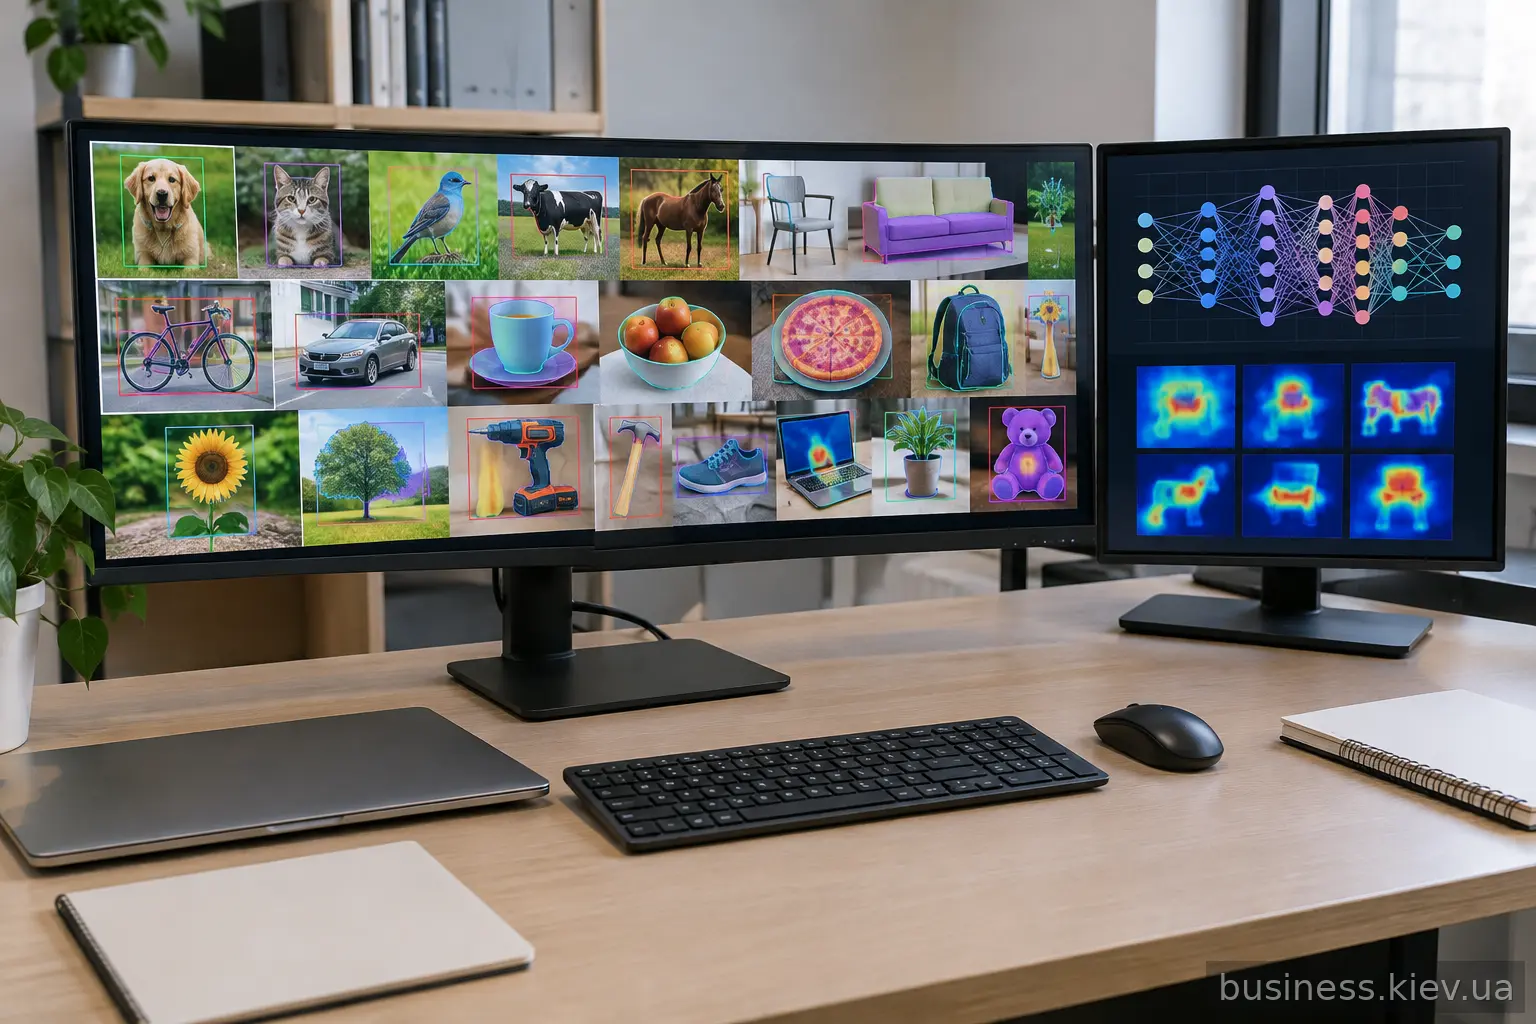
ImageNet організовано за ієрархічним принципом. Зображення пов’язані із синсетами WordNet; формат міток залежить від конкретного завдання та піднабору, що відповідають певному поняттю з WordNet. Наприклад, фотографія золотистого ретривера на пляжі може мати мітки «собака», «ретривер» і «пляж». Така структура дозволяє навчати моделі на різних рівнях абстракції: від загального розпізнавання «тварина» до точного визначення породи. Для тренування використовують згорткові нейронні мережі (CNN), які пошарово виділяють ознаки: спочатку прості (лінії, кути), потім складніші (текстури, частини об’єктів), і нарешті — цілісні об’єкти. ImageNet надав достатньо різноманітних прикладів, щоб такі мережі навчилися працювати в реальних умовах.
ImageNet Large Scale Visual Recognition Challenge (ILSVRC): щорічне змагання, яке прискорило прогрес
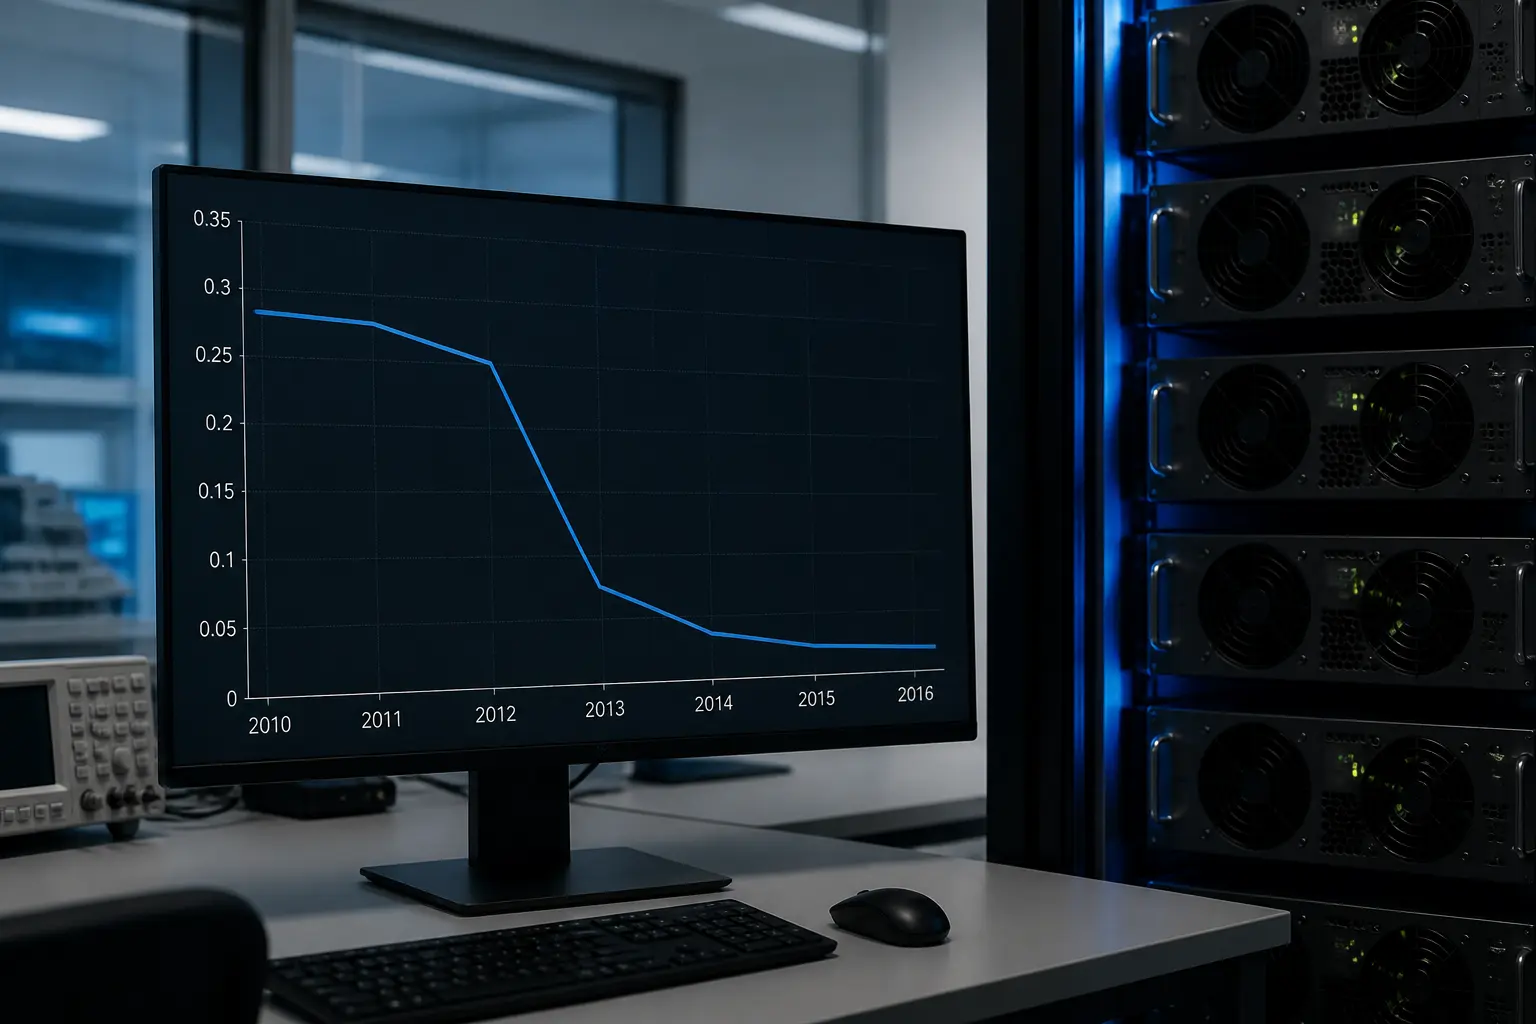
З 2010 року на основі ImageNet почали проводити щорічне змагання ILSVRC. Учасники отримували набір із 1000 категорій і мали створити модель, яка найточніше класифікує зображення. Перші роки перевагу мали класичні методи комп’ютерного зору з ручним конструюванням ознак. Але у 2012 році сталася революція: команда Алекса Крижевського, Іллі Суцкевера та Джеффрі Гінтона представила AlexNet — глибоку згорткову нейронну мережу, яка знизила помилку класифікації майже вдвічі порівняно з попередніми лідерами. Цей результат показав, що глибоке навчання у поєднанні з великими даними здатне вирішувати завдання, які раніше вважалися надто складними. Після 2012 року практично всі учасники перейшли на нейронні мережі, а саме змагання стало каталізатором розвитку сучасного AI.
Від AlexNet до сучасних систем: як ImageNet став стандартом індустрії
Перемога AlexNet довела ефективність підходу «великі дані + глибоке навчання». Після цього ImageNet почали використовувати не лише для змагань, а й як стандартний бенчмарк для перевірки нових архітектур нейромереж. Сьогодні моделі, попередньо натреновані на ImageNet, застосовують у медицині (аналіз знімків), автомобільній промисловості (розпізнавання об’єктів для автопілотів), сільському господарстві (моніторинг стану рослин) та багатьох інших галузях. По суті, ImageNet став «початковою школою» для більшості сучасних систем комп’ютерного зору.
Фей-Фей Лі як підприємець: AI-стартапи та роль у розвитку технологій
Фей-Фей Лі не лише дослідниця, але й активна учасниця індустрії. Вона була головною науковою співробітницею з AI/ML у Google Cloud, де допомагала впроваджувати технології комп’ютерного зору в бізнес-продукти. Крім того, вона співзасновниця AI4ALL — некомерційної організації, яка залучає до AI недостатньо представлені групи. Її підхід до підприємництва вирізняється фокусом на людський аспект технологій: як зробити AI корисним, справедливим і зрозумілим для всіх, а не лише для вузького кола фахівців.
Уроки від Фей-Фей Лі: що варто знати підприємцям і розробникам
Історія Фей-Фей Лі та ImageNet дає кілька важливих уроків для тих, хто працює в AI або будує технологічний бізнес:
- Дані часто важливіші за алгоритми. У 2006 році багато хто вважав, що потрібні нові математичні методи. Фей-Фей Лі зробила ставку на якість і масштаб даних — і це спрацювало.
- Відкритість прискорює прогрес. ImageNet надали дослідницькій спільноті за умовами, що обмежують використання, зокрема некомерційними дослідницькими та освітніми цілями. Це дозволило тисячам дослідників по всьому світу експериментувати й швидко покращувати результати.
- Міждисциплінарність дає перевагу. Ідея використати WordNet прийшла з лінгвістики. Поєднання різних галузей знань допомогло створити унікальний продукт.
- Зосередьтеся на фундаментальній проблемі. Замість того, щоб трохи покращувати існуючі моделі, Фей-Фей Лі вирішила ключову перешкоду — брак даних. Це змінило всю галузь.
Критика та обмеження ImageNet
Попри величезний вплив, ImageNet не позбавлений недоліків. По-перше, датасет збирався переважно з інтернету, тому в ньому присутні культурні та географічні упередження: більшість зображень відображають західний спосіб життя. По-друге, деякі категорії виявилися невдалими: наприклад, клас «людина» включав занадто різноманітні зображення, що ускладнювало навчання. По-третє, виникли етичні питання щодо конфіденційності: деякі фотографії містили обличчя людей без їхньої згоди. У відповідь на це Фей-Фей Лі та її команда працювали над очищенням датасету й видаленням проблемних зображень. Цей досвід підкреслює важливість відповідального підходу до збору даних.
Майбутнє комп’ютерного зору після ImageNet
ImageNet виконав свою місію: він показав, що великі розмічені дані можуть радикально покращити розпізнавання зображень. Сьогодні дослідники рухаються далі — до навчання на менших обсягах даних, використання синтетичних зображень, самонавчання без розмітки. Сама Фей-Фей Лі зараз зосереджена на AI, орієнтованому на людину: системах, які не лише розпізнають об’єкти, але й розуміють контекст, емоції та соціальні норми. Її робота над ImageNet залишається фундаментом, на якому будується сучасний комп’ютерний зір, а її підхід до досліджень — прикладом стратегічного мислення у AI.
Часті запитання
Що таке ImageNet простими словами?
ImageNet — це величезна колекція фотографій, розсортованих за категоріями (наприклад, «кішка», «автомобіль», «квітка»). Її створили, щоб навчати комп’ютери розпізнавати об’єкти на зображеннях так само, як це робить людина.
Як Фей-Фей Лі пов’язана з ImageNet?
Вона ініціювала проєкт, керувала збором і розміткою даних, а також забезпечила його відкритість для наукової спільноти. Саме її наполегливість допомогла подолати скепсис колег на ранніх етапах.
Чому ImageNet вважають проривом?
До ImageNet моделі комп’ютерного зору навчалися на дуже обмежених даних і погано працювали в реальних умовах. ImageNet надав мільйони різноманітних прикладів, що в поєднанні з глибокими нейромережами дало стрибок точності, який відкрив шлях до практичного застосування технології.
Чи використовується ImageNet сьогодні?
Так, хоча й не так активно, як раніше. Зараз це стандартний набір для попереднього навчання моделей, які потім донавчають під конкретні завдання. Також його застосовують як бенчмарк для порівняння нових архітектур нейромереж.
Які компанії заснувала Фей-Фей Лі?
Вона не засновувала комерційні компанії у звичному розумінні, але є співзасновницею некомерційної організації AI4ALL, яка займається освітою в галузі штучного інтелекту. Також вона обіймала керівні посади в Google Cloud, впливаючи на розвиток AI-продуктів.
Практичний висновок: як мислити категорією даних, а не лише алгоритмів
Головний урок від Фей-Фей Лі — не варто недооцінювати силу якісних даних. Якщо ви працюєте над AI-проєктом, поставте собі запитання: чи достатньо у вас різноманітних, чистих і правильно розмічених прикладів? Можливо, саме розширення датасету, а не ускладнення моделі, дасть найбільший приріст якості. І пам’ятайте: відкритість і готовність ділитися результатами часто приносять більше користі, ніж спроби тримати все в секреті.