В середине 2000-х компьютерное зрение имело существенные ограничения на сложных реальных изображениях. Большинство исследователей пытались улучшить математические модели. А Фей-Фей Ли пошла другим путем: она решила дать компьютерам не лучшие «мозги», а лучшие «глаза» — огромное количество разнообразных примеров. Так появился ImageNet — большой набор данных, ставший важным этапом в развитии компьютерного зрения.
- Кто такая Фей-Фей Ли: от иммигрантки до руководителя AI-исследований
- Предпосылки: почему компьютерное зрение застряло до 2006 года
- ImageNet: как набор из 14 миллионов изображений изменил правила игры
- Почему именно WordNet и краудсорсинг
- Как ImageNet работает: структура данных и принцип обучения
- ImageNet Large Scale Visual Recognition Challenge (ILSVRC): ежегодное соревнование, ускорившее прогресс
- От AlexNet к современным системам: как ImageNet стал стандартом индустрии
- Фей-Фей Ли как предприниматель: AI-стартапы и роль в развитии технологий
- Уроки от Фей-Фей Ли: что стоит знать предпринимателям и разработчикам
- Критика и ограничения ImageNet
- Будущее компьютерного зрения после ImageNet
- Частые вопросы
- Что такое ImageNet простыми словами?
- Как Фей-Фей Ли связана с ImageNet?
- Почему ImageNet считают прорывом?
- Используется ли ImageNet сегодня?
- Какие компании основала Фей-Фей Ли?
- Практический вывод: как мыслить категорией данных, а не только алгоритмов
- Проверенные источники
Кто такая Фей-Фей Ли: от иммигрантки до руководителя AI-исследований
Фей-Фей Ли родилась в Пекине, а в 16 лет переехала с родителями в США. Семья не была зажиточной: первые годы она подрабатывала в ресторане, помогала родителям с уборкой, но при этом поступила в Принстон. Ее путь — это не история «гения с детства», а пример того, как системный труд и готовность идти против течения приводят к прорыву. Сегодня она — профессор Стэнфорда, содиректор Института AI, ориентированного на человека (HAI), и одна из самых влиятельных фигур в искусственном интеллекте.
Предпосылки: почему компьютерное зрение застряло до 2006 года
До появления ImageNet типичные датасеты для тренировки моделей содержали десятки, максимум сотни изображений в каждой категории. Алгоритмы обучались на ограниченном материале, поэтому хорошо работали только в лабораторных условиях. Стоило изменить освещение, ракурс или показать объект на сложном фоне — и точность резко падала. Кроме того, большинство данных были закрытыми или узкоспециализированными, что затрудняло сравнение результатов между научными группами. Фей-Фей Ли поняла: проблема не в алгоритмах, а в масштабе и качестве обучающих данных.
ImageNet: как набор из 14 миллионов изображений изменил правила игры
В 2006 году Фей-Фей Ли начала работать над амбициозным проектом — создать базу изображений, которая охватывала бы все основные объекты реального мира. Для этого она использовала структуру WordNet — большой лексической базы данных английского языка, где слова сгруппированы по значению. Каждое понятие из WordNet стало отдельным классом. Затем исследователи вручную собирали и проверяли изображения, привлекая краудсорсинг через Amazon Mechanical Turk. К 2009 году ImageNet содержал более 14 миллионов изображений в более чем 20 000 категорий. Это был беспрецедентный масштаб: предыдущие наборы данных были меньше в тысячи раз.
Почему именно WordNet и краудсорсинг
WordNet дал готовую таксономию — от общих понятий до конкретных. Например, «животное» → «млекопитающее» → «собака» → «лабрадор». Это позволило не выдумывать категории с нуля. А краудсорсинг решил проблему масштабирования: сотни людей по всему миру искали и размечали изображения по единой инструкции. Важно, что каждое изображение проверялось несколькими участниками. Такой подход обеспечил высокое качество данных при огромном объеме — именно то, чего не хватало компьютерному зрению.
Как ImageNet работает: структура данных и принцип обучения
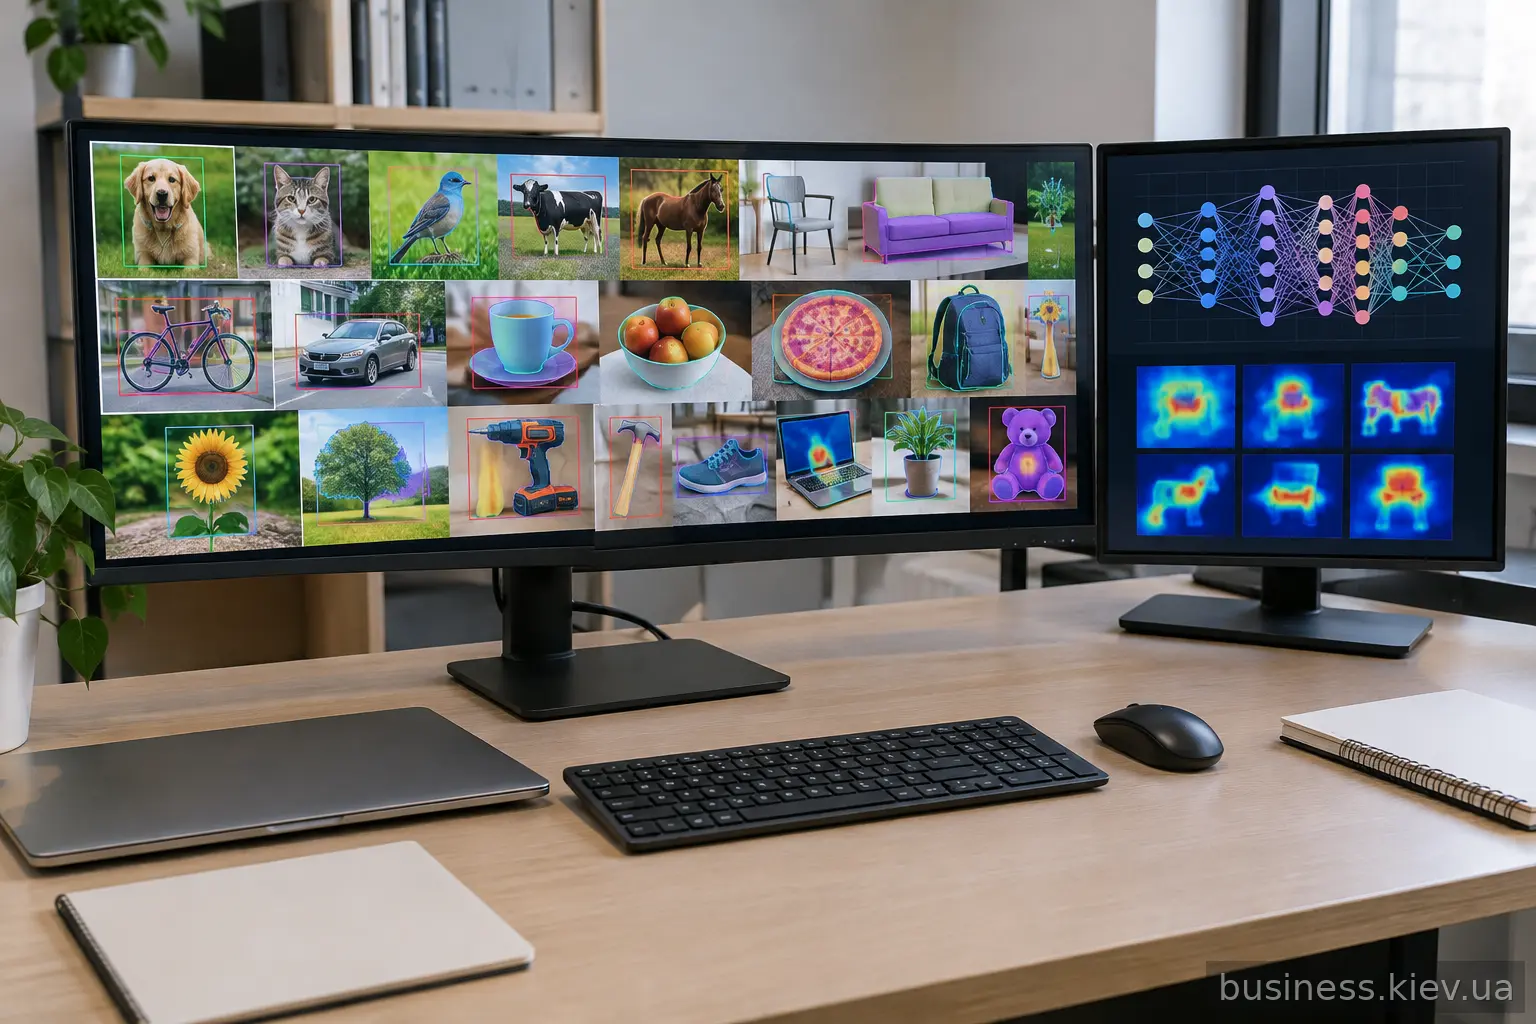
ImageNet организован по иерархическому принципу. Изображения связаны с синсетами WordNet; формат меток зависит от конкретной задачи и поднабора, соответствующих определенному понятию из WordNet. Например, фотография золотистого ретривера на пляже может иметь метки «собака», «ретривер» и «пляж». Такая структура позволяет обучать модели на разных уровнях абстракции: от общего распознавания «животное» до точного определения породы. Для тренировки используют сверточные нейронные сети (CNN), которые послойно выделяют признаки: сначала простые (линии, углы), затем более сложные (текстуры, части объектов), и наконец — целостные объекты. ImageNet предоставил достаточно разнообразных примеров, чтобы такие сети научились работать в реальных условиях.
ImageNet Large Scale Visual Recognition Challenge (ILSVRC): ежегодное соревнование, ускорившее прогресс
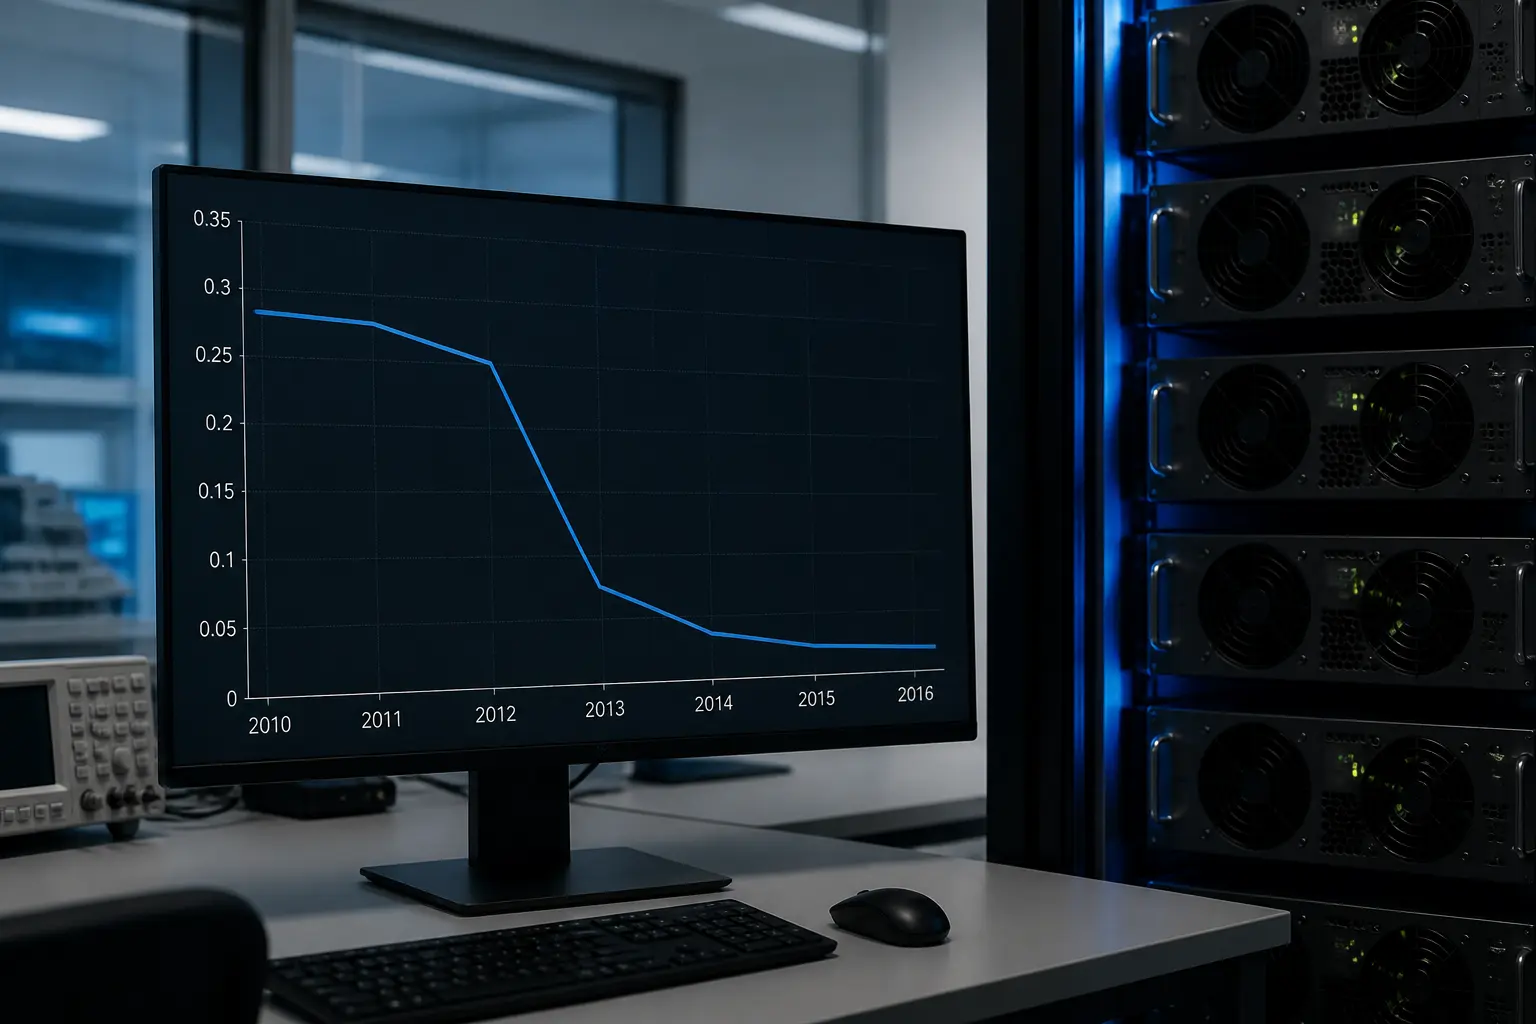
С 2010 года на основе ImageNet начали проводить ежегодное соревнование ILSVRC. Участники получали набор из 1000 категорий и должны были создать модель, которая наиболее точно классифицирует изображения. Первые годы преимущество имели классические методы компьютерного зрения с ручным конструированием признаков. Но в 2012 году произошла революция: команда Алекса Крижевского, Ильи Суцкевера и Джеффри Хинтона представила AlexNet — глубокую сверточную нейронную сеть, которая снизила ошибку классификации почти вдвое по сравнению с предыдущими лидерами. Этот результат показал, что глубокое обучение в сочетании с большими данными способно решать задачи, которые ранее считались слишком сложными. После 2012 года практически все участники перешли на нейронные сети, а само соревнование стало катализатором развития современного AI.
От AlexNet к современным системам: как ImageNet стал стандартом индустрии
Победа AlexNet доказала эффективность подхода «большие данные + глубокое обучение». После этого ImageNet начали использовать не только для соревнований, но и как стандартный бенчмарк для проверки новых архитектур нейросетей. Сегодня модели, предварительно натренированные на ImageNet, применяют в медицине (анализ снимков), автомобильной промышленности (распознавание объектов для автопилотов), сельском хозяйстве (мониторинг состояния растений) и многих других отраслях. По сути, ImageNet стал «начальной школой» для большинства современных систем компьютерного зрения.
Фей-Фей Ли как предприниматель: AI-стартапы и роль в развитии технологий
Фей-Фей Ли не только исследователь, но и активная участница индустрии. Она была главным научным сотрудником по AI/ML в Google Cloud, где помогала внедрять технологии компьютерного зрения в бизнес-продукты. Кроме того, она сооснователь AI4ALL — некоммерческой организации, которая привлекает к AI недостаточно представленные группы. Ее подход к предпринимательству отличается фокусом на человеческий аспект технологий: как сделать AI полезным, справедливым и понятным для всех, а не только для узкого круга специалистов.
Уроки от Фей-Фей Ли: что стоит знать предпринимателям и разработчикам
История Фей-Фей Ли и ImageNet дает несколько важных уроков для тех, кто работает в AI или строит технологический бизнес:
- Данные часто важнее алгоритмов. В 2006 году многие считали, что нужны новые математические методы. Фей-Фей Ли сделала ставку на качество и масштаб данных — и это сработало.
- Открытость ускоряет прогресс. ImageNet предоставили исследовательскому сообществу на условиях, ограничивающих использование, в частности некоммерческими исследовательскими и образовательными целями. Это позволило тысячам исследователей по всему миру экспериментировать и быстро улучшать результаты.
- Междисциплинарность дает преимущество. Идея использовать WordNet пришла из лингвистики. Сочетание разных областей знаний помогло создать уникальный продукт.
- Сосредоточьтесь на фундаментальной проблеме. Вместо того, чтобы немного улучшать существующие модели, Фей-Фей Ли решила ключевое препятствие — нехватку данных. Это изменило всю отрасль.
Критика и ограничения ImageNet
Несмотря на огромное влияние, ImageNet не лишен недостатков. Во-первых, датасет собирался преимущественно из интернета, поэтому в нем присутствуют культурные и географические предубеждения: большинство изображений отражают западный образ жизни. Во-вторых, некоторые категории оказались неудачными: например, класс «человек» включал слишком разнообразные изображения, что затрудняло обучение. В-третьих, возникли этические вопросы относительно конфиденциальности: некоторые фотографии содержали лица людей без их согласия. В ответ на это Фей-Фей Ли и ее команда работали над очисткой датасета и удалением проблемных изображений. Этот опыт подчеркивает важность ответственного подхода к сбору данных.
Будущее компьютерного зрения после ImageNet
ImageNet выполнил свою миссию: он показал, что большие размеченные данные могут радикально улучшить распознавание изображений. Сегодня исследователи движутся дальше — к обучению на меньших объемах данных, использованию синтетических изображений, самообучению без разметки. Сама Фей-Фей Ли сейчас сосредоточена на AI, ориентированном на человека: системах, которые не только распознают объекты, но и понимают контекст, эмоции и социальные нормы. Ее работа над ImageNet остается фундаментом, на котором строится современное компьютерное зрение, а ее подход к исследованиям — примером стратегического мышления в AI.
Частые вопросы
Что такое ImageNet простыми словами?
ImageNet — это огромная коллекция фотографий, рассортированных по категориям (например, «кошка», «автомобиль», «цветок»). Ее создали, чтобы научить компьютеры распознавать объекты на изображениях так же, как это делает человек.
Как Фей-Фей Ли связана с ImageNet?
Она инициировала проект, руководила сбором и разметкой данных, а также обеспечила его открытость для научного сообщества. Именно ее настойчивость помогла преодолеть скепсис коллег на ранних этапах.
Почему ImageNet считают прорывом?
До ImageNet модели компьютерного зрения обучались на очень ограниченных данных и плохо работали в реальных условиях. ImageNet предоставил миллионы разнообразных примеров, что в сочетании с глубокими нейросетями дало скачок точности, открывший путь к практическому применению технологии.
Используется ли ImageNet сегодня?
Да, хотя и не так активно, как раньше. Сейчас это стандартный набор для предварительного обучения моделей, которые затем дообучают под конкретные задачи. Также его применяют как бенчмарк для сравнения новых архитектур нейросетей.
Какие компании основала Фей-Фей Ли?
Фей-Фей Ли является сооснователем некоммерческой организации AI4ALL и компании World Labs, которая работает над пространственным интеллектом. Ранее она была главным научным сотрудником по AI/ML в Google Cloud.
Практический вывод: как мыслить категорией данных, а не только алгоритмов
Главный урок от Фей-Фей Ли — не стоит недооценивать силу качественных данных. Если вы работаете над AI-проектом, задайте себе вопрос: достаточно ли у вас разнообразных, чистых и правильно размеченных примеров? Возможно, именно расширение датасета, а не усложнение модели, даст наибольший прирост качества. И помните: открытость и готовность делиться результатами часто приносят больше пользы, чем попытки держать все в секрете.