Коли ви шукаєте щось у Google, дивитеся відео на YouTube або відкриваєте Gmail, запит за частки секунди обробляють сервери, розкидані по дата-центрах на кількох континентах. У якийсь момент компанія зрозуміла, що ця інфраструктура — самостійний продукт: її можна продавати іншим. Так народився Google Cloud — підрозділ, який сьогодні змагається з Amazon Web Services та Microsoft Azure та пропонує клієнтам інфраструктуру й сервіси для роботи з AI-моделями. Нижче розберемо, як ця система влаштована, чому саме дані й штучний інтелект стали її ядром і на чому хмара заробляє. Ширший контекст цих змін — у темі технології та інновації: хмари, чипи й AI.
Що таке Google Cloud простими словами
Google Cloud — це набір хмарних сервісів: обчислювальні потужності, сховища даних, бази даних, інструменти машинного навчання, мережеві служби та платформи для розробників. Замість того щоб купувати власні сервери й будувати серверну кімнату, компанія орендує потужності у Google й платить за фактичне використання — приблизно як за електроенергію.
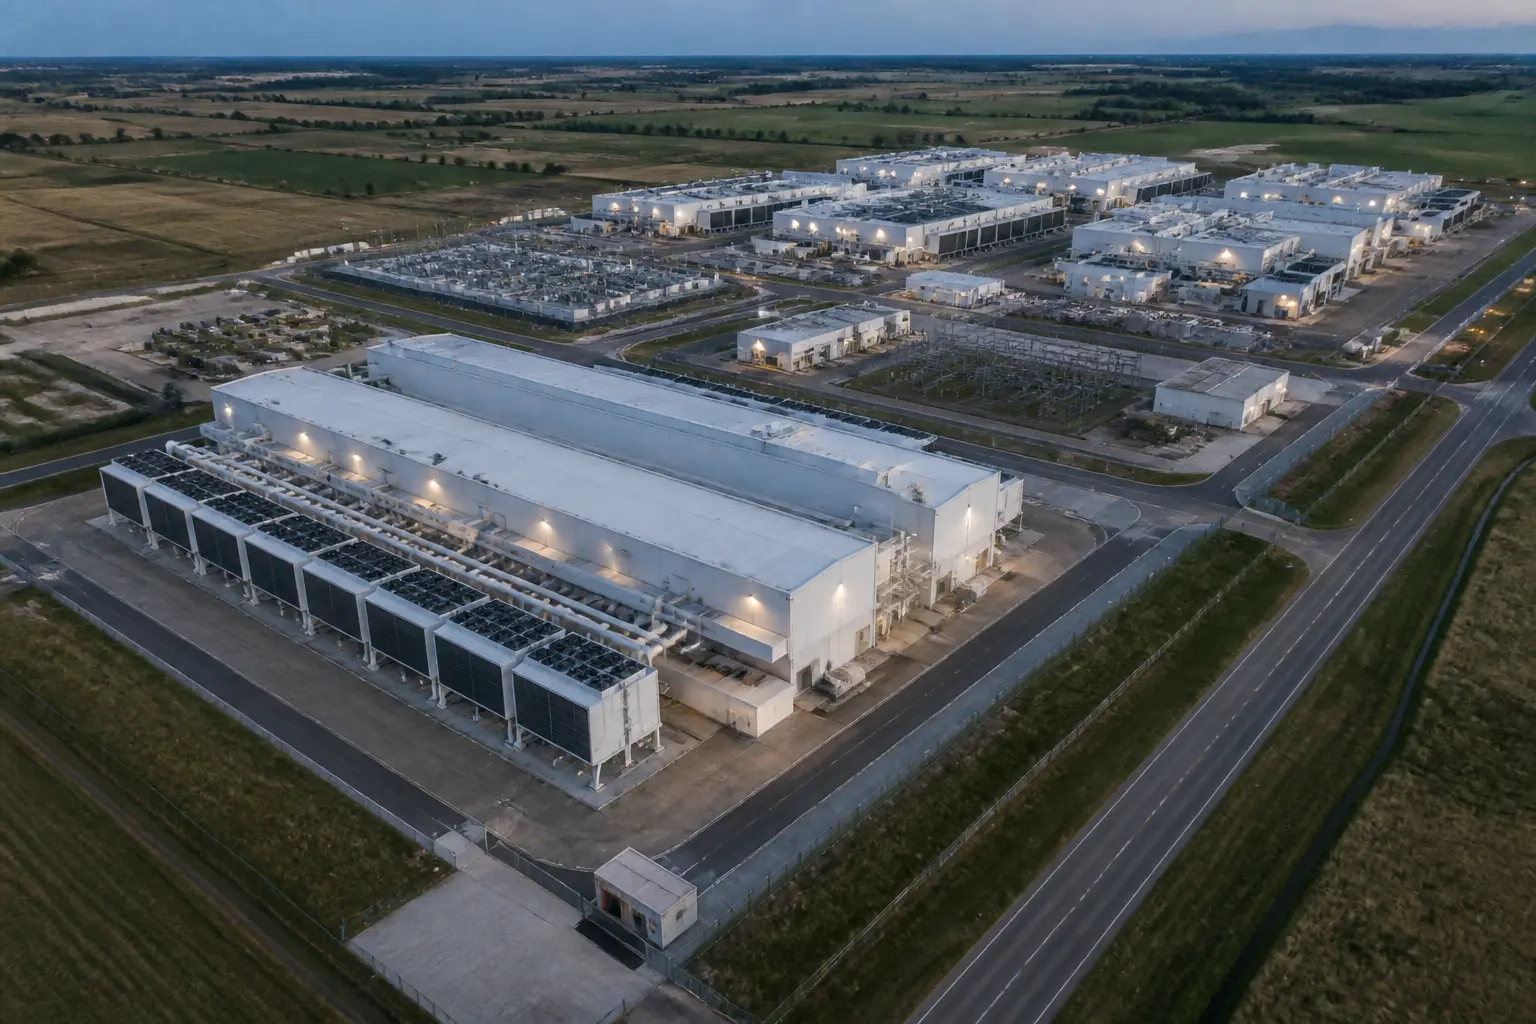
Google Cloud спирається на глобальну мережу й технології, які Google розвивав для власних сервісів, але конкретна архітектура та рівень ізоляції залежать від обраного хмарного продукту. Це десятки дата-центрів, приватна оптоволоконна мережа, що оперта на весь світ, і програмні системи, які Google десятиліттями оптимізував під власні навантаження. Те, що раніше було внутрішнім інструментом, стало зовнішнім продуктом.
Умовно сервіси діляться на кілька шарів. Нижній — інфраструктура як сервіс: віртуальні машини Compute Engine, об’єктне сховище Cloud Storage, мережі. Середній — платформні сервіси: керовані бази даних, середовища для контейнерів, інструменти розробки. Верхній — готові рішення: аналітика BigQuery, платформа машинного навчання Vertex AI, генеративні моделі Gemini. Чим вищий шар, тим менше рутини лишається клієнту і тим більше роботи бере на себе Google.
Історія Google Cloud: від внутрішніх інструментів до окремого бізнесу
Історія компанії у хмарному напрямі почалась задовго до появи самого бренду Google Cloud. Наприкінці 1990-х і на початку 2000-х Google змушений був винаходити власні технології, бо жоден постачальник не міг забезпечити потрібний масштаб. Компанія збирала кластери з дешевих серверів і писала програмне забезпечення, яке перетворювало тисячі машин на єдину обчислювальну систему. Саме тоді з’явилися внутрішні розробки на кшталт файлової системи GFS та моделі обробки даних MapReduce, опис яких Google публікував у наукових статтях — і які потім надихнули відкриті технології великих даних, зокрема Hadoop.
Перший публічний крок у хмару стався у 2008 році з запуском Google App Engine — платформи, де розробники могли розгорнути вебзастосунок, не думаючи про сервери. Це був сміливий, але вузький продукт із жорсткими обмеженнями, і багато компаній тоді обрали гнучкіший підхід Amazon. Наступні роки Google поступово розширював портфоліо: Compute Engine, Cloud Storage, BigQuery, керований Kubernetes (сама технологія Kubernetes — теж внутрішня розробка Google, яку компанія відкрила світові).
Поворотним моментом стало 2015–2016 роки: хмарний бізнес виділили в окремий підрозділ, який очолила Даян Грін, а бренд укрупнили до Google Cloud. З 2019 року компанією керує Томас Куріан, і саме за нього хмара нарешті стала прибутковою — уперше операційний прибуток підрозділ показав у 2023 році. Водночас стався стратегічний поворот до штучного інтелекту: після успіху генеративних моделей Google почав інтегрувати власні AI-розробки в усі хмарні сервіси, і сьогодні AI — головний аргумент, чому клієнти обирають саме цю платформу. Схожий шлях переходу enterprise-клієнтів у хмару пройшла й історія Oracle Cloud та її сервісів.
Як хмара Google працює з даними
Дані — історично сильна сторона Google, адже весь бізнес компанії завжди будувався на їхній обробці. У хмарі це вилилося в два напрями: зберігання та аналітика.
Зберігання охоплює різні типи даних. Об’єктне сховище Cloud Storage підходить для файлів, резервних копій і медіа; керовані реляційні бази Cloud SQL — для класичних транзакційних систем; розподілена база Spanner — для глобальних застосунків, де потрібна узгодженість даних між регіонами. Схема зберігання залежить від сервісу й вибраної локації. Наприклад, Cloud Storage зберігає дані надлишково, а регіональні, dual-region і multi-region конфігурації мають різний рівень географічного резервування; клієнт має підібрати його під потрібні RPO та доступність.
Аналітичним центром платформи є BigQuery — serverless-сховище даних, яке дозволяє виконувати SQL-запити до петабайтів інформації без керування серверами. Користувач надсилає SQL-запит, а керований сервіс сам планує обчислення; час виконання залежить від обсягу даних, структури запиту, резервування ресурсів і завантаження. Оплата йде за обсяг оброблених даних або за зарезервовані потужності. Саме BigQuery часто стає першим сервісом, з якого компанії починають знайомство з платформою, бо він дає змогу аналізувати великі набори даних без самостійного керування серверним кластером.
Довкола цього працюють сервіси потокової обробки (Pub/Sub для подій у реальному часі, Dataflow для конвеєрів даних) та інструменти інтеграції. Типовий ланцюжок виглядає так: сирі дані з застосунків і датчиків надходять через потокові сервіси, очищуються, складаються у BigQuery, а далі над ними будують звіти чи навчають ML-моделі. Сильна сторона Google полягає в тому, що весь цей ланцюжок можна зібрати в межах однієї екосистеми, не склеюючи продукти різних постачальників.
Штучний інтелект як ядро платформи
Google десятиліттями інвестував у дослідження машинного навчання: команда Google створила TensorFlow, а дослідники Google були авторами статті 2017 року, що представила архітектуру Transformer, яка стала основою багатьох сучасних генеративних моделей. У хмарі ці напрацювання перетворилися на комерційні сервіси. Паралельно зростала й історія OpenAI та масовий генеративний AI, що змінило попит на хмарні обчислення.
Центральний продукт тут — Vertex AI, платформа, що закриває повний цикл роботи з моделями: підготовка даних, навчання, розгортання, моніторинг. Через неї доступні і власні моделі Google сімейства Gemini, і відкриті моделі, і навіть моделі партнерів. Компанія може використати готову модель, а для підтримуваних моделей і сценаріїв — налаштувати її або поєднати з власними даними за належних правил доступу та керування даними, після чого вбудувати в застосунок — чат-бот для підтримки, систему пошуку по документах, генератор описів товарів.
Окремий шар — інфраструктура для тих, хто навчає моделі самостійно. Google проєктує власні чипи TPU (Tensor Processing Units), оптимізовані під обчислення нейронних мереж. На них Google тренує свої моделі, і вони ж доступні клієнтам хмари як альтернатива відеокартам. Для великих ML-команд це питання економіки: вартість і швидкість навчання великої моделі прямо залежить від заліза.
Важливо розуміти обмеження. Хмарний AI — це не магія: якість результату залежить від якості даних, вартість генеративних моделей при масштабуванні може зростати непередбачувано, а для чутливих галузей (медицина, фінанси, державний сектор) критичними стають питання, де фізично обробляються дані і хто має до них доступ. Google пропонує регіональне розміщення та шифрування, але безпека працює за моделлю спільної відповідальності: Google захищає хмарну інфраструктуру, а клієнт відповідає за доступи, дані та налаштування у межах обраних сервісів.
Бізнес-модель і місце на ринку
Бізнес-модель Google Cloud класична для галузі: оплата за споживання. Клієнт платить за години роботи віртуальних машин, гігабайти сховища, обсяг оброблених даних, кількість викликів AI-моделей. Для передбачуваних навантажень діють знижки за довгострокові зобов’язання, для стартапів — кредити на старті. Додатково заробляє екосистема навколо: Google Workspace, партнерський маркетплейс, преміальна підтримка.
За оцінками галузевих аналітиків Google Cloud належить до трійки найбільших постачальників хмарної інфраструктури разом з AWS і Microsoft Azure; точна частка залежить від методики та кварталу. При цьому підрозділ — один із найшвидше зростаючих у структурі Alphabet, і саме AI-попит став головним драйвером цього зростання: компанії, які хочуть використовувати моделі Gemini або потужності TPU, логічно розміщують і решту систем у тій самій хмарі.
Стратегічно Google робить ставку на дві речі. Перша — відкритість і мультихмарність: інструменти Google Cloud для гібридних і мультихмарних середовищ дають змогу керувати контейнерними застосунками в Google Cloud та у підтримуваних зовнішніх середовищах. Це аргумент для великих компаній, які бояться прив’язки до одного постачальника. Друга — вертикальна інтеграція AI: Google поєднує власні TPU, моделі й керовані сервіси, водночас підтримуючи обладнання, відкриті моделі та моделі партнерів.
Практичні приклади: хто і для чого використовує Google Cloud
Найзрозуміліше платформа виглядає через реальні сценарії. Ритейл-компанія зливає в BigQuery дані касових терміналів, інтернет-магазину й складу — і прогнозує попит на товари за регіонами, щоб зменшити залишки. Медіа використовують потокову аналітику, щоб у реальному часі бачити, які матеріали читають, і персоналізувати рекомендації. Розробники ігор розгортають сервери в регіонах Google поблизу гравців, а під час релізів автоматично масштабують потужності вгору й назад — і не платять за простій уночі.
Окрема категорія — компанії, що будують власні AI-продукти. Стартап може взяти Gemini через API, додати внутрішню базу знань і за кілька тижнів зібрати помічника для клієнтів, не навчаючи власну модель і не купуючи обладнання. Фінтех використовує ML-сервіси для виявлення шахрайських транзакцій: модель вчиться на історії операцій і позначає підозрілі в момент їх проведення. Відомі клієнти платформи в різні роки — Spotify, Snap, PayPal, роздрібні мережі та телеком-оператори; багато з них обрали Google Cloud саме заради аналітики та обробки даних, а не базової інфраструктури.
Для малого бізнесу поріг входу нижчий, ніж здається: безкоштовні квоти та стартові кредити можуть зменшити вартість тесту, але доступність і умови залежать від сервісу, а платні ресурси здатні створювати витрати відразу. Головний ризик протилежний — без контролю бюджетів і алертів рахунок може зрости непомітно, тож з першого дня варто налаштувати бюджетні сповіщення. Звичайні сповіщення не зупиняють витрати автоматично; окремі spend caps доступні лише для підтримуваних сервісів і мають власні обмеження.
З чого почати знайомство з платформою
Якщо ви хочете оцінити Google Cloud для власної задачі, практична послідовність виглядає так:
- Визначте одну конкретну задачу — аналітика даних, хостинг застосунку або AI-функція. Не намагайтеся переносити в хмару все одночасно.
- Зареєструйте акаунт і активуйте стартові кредити; одразу налаштуйте бюджетні сповіщення.
- Для аналітики почніть із BigQuery: завантажте вибірку даних і виконайте кілька SQL-запитів — це найшвидший спосіб відчути платформу.
- Для застосунків порівняйте Compute Engine, Cloud Run і Kubernetes Engine за критерієм: скільки інфраструктурної рутини ви готові взяти на себе.
- Для AI-задач протестуйте готові моделі через Vertex AI, перш ніж думати про власне навчання — часто варто спочатку перевірити промптинг і пошук по власних даних, а донавчання обирати лише після вимірювання якості та вартості.
- Перед продакшеном перевірте вимоги до регіону зберігання даних і налаштування доступів: перевірте доступи, журнали, резервування та модель спільної відповідальності: помилки конфігурації є окремим ризиком, але причини інцидентів різняться.
Google Cloud — це історія про те, як внутрішня необхідність стала продуктом: інфраструктура, збудована для пошуку та відео, сьогодні обслуговує тисячі компаній, а дані та штучний інтелект перетворилися з внутрішніх компетенцій на головну пропозицію платформи. Розуміння цієї логіки допомагає і технічним командам, які обирають хмару, і тим, хто просто хоче розібратися, як влаштований цифровий світ навколо.