Команда зберігає терабайти логів у дешевому об’єктному сховищі, але для звіту фінансистам дані доводиться щотижня копіювати в окреме сховище даних. Між двома системами з’являються розбіжності, аналітики працюють із застарілими витягами, а інженери тратять час на підтримку конвеєрів копіювання. Саме цю проблему покликана зняти архітектура lakehouse — підхід, який намагається дати одній платформі переваги обох класичних рішень. Без хмарних сервісів і моделей cloud computing така архітектура була б значно дорожчою й менш гнучкою.
Нижче розберемо термін простими словами, подивимося, як lakehouse працює технічно, чим він відрізняється від data lake і data warehouse, і за яких умов його впровадження справді має сенс.
- Що таке lakehouse простими словами
- Звідки взялася проблема: обмеження data lake і data warehouse
- Слабкі місця data lake
- Слабкі місця data warehouse
- Як працює lakehouse: ключові шари архітектури
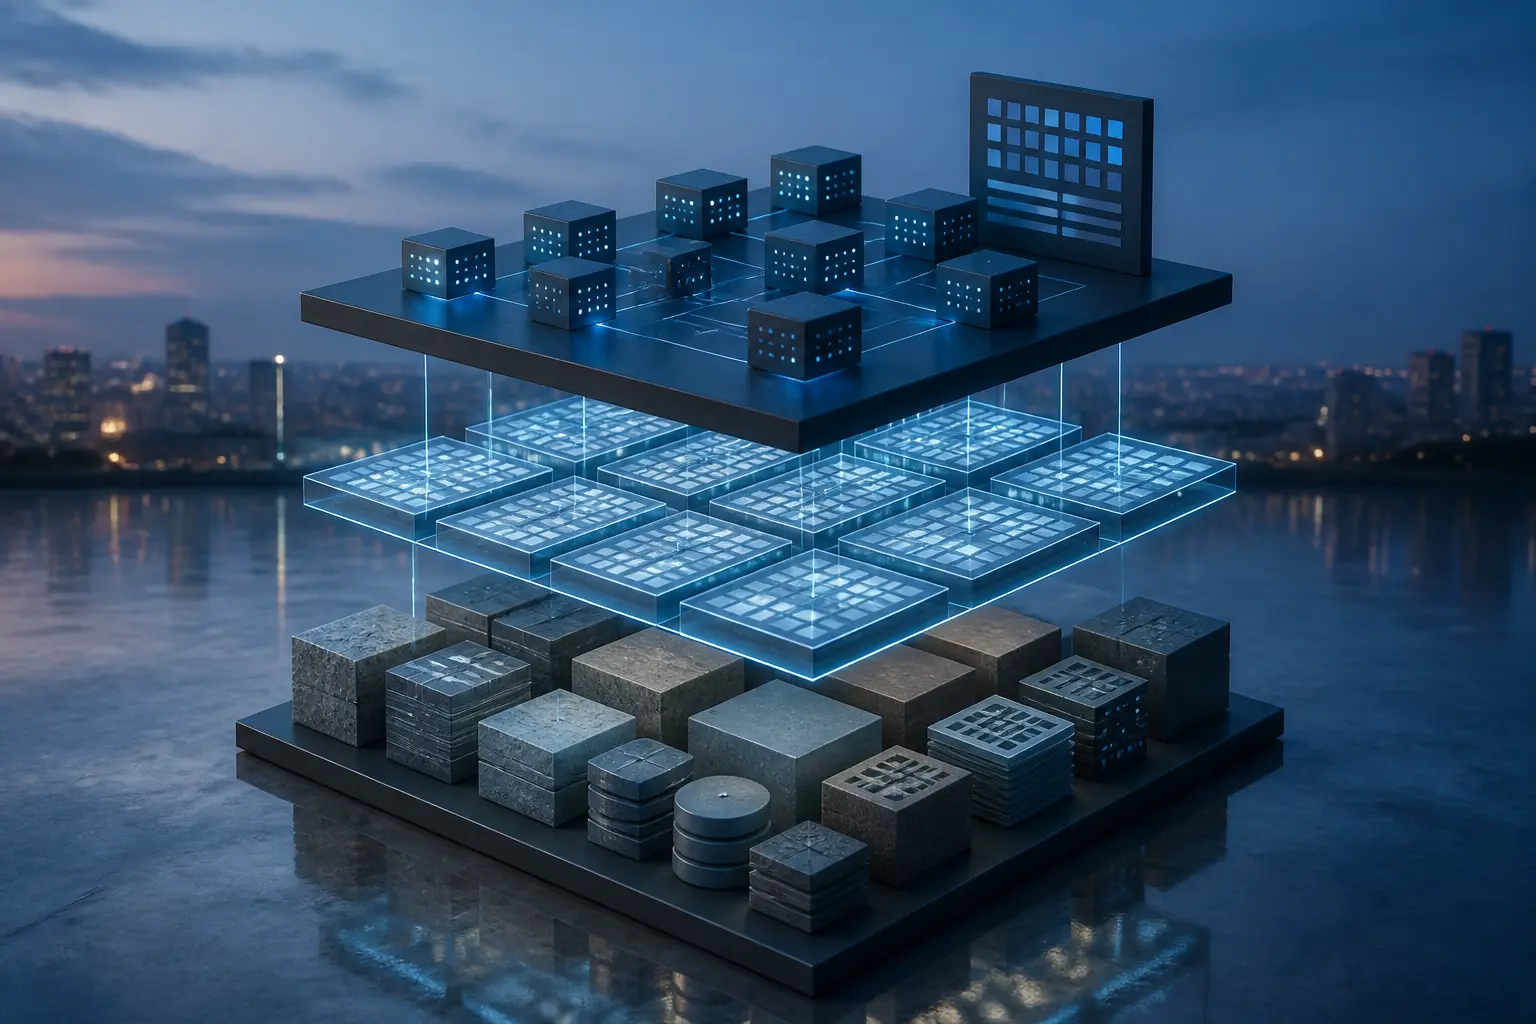
- Шар зберігання
- Табличний шар
- Обчислювальний шар
- Шар каталогу й управління
- Чим lakehouse відрізняється від data lake і data warehouse
- Приклади lakehouse-платформ і технологій
- Коли lakehouse доречний, а коли — зайвий
- Практичні кроки для впровадження
- Поширені запитання про lakehouse
- Чи замінює lakehouse повністю data warehouse?
- Чи можна побудувати lakehouse у власному дата-центрі, без хмари?
- Що таке medallion-архітектура, про яку говорять у контексті lakehouse?
- Чи підходить lakehouse малому бізнесу?
Що таке lakehouse простими словами
Lakehouse — це архітектура платформи даних, що поєднує в одній системі можливості озера даних (data lake) і сховища даних (data warehouse). Назва склалася з двох слів: lake (озеро) та warehouse (сховище). Значення терміна прямо відображає суть: замість двох окремих інфраструктур компанія будує одну, яка вміє і дешево зберігати будь-які сирі дані, і швидко виконувати структуровані SQL-запити з гарантіями цілісності.
Якщо пояснювати зовсім просто: data lake — це велике сховище, куди можна скинути файли будь-якого формату майже без підготовки, але діставати з них корисну інформацію важко й повільно. Data warehouse — навпаки, охайна бібліотека, де все структуровано й легко шукати, проте покласти туди дані можна лише після серйозної обробки, і зберігання обходиться дорого. Lakehouse пропонує компроміс: файли лежать у дешевому відкритому сховищі, а поверх них працює шар, який додає порядок — таблиці, транзакції, схеми, права доступу.
Термін набув популярності після 2020 року, коли компанія Databricks почала активно просувати цю концепцію як відповідь на типову дилему великих організацій: утримувати паралельно озеро для машинного навчання і сховище для бізнес-аналітики занадто дорого й заплутано. Для пошуку за змістом у таких масивах дедалі частіше застосовують спеціалізовані vector database для AI.
Звідки взялася проблема: обмеження data lake і data warehouse
Щоб зрозуміти, навіщо взагалі знадобився lakehouse, варто коротко згадати, з чим зіткнулися команди, які працювали з класичною двосистемною схемою.
Слабкі місця data lake
Озера даних дешеві й гнучкі, але без додаткових механізмів вони швидко перетворюються на так зване «болото даних» (data swamp): файли без схем, дублікати, неможливість точно оновити або видалити запис, відсутність гарантій, що дані не пошкодяться під час збою запису. Аналітик, який хоче зробити SQL-запит прямо по файлах Parquet, часто стикається з низькою швидкістю і непередбачуваними результатами.
Слабкі місця data warehouse
Сховища даних відмінно справляються зі звітністю, але мають власні обмеження:
- дані потрібно спочатку структурувати й завантажити через ETL-процеси, що коштує час і гроші;
- напівструктуровані та неструктуровані дані — JSON-логи, зображення, аудіо, сирі події — поміщаються в них погано або не поміщаються взагалі;
- ліцензійна модель та прив’язка до конкретного вендора ускладнюють масштабування;
- команди машинного навчання зазвичай не можуть працювати з warehouse напряму і вимагають окремих витягів даних.
У результаті багато компаній опинилися в ситуації, коли одні й ті самі дані зберігаються двічі-тричі: у сирому вигляді в озері, в обробленому — у сховищі, у вигляді витягів — у ноутбуках дата-саєнтистів. Кожна копія — це витрати, ризик розбіжностей і додаткові конвеєри, які треба підтримувати.
Як працює lakehouse: ключові шари архітектури
Технічно lakehouse — це не окремий продукт, а набір компонентів, що працюють разом. Розуміння цих шарів допомагає оцінювати й конкретні платформи, і власні рішення.
Шар зберігання
Основа — дешеве об’єктне сховище: Amazon S3, Azure Data Lake Storage, Google Cloud Storage або локальне S3-сумісне рішення у власному дата-центрі. Дані зберігаються у відкритих стовпчикових форматах, найчастіше Parquet. Це означає, що файли не прив’язані до жодного вендора: їх може читати будь-який інструмент, що підтримує формат. Вибір об'єктного сховища часто залежить від того, наскільки розвинені провідні дата-центрові ринки світу.
Табличний шар
Це серце концепції. Формати на кшталт Delta Lake, Apache Iceberg або Apache Hudi додають поверх файлів табличну семантику: ACID-транзакції, еволюцію схеми, контроль версій (time travel), ефективні оновлення та видалення рядків. Саме цей шар перетворює купу файлів на повноцінні таблиці, з якими можна працювати майже як з базою даних, не змінюючи самі файли під капотом радикальним чином.
Обчислювальний шар
До таблиць підключаються різні рушії: SQL-рушій для BI-запитів, Apache Spark для потокової й пакетної обробки, бібліотеки машинного навчання для тренування моделей. Важлива властивість — обчислення відокремлені від зберігання, тож їх можна масштабувати незалежно: більше ресурсів на період звітності, менше вночі.
Шар каталогу й управління
Каталог метаданих (наприклад, Unity Catalog, Hive Metastore або хмарні аналоги) описує, які таблиці існують, хто має до них доступ, які колонки містять персональні дані. Без цього шару lakehouse повторює долю озера-«болота»: технічно дані є, практично ними керувати неможливо.
Чим lakehouse відрізняється від data lake і data warehouse
Порівняння трьох підходів зручно звести в таблицю — вона добре показує, де саме lakehouse займає проміжну позицію.
| Критерій | Data lake | Data warehouse | Lakehouse |
|---|---|---|---|
| Типи даних | Будь-які, включно з неструктурованими | Переважно структуровані | Будь-які, з можливістю структурування |
| Гарантії цілісності | Мінімальні | Повні ACID-транзакції | ACID через табличний шар |
| Вартість зберігання | Низька | Висока | Низька |
| Швидкість SQL-запитів | Низька або середня | Висока | Середня-висока, залежить від рушія |
| Придатність для ML | Висока | Низька | Висока |
| Прив’язка до вендора | Низька | Часто висока | Зазвичай низька завдяки відкритим форматам |
| Складність адміністрування | Низька на старті, висока з часом | Середня | Середня-висока |
Одна з цілей lakehouse — зменшити дублювання та кількість конвеєрів між озером і сховищем, але результат залежить від архітектури й міграції. Аналітик і дата-саєнтист працюють з одними й тими самими таблицями: перший — через SQL, другий — через Python-ноутбук. За правильної реалізації обидві команди можуть працювати з тим самим табличним шаром, хоча окремі копії, кеші та спеціалізовані вітрини іноді залишаються.
Приклади lakehouse-платформ і технологій
Концепцію реалізують різні екосистеми — і хмарні сервіси, і відкриті проєкти. Декілька характерних прикладів:
- Databricks Lakehouse Platform — комерційна платформа навколо Delta Lake, що фактично запустила популяризацію терміна; поєднує Spark, SQL-ентпоінти та інструменти ML.
- Apache Iceberg — відкритий табличний формат, який підтримують Snowflake, Trino, Flink, Spark та низка хмарних сервісів; часто стає основою незалежного від вендора lakehouse.
- Apache Hudi — формат із сильними можливостями інкрементальної обробки, популярний у потокових сценаріях.
- Хмарні рішення: комбінації на кшталт S3 + Iceberg + Trino/Athena, Azure Data Lake Storage + Synapse/Fabric, Google Cloud Storage + BigLake дозволяють зібрати lakehouse із керованих сервісів.
- Snowflake з підтримкою зовнішніх таблиць Iceberg — приклад того, як класичні сховища рухаються назустріч концепції зі свого боку.
Помітна тенденція: межа між «сховищем» і «lakehouse» розмивається. Вендори warehouse додають підтримку відкритих форматів, а платформи озер — швидкі SQL-рушії. Відкритий формат може зменшити залежність від вендора, але каталоги, керування доступом і фірмові сервіси все одно можуть створювати прив’язку.
Коли lakehouse доречний, а коли — зайвий
Архітектура не є універсальною відповіддю. Рішення про впровадження варто приймати, дивлячись на реальний профіль навантажень, а не на модний термін у презентації.
Lakehouse дає помітну вигоду, коли:
- в організації вже існують і озеро, і сховище, а витрати на їх синхронізацію стали відчутними;
- команди аналітики та машинного навчання працюють із тими самими даними й страждають від розбіжностей копій;
- є значні обсяги напівструктурованих даних — логи, телеметрія, події — поряд з класичною звітністю;
- важлива незалежність від конкретного вендора та відкритість форматів зберігання.
Натомість поспішати не варто, якщо потреби прості. Компанії, якій достатньо кількох джерел і стандартної BI-звітності, часто простіше й дешевше підняти один керований data warehouse. Lakehouse вимагає кваліфікованих інженерів: налаштування табличного шару, каталогу, оптимізації запитів і компакції файлів — це робота, яку класичне кероване сховище бере на себе. Економія на зберіганні може «з’їстися» вартістю команди, якщо масштаб даних невеликий.
Окреме застереження стосується міграції: перехід на lakehouse — це не заміна одного інструмента іншим, а перебудова конвеєрів, практик управління даними та навичок команди. Реалістично планувати поетапний перенос: спочатку нові домени даних, потім поступово — існуючі вітрини.
Практичні кроки для впровадження
Якщо рішення прийнято, корисно триматися стислого алгоритму, який знижує ризик типових помилок:
- Проаудитуйте наявні дані: які джерела, обсяги, формати, хто споживачі, де зараз дублюються копії.
- Визначте два-три пілотні сценарії з вимірюваним результатом — наприклад, прибрати нічне копіювання конкретного набору даних у сховище.
- Оберіть табличний формат (Delta Lake, Iceberg, Hudi) з огляду на рушії, які вже використовує команда.
- Одразу налаштуйте каталог метаданих і модель доступу — відкладати governance «на потім» означає повторити шлях до болота даних.
- Побудуйте один повний конвеєр від сирих даних до BI-звіту, виміряйте вартість і швидкість запитів, і лише потім масштабуйте на інші домени.
Ключовий принцип: спочатку доведіть цінність на маленькому контурі, потім інвестуйте в міграцію всього ландшафту. Масштабна міграція без перевіреного пілота підвищує ризик витрат без вимірного результату.
Поширені запитання про lakehouse
Чи замінює lakehouse повністю data warehouse?
У частині сценаріїв lakehouse може взяти на себе функції warehouse, особливо коли звітність будується поверх того самого табличного шару. Але організації зі складними вимогами до продуктивності BI або наявними великими інвестиціями в warehouse іноді залишають обидві системи, використовуючи lakehouse як джерело.
Чи можна побудувати lakehouse у власному дата-центрі, без хмари?
Так. Знадобиться S3-сумісне об’єктне сховище (наприклад, MinIO), обчислювальний кластер зі Spark чи Trino і вибраний табличний формат. Хмара спрощує старт, але не є обов’язковою умовою архітектури.
Що таке medallion-архітектура, про яку говорять у контексті lakehouse?
Це практика поділу даних на шари за ступенем обробки: bronze — сирі дані як є, silver — очищені й приведені до схеми, gold — агреговані вітрини для звітів. Вона не є обов’язковою частиною lakehouse, але добре лягає на його можливості, бо всі шари живуть в одній системі.
Чи підходить lakehouse малому бізнесу?
Часто ні: за невеликих обсягів даних і простих потреб вигода може не покрити складності. Lakehouse розкривається там, де є різнорідні дані, кілька команд-споживачів і відчутні витрати на підтримку паралельних систем.