Коли смартфон розпізнає обличчя без мережі, камера аналізує кадр поруч із місцем знімання, а робот-пилосос обходить перешкоду, обчислення можуть виконуватися на периферії. Edge AI — це застосування штучного інтелекту ближче до джерела даних: на кінцевому пристрої, локальному шлюзі або іншому вузлі краю мережі. Водночас варто розрізняти локальний інференс і що таке генеративний ai: як моделі створюють текст, який створює новий текст, зображення чи аудіо.
AI-модель розпізнає закономірності або генерує результат, а edge означає обчислення поза центральним дата-центром, ближче до даних. Інференс може працювати на телефоні, камері, автомобільному комп’ютері чи локальному сервері. Тому edge AI не обов’язково означає повну відмову від хмари: багато систем розподіляють роботу між кількома рівнями.
- Чому штучний інтелект почали переносити на пристрої
- Як працює edge AI технічно
- Стиснення моделей
- Спеціалізовані чипи
- Цикл роботи
- Чим edge AI відрізняється від хмарного AI
- Приклади edge AI у реальному житті
- Агенти і моделі на пристроях: куди рухається технологія
- Обмеження, про які варто знати
- Як зрозуміти, чи потрібен edge-підхід у вашому проєкті
- Поширені запитання про edge AI
- Чи потрібен інтернет для роботи edge AI?
- Чим edge AI відрізняється від edge computing?
- Чи можна навчати моделі прямо на смартфоні?
- Чи безпечніший edge AI для приватності?
- Чи замінить edge AI хмарний штучний інтелект?
Чому штучний інтелект почали переносити на пристрої
У хмарній схемі пристрій надсилає дані до дата-центру й отримує результат назад. Це добре підходить для багатьох задач, але мережевий шлях може додавати затримку, залежність від зв’язку, витрати на трафік і ризики для приватності. Наскільки суттєвий кожен фактор, залежить від системи.
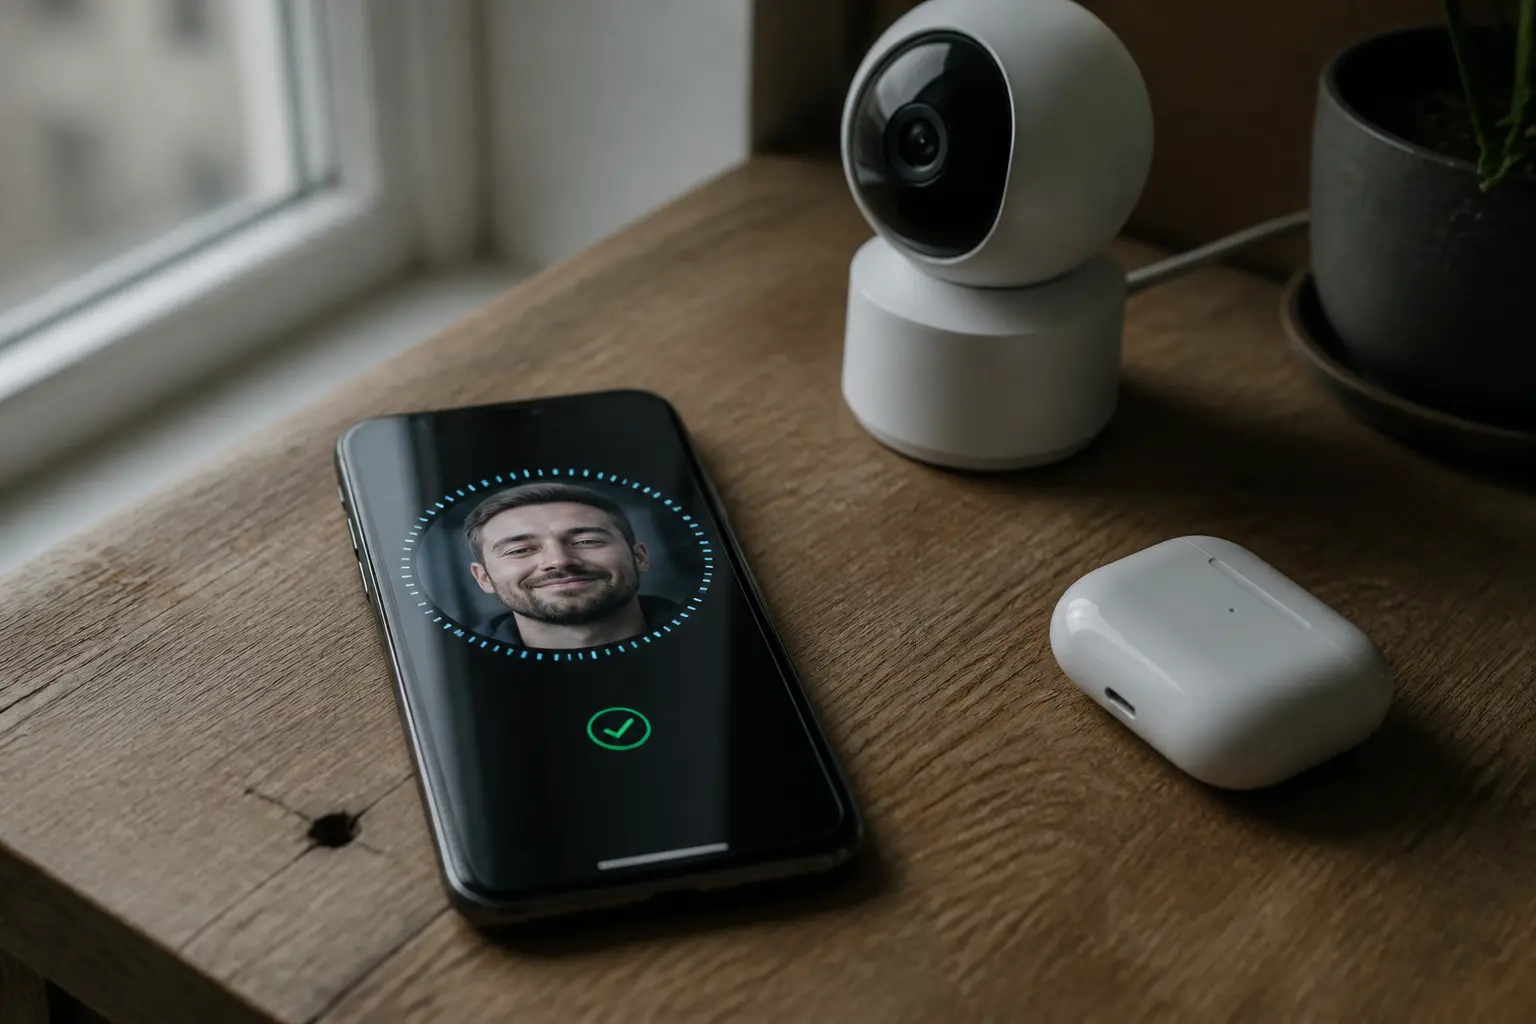
Перша причина — затримка й передбачуваність реакції. Для систем допомоги водієві або промислового захисту критичні функції зазвичай виконують локально, бо час відповіді хмари залежить від мережі. Це не означає, що кожен хмарний запит триває десятки чи сотні мілісекунд: реальна затримка залежить від відстані, каналу й архітектури.
Друга — залежність від зв’язку. Канал може бути повільним, дорогим або відсутнім взагалі: у тунелі, у полі, у шахті, на морській платформі. Пристрій, який глухне без інтернету, у таких умовах марний.
Третя причина — приватність і вартість передавання. Локальна обробка може зменшити обсяг сирих даних, що залишають пристрій, але сама по собі не гарантує конфіденційності: потрібно захищати пристрій, модель, журнали, оновлення й дані, які все ж синхронізуються. Вигода за трафіком також залежить від обладнання та навантаження.
Окремий випадок — physical AI, де локальні моделі взаємодіють із роботами, складами та виробничим обладнанням.
Як працює edge AI технічно
Найпоширеніший сценарій — навчити модель на серверній інфраструктурі, оптимізувати й розгорнути її для локального інференсу. Проте edge-вузли можуть також донавчати невеликі моделі або брати участь у спільному навчанні. NIST прямо розрізняє рівні від простого використання готової моделі до edge learning.
Стиснення моделей
Щоб модель, створена для серверних графічних процесорів, вмістилася в телефон чи мікроконтролер, її стискають кількома способами:
- Квантування зменшує числову точність ваг і обчислень, наприклад із 32 до 8 біт або нижче. Це може скоротити модель і прискорити інференс, але вплив на точність потрібно вимірювати для конкретної моделі й апаратури.
- Прунінг видаляє параметри або структури, які вважаються менш важливими. Прискорення залежить від того, чи підтримує апаратне забезпечення отриману розрідженість; менша кількість параметрів не завжди автоматично означає пропорційно швидшу роботу.
- Дистиляція — навчання компактної моделі повторювати поведінку великої, «вчительської» моделі.
Після оптимізації деякі моделі стають достатньо малими для телефону або мікроконтролера. Розмір, швидкість і енергоспоживання різняться на порядки, тому універсальні обіцянки про «кілька мегабайт», частки секунди або частку вата без конкретного тесту некоректні.
Спеціалізовані чипи
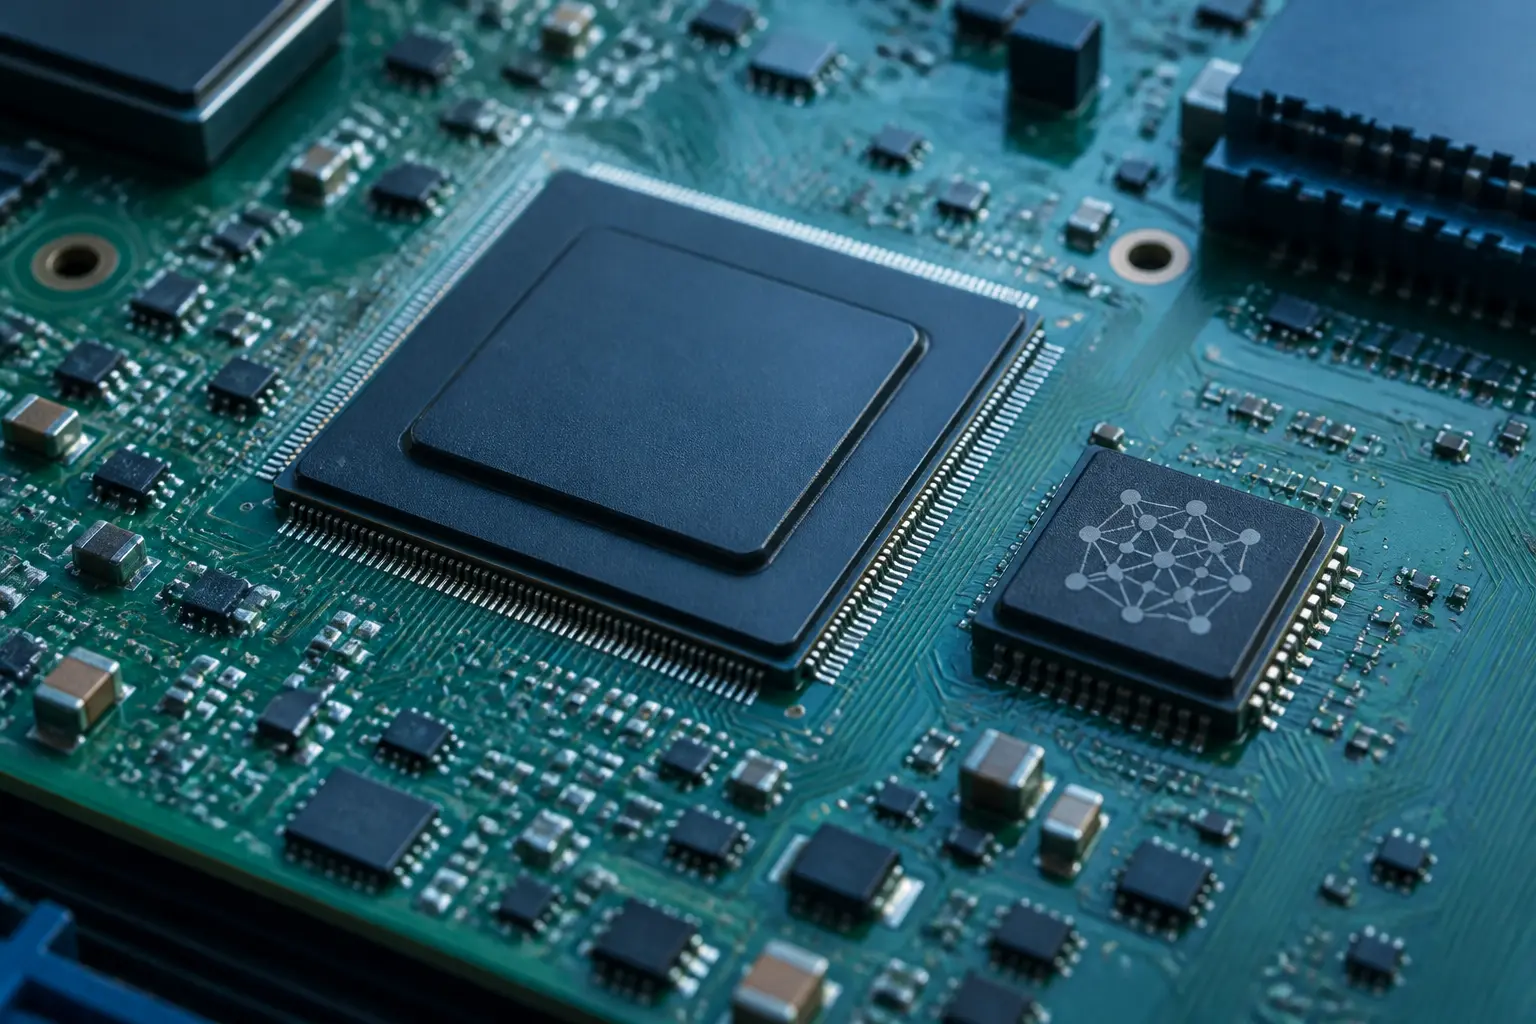
Сучасні системи на чипі можуть мати NPU або інші прискорювачі для нейромереж. Їхня перевага над CPU залежить від моделі, операцій, програмного стеку й режиму енергоспоживання. TinyML запускає компактні моделі на мікроконтролерах, але час роботи від батареї визначається всім пристроєм і частотою обчислень.
Цикл роботи
Датчик збирає дані, локальний або близький edge-вузол виконує інференс, а система реагує чи передає результат далі. У хмару можуть надходити події, агрегати або сирі дані — це вибір архітектури, а не гарантована властивість edge AI. Гібридна схема часто поєднує локальну реакцію з хмарним аналізом і оновленням моделей.
Чим edge AI відрізняється від хмарного AI
Порівняння двох підходів найзручніше побачити в таблиці.
| Критерій | Edge AI (на пристрої) | Хмарний AI |
|---|---|---|
| Затримка | Мілісекунди, реакція в реальному часі | Залежить від мережі, десятки-сотні мілісекунд |
| Робота без інтернету | Можлива, якщо модель і дані локальні | Потрібен для хмарного запиту |
| Приватність | Дані можуть залишатися локально | Дані передаються для хмарної обробки |
| Потужність моделі | Обмежена пам’яттю й чипом пристрою | Обмежена ресурсами дата-центру |
| Вартість масштабування | Обладнання на edge, потенційно менший трафік | Серверна інфраструктура й мережеві витрати |
| Оновлення моделі | Через оновлення прошивки чи застосунку | Централізовано; потрібні тестування і розгортання |
Edge і хмара часто доповнюють одне одного. Периферія корисна для передбачуваної затримки, роботи при нестабільному зв’язку та зменшення трафіку; хмара — для великих обчислень, централізованого керування й навчання. Приватність залежить від реалізації обох рівнів, а не лише від місця інференсу.
Приклади edge AI у реальному житті
Абстрактне пояснення стає зрозумілим через конкретні сценарії, більшість із яких ви вже використовуєте щодня.
- Смартфони. Частина функцій розпізнавання обличчя, голосу, обробки фото й перекладу може виконуватися локально. Конкретна функція може також звертатися до хмари, тому режим потрібно перевіряти за документацією пристрою й застосунку.
- Автомобілі. Критичне розпізнавання для систем допомоги водієві виконується на борту через вимоги до затримки й доступності. Хмарні сервіси можуть доповнювати систему картами, телеметрією та оновленнями, але не повинні бути єдиною ланкою негайної реакції.
- Відеоспостереження. Камера або локальний шлюз може виявляти рух, номери чи об’єкти й надсилати лише події. Інші конфігурації зберігають або передають відео, тож обсяг і місце обробки треба перевіряти для конкретної системи.
- Промисловість. Датчики з TinyML-моделями слухають вібрацію верстата й помічають ознаки поломки раніше, ніж вона станеться. Це основа передбачувального обслуговування: ремонт за фактом потреби, а не після аварії.
- Медицина та здоров’я. Деякі носимі пристрої локально виявляють ритм серця або падіння, але результати можуть синхронізуватися з телефоном чи сервісом. Локальний аналіз зменшує передавання сирих даних лише тоді, коли так налаштований увесь продукт.
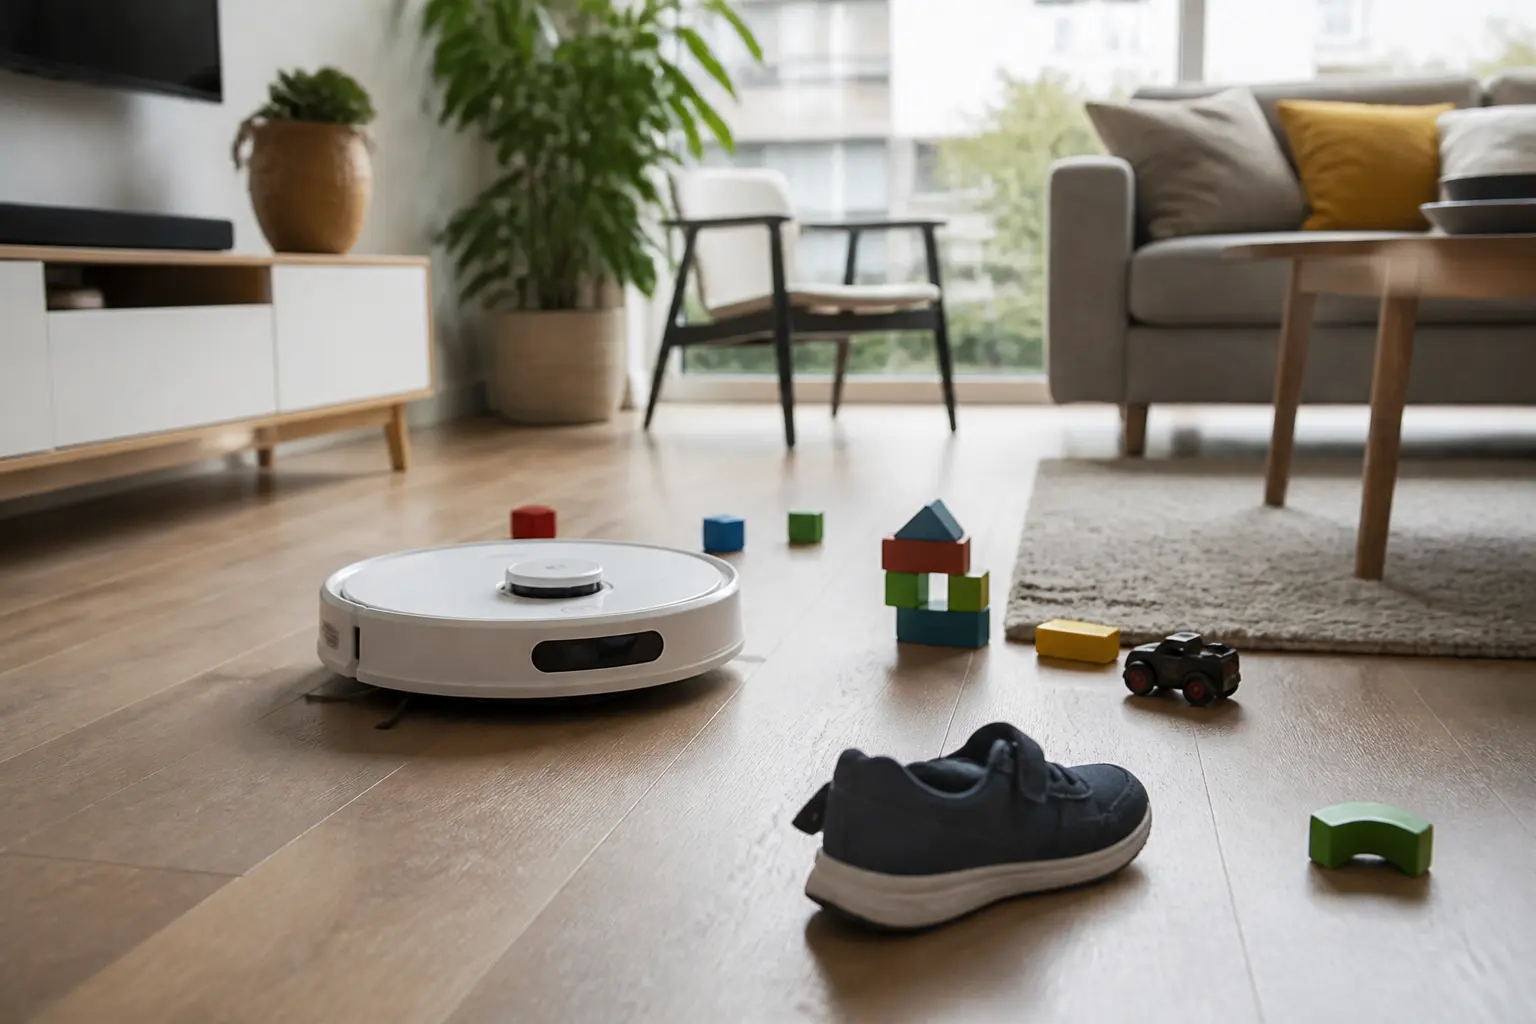
- Побутова техніка. Пилососи розпізнають предмети на підлозі, пральні машини підбирають режим під тканину, холодильники відслідковують продукти.
- Сільське господарство. Дрони й обприскувачі з комп’ютерним зором розрізняють бур’яни й культурні рослини прямо в полі, де інтернету може не бути взагалі.
Спільне в усіх цих прикладах — рішення потрібне тут і зараз, а дані або надто об’ємні, або надто чутливі, щоб ганяти їх через мережу.
Агенти і моделі на пристроях: куди рухається технологія
Компактні мовні й мультимодальні моделі вже запускаються на смартфонах і ноутбуках. Вони можуть підтримувати офлайн-функції, але багато асистентів залишаються гібридними й передають частину запитів у хмару. Режим обробки та політику даних потрібно перевіряти для конкретного продукту.
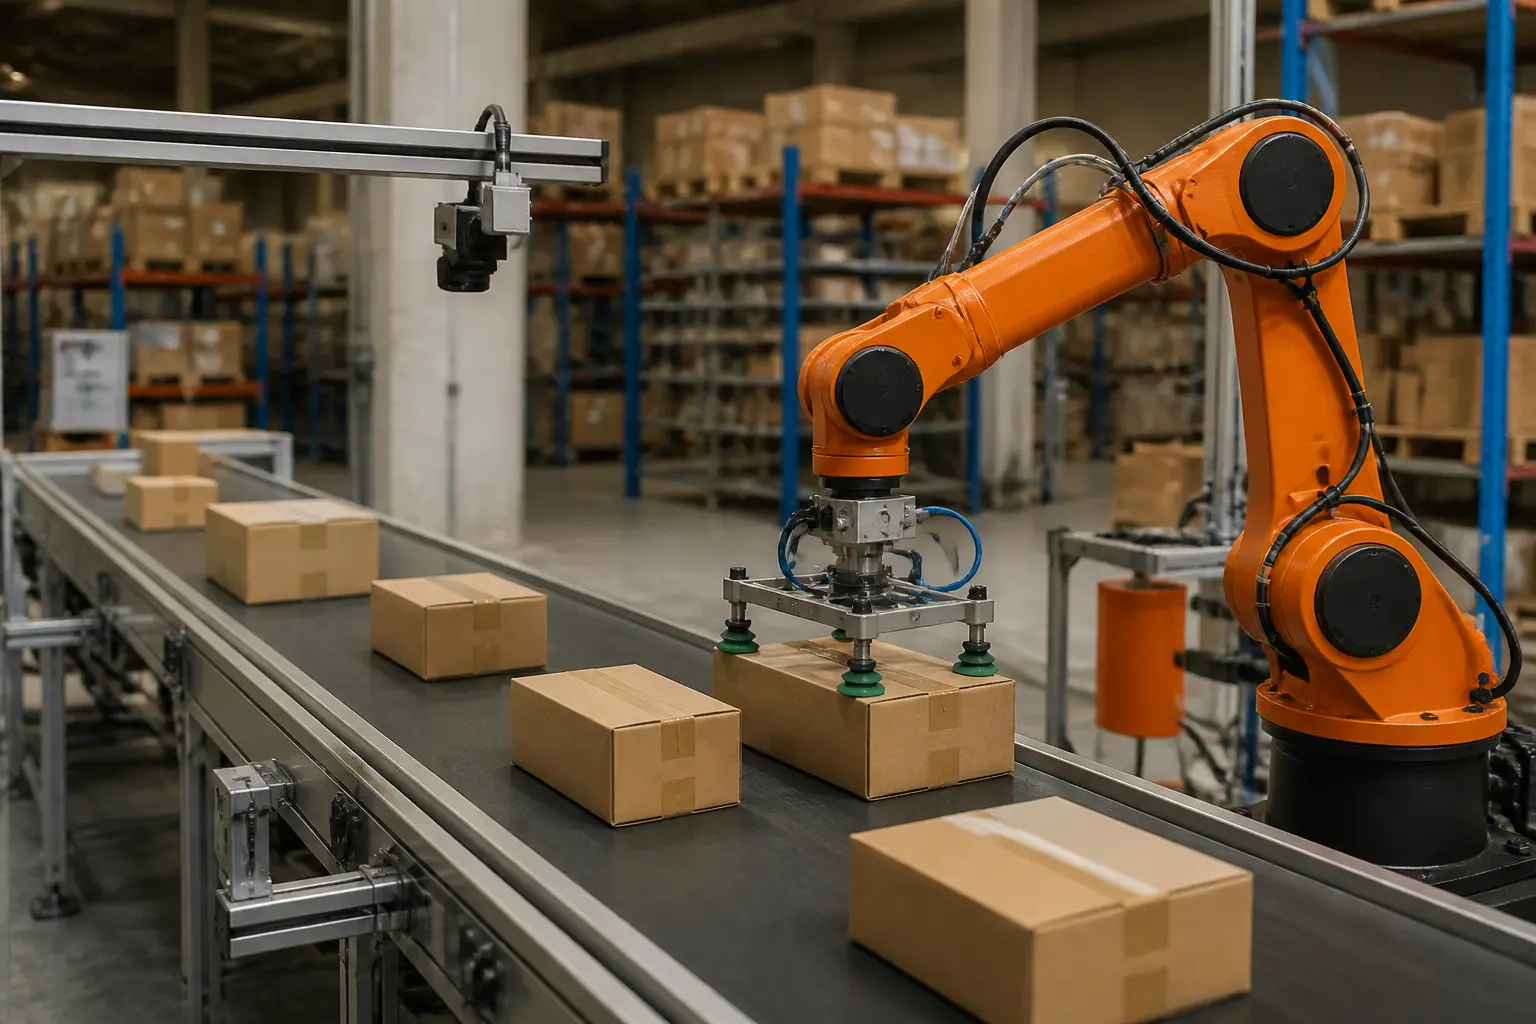
Агенти на пристрої можуть виконувати послідовність кроків, використовувати камеру чи мікрофон і керувати функціями системи. У робототехніці локальне комп’ютерне бачення широко застосовується, але зв’язок із сервером може використовуватися для координації, журналів, оновлень або складніших задач.
Федеративне навчання дає змогу обчислювати оновлення на багатьох пристроях без прямого збирання всіх сирих даних в одному місці. Це зменшує частину ризиків, але не гарантує приватності: оновлення також потребують захисту, агрегації й перевірки. Можливості локальних моделей зростають, однак темп залежить від задачі та класу пристрою.
Обмеження, про які варто знати
Edge AI не є універсальною відповіддю, і його слабкі місця випливають із тих самих причин, що й сильні.
Ресурси edge-вузла обмежені пам’яттю, обчислювальною потужністю, тепловим режимом і енергією. На сучасних телефонах уже працюють компактні генеративні моделі, але більший контекст, висока пропускна здатність або великі бази знань часто потребують хмари чи локального сервера.
Енергоспоживання. Постійна робота нейромережі на акумуляторі — це компроміс між функціональністю та автономністю. Розробникам доводиться ретельно балансувати частоту інференсу та складність моделі.
Хмарну модель можна оновити централізовано, але нова версія також потребує тестування й розгортання. Моделі на пристроях залежать від оновлень застосунку або прошивки та сумісності обладнання, тому парк версій зазвичай різноманітніший.
Стиснення може погіршити точність, залишити її майже незмінною або іноді поліпшити окрему метрику завдяки додатковому навчанню. Висновок роблять за тестом на репрезентативних даних, особливо для критичних застосувань.
Як зрозуміти, чи потрібен edge-підхід у вашому проєкті
Якщо ви обираєте архітектуру для власного продукту — чи то розробник, чи підприємець, — практичне рішення зводиться до кількох запитань:
- Чи критична затримка? Якщо реакція має бути гарантовано швидкою, критичну функцію варто розміщувати на пристрої або близькому edge-вузлі й перевіряти її за найгірших умов мережі.
- Чи працюватиме система без стабільного інтернету? Якщо так, локальний інференс обов’язковий.
- Наскільки чутливі дані? Біометрія, медичні показники, домашнє відео — вагомі аргументи обробляти все на пристрої.
- Який обсяг сирих даних? Якщо кожен із тисяч пристроїв генерує гігабайти на день, відправка всього в хмару економічно безглузда.
- Чи вистачить потужності моделі? Якщо задача потребує великої мовної моделі з широким контекстом, edge буде лише доповненням до хмари.
На практиці найчастіше виграє гібрид: простий і швидкий шар рішень на пристрої, складна аналітика й навчання — у хмарі. Саме за таким принципом побудовані майже всі масові продукти з edge AI сьогодні.
Практичні сценарії доповнює AI у браузері та на пристрої, де вибір між локальним і хмарним виконанням залежить від моделі, ресурсів і вимог до даних.
Поширені запитання про edge AI
Чи потрібен інтернет для роботи edge AI?
Edge AI може працювати без інтернету, якщо модель, потрібні дані й логіка повністю розміщені локально. Але edge-система може залежати від мережі для авторизації, хмарної частини моделі, синхронізації чи оновлень, тому офлайн-режим не є автоматичною властивістю кожного продукту.
Чим edge AI відрізняється від edge computing?
Edge computing — ширше поняття: обчислення виконуються ближче до джерела даних, зокрема на пристрої, шлюзі або периферійному сервері. Edge AI — випадок, коли на одному з цих вузлів працює AI-модель або процес її навчання.
Чи можна навчати моделі прямо на смартфоні?
Великі моделі зазвичай навчають на серверній інфраструктурі, але невеликі моделі можна навчати чи донавчати на смартфоні та інших edge-вузлах. Федеративне й персоналізоване навчання також використовує локальні обчислення; можливість залежить від моделі, даних і ресурсів.
Чи безпечніший edge AI для приватності?
Потенційно так, якщо система мінімізує передавання даних і правильно захищає пристрій. Проте edge створює власні ризики: фізичний доступ, уразливі оновлення, витік локального сховища або параметрів моделі. NIST радить оцінювати приватність і безпеку всієї системи.
Чи замінить edge AI хмарний штучний інтелект?
Ні. Ці підходи розв’язують різні задачі й усе частіше працюють у парі: пристрій реагує миттєво й приватно, хмара забезпечує навчання, масштаб і найпотужніші моделі.