Когда смартфон распознает лицо без сети, камера анализирует кадр рядом с местом съемки, а робот-пылесос обходит препятствие, вычисления могут выполняться на периферии. Edge AI — это применение искусственного интеллекта ближе к источнику данных: на конечном устройстве, локальном шлюзе или другом узле края сети.
AI-модель распознает закономерности или генерирует результат, а edge означает вычисления вне центрального дата-центра, ближе к данным. Инференс может работать на телефоне, камере, автомобильном компьютере или локальном сервере. Поэтому edge AI не обязательно означает полный отказ от облака: многие системы распределяют работу между несколькими уровнями.
- Почему искусственный интеллект начали переносить на устройства
- Как работает edge AI технически
- Сжатие моделей
- Специализированные чипы
- Цикл работы
- Чем edge AI отличается от облачного AI
- Примеры edge AI в реальной жизни
- Агенты и модели на устройствах: куда движется технология
- Ограничения, о которых стоит знать
- Как понять, нужен ли edge-подход в вашем проекте
- Часто задаваемые вопросы об edge AI
- Нужен ли интернет для работы edge AI?
- Чем edge AI отличается от edge computing?
- Можно ли обучать модели прямо на смартфоне?
- Безопаснее ли edge AI для приватности?
- Заменит ли edge AI облачный искусственный интеллект?
Почему искусственный интеллект начали переносить на устройства
В облачной схеме устройство отправляет данные в дата-центр и получает результат обратно. Это хорошо подходит для многих задач, но сетевой путь может добавлять задержку, зависимость от связи, расходы на трафик и риски для приватности. Насколько существенен каждый фактор, зависит от системы.
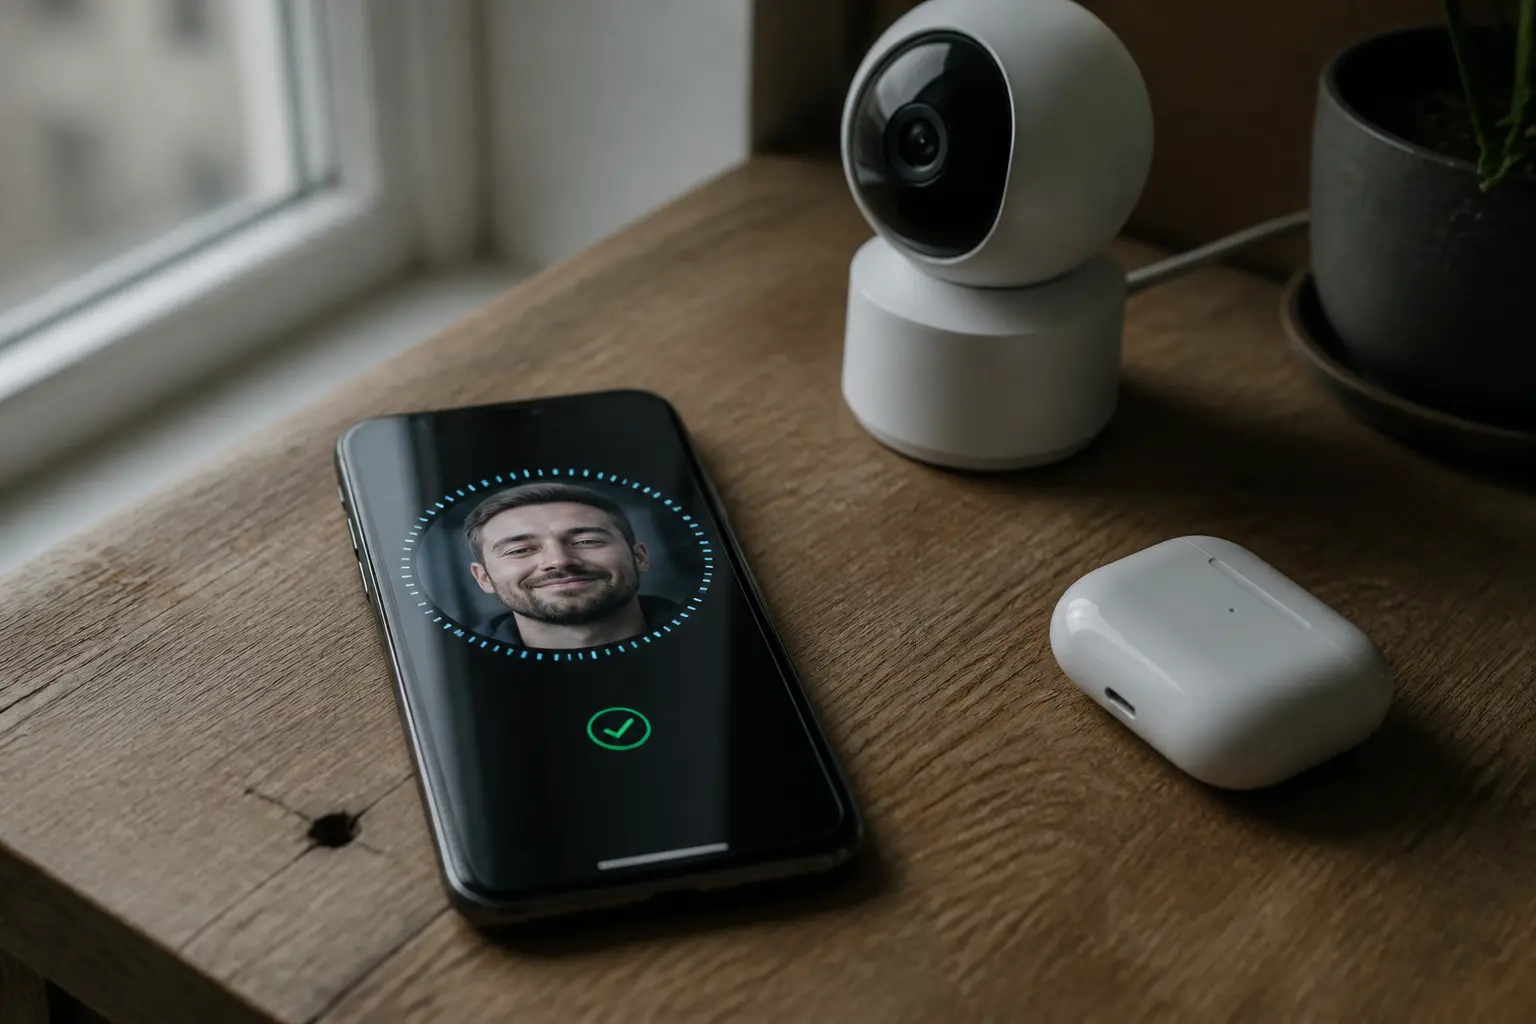
Первая причина — задержка и предсказуемость реакции. Для систем помощи водителю или промышленной защиты критические функции обычно выполняют локально, потому что время ответа облака зависит от сети. Это не означает, что каждый облачный запрос занимает десятки или сотни миллисекунд: реальная задержка зависит от расстояния, канала и архитектуры.
Вторая — зависимость от связи. Канал может быть медленным, дорогим или отсутствовать вовсе: в туннеле, в поле, в шахте, на морской платформе. Устройство, которое глохнет без интернета, в таких условиях бесполезно.
Третья причина — приватность и стоимость передачи. Локальная обработка может уменьшить объем сырых данных, покидающих устройство, но сама по себе не гарантирует конфиденциальность: нужно защищать устройство, модель, журналы, обновления и данные, которые все же синхронизируются. Выгода по трафику также зависит от оборудования и нагрузки.
Как работает edge AI технически
Наиболее распространенный сценарий — обучить модель на серверной инфраструктуре, оптимизировать и развернуть ее для локального инференса. Однако edge-узлы могут также дообучать небольшие модели или участвовать в совместном обучении. NIST прямо различает уровни от простого использования готовой модели до edge learning.
Сжатие моделей
Чтобы модель, созданная для серверных графических процессоров, поместилась в телефон или микроконтроллер, ее сжимают несколькими способами:
- Квантизация уменьшает числовую точность весов и вычислений, например с 32 до 8 бит или ниже. Это может сократить модель и ускорить инференс, но влияние на точность нужно измерять для конкретной модели и аппаратуры.
- Прунинг удаляет параметры или структуры, которые считаются менее важными. Ускорение зависит от того, поддерживает ли оборудование полученную разреженность; меньшее число параметров не всегда автоматически означает пропорционально более быструю работу.
- Дистилляция — обучение компактной модели повторять поведение большой, «учительской» модели.
После оптимизации некоторые модели становятся достаточно малыми для телефона или микроконтроллера. Размер, скорость и энергопотребление различаются на порядки, поэтому универсальные обещания о «нескольких мегабайтах», долях секунды или доле ватта без конкретного теста некорректны.
Специализированные чипы
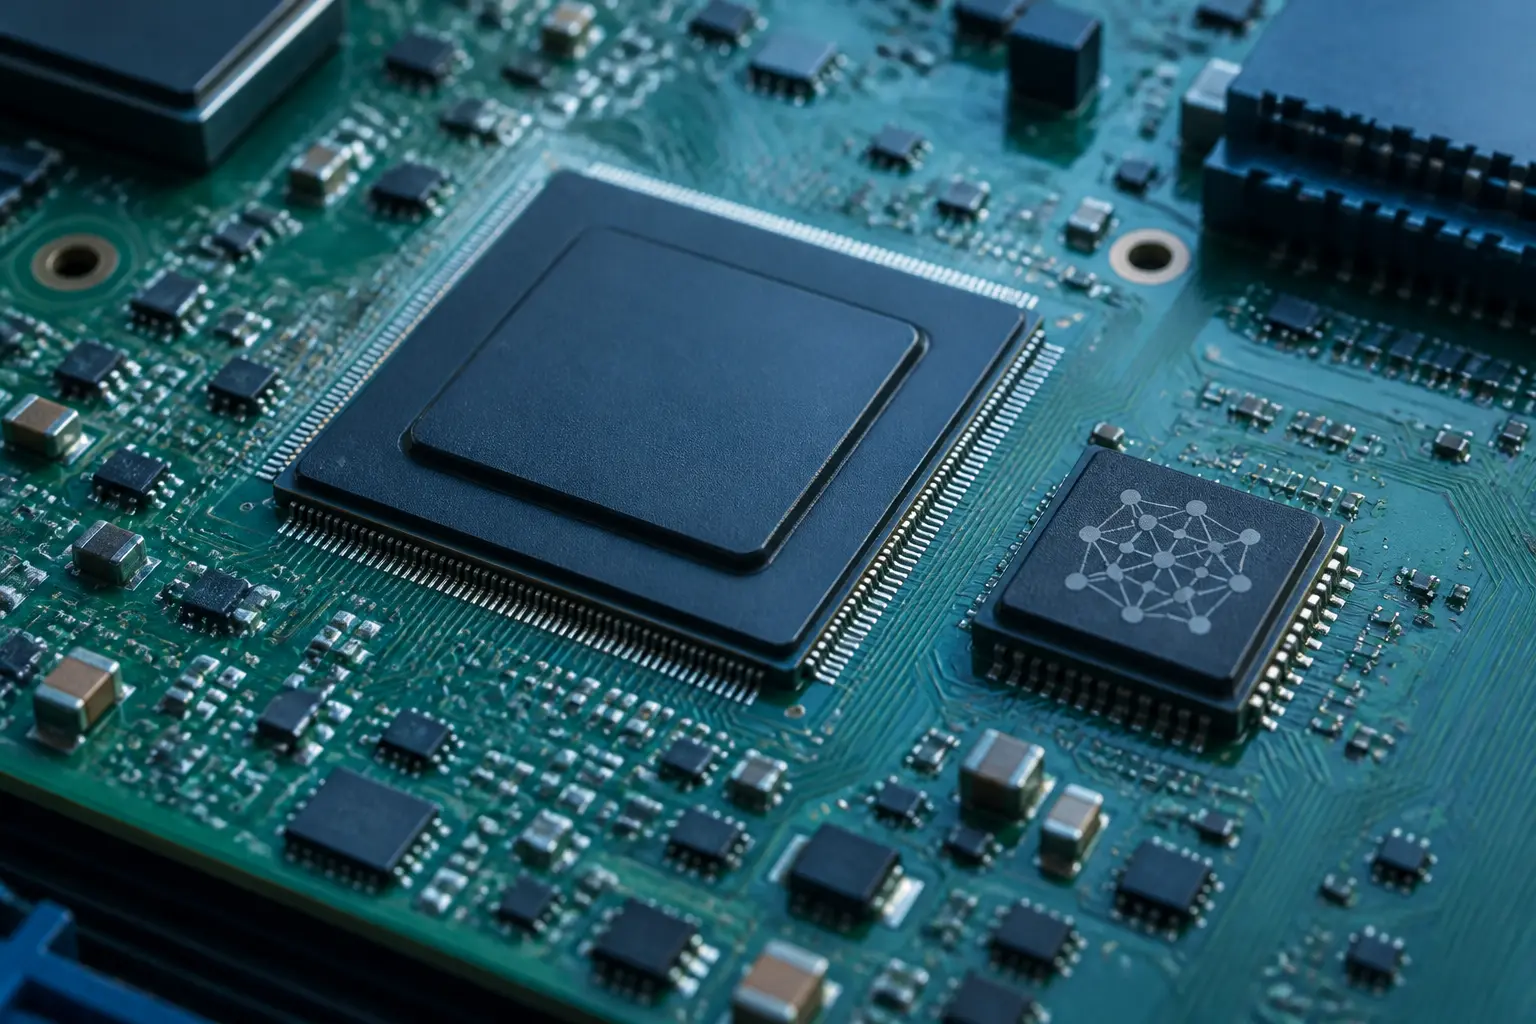
Современные системы на чипе могут иметь NPU или другие ускорители нейросетей. Их преимущество над CPU зависит от модели, операций, программного стека и режима энергопотребления. TinyML запускает компактные модели на микроконтроллерах, но время работы от батареи определяется всем устройством и частотой вычислений.
Цикл работы
Датчик собирает данные, локальный или близкий edge-узел выполняет инференс, а система реагирует или передает результат дальше. В облако могут поступать события, агрегаты или сырые данные — это выбор архитектуры, а не гарантированное свойство edge AI. Гибридная схема часто сочетает локальную реакцию с облачным анализом и обновлением моделей.
Чем edge AI отличается от облачного AI
Сравнение двух подходов удобнее всего увидеть в таблице.
| Критерий | Edge AI (на устройстве) | Облачный AI |
|---|---|---|
| Задержка | Миллисекунды, реакция в реальном времени | Зависит от сети, десятки-сотни миллисекунд |
| Работа без интернета | Возможна, если модель и данные локальны | Нужна для облачного запроса |
| Приватность | Данные могут оставаться локально | Данные передаются для облачной обработки |
| Мощность модели | Ограничена памятью и чипом устройства | Ограничена ресурсами дата-центра |
| Стоимость масштабирования | Оборудование на edge, потенциально меньший трафик | Серверная инфраструктура и сетевые расходы |
| Обновление модели | Через обновление прошивки или приложения | Централизованно; нужны тестирование и развертывание |
Edge и облако часто дополняют друг друга. Периферия полезна для предсказуемой задержки, работы при нестабильной связи и уменьшения трафика; облако — для больших вычислений, централизованного управления и обучения. Приватность зависит от реализации обоих уровней, а не только от места инференса.
Примеры edge AI в реальной жизни
Абстрактное объяснение становится понятным через конкретные сценарии, большинство из которых вы уже используете ежедневно.
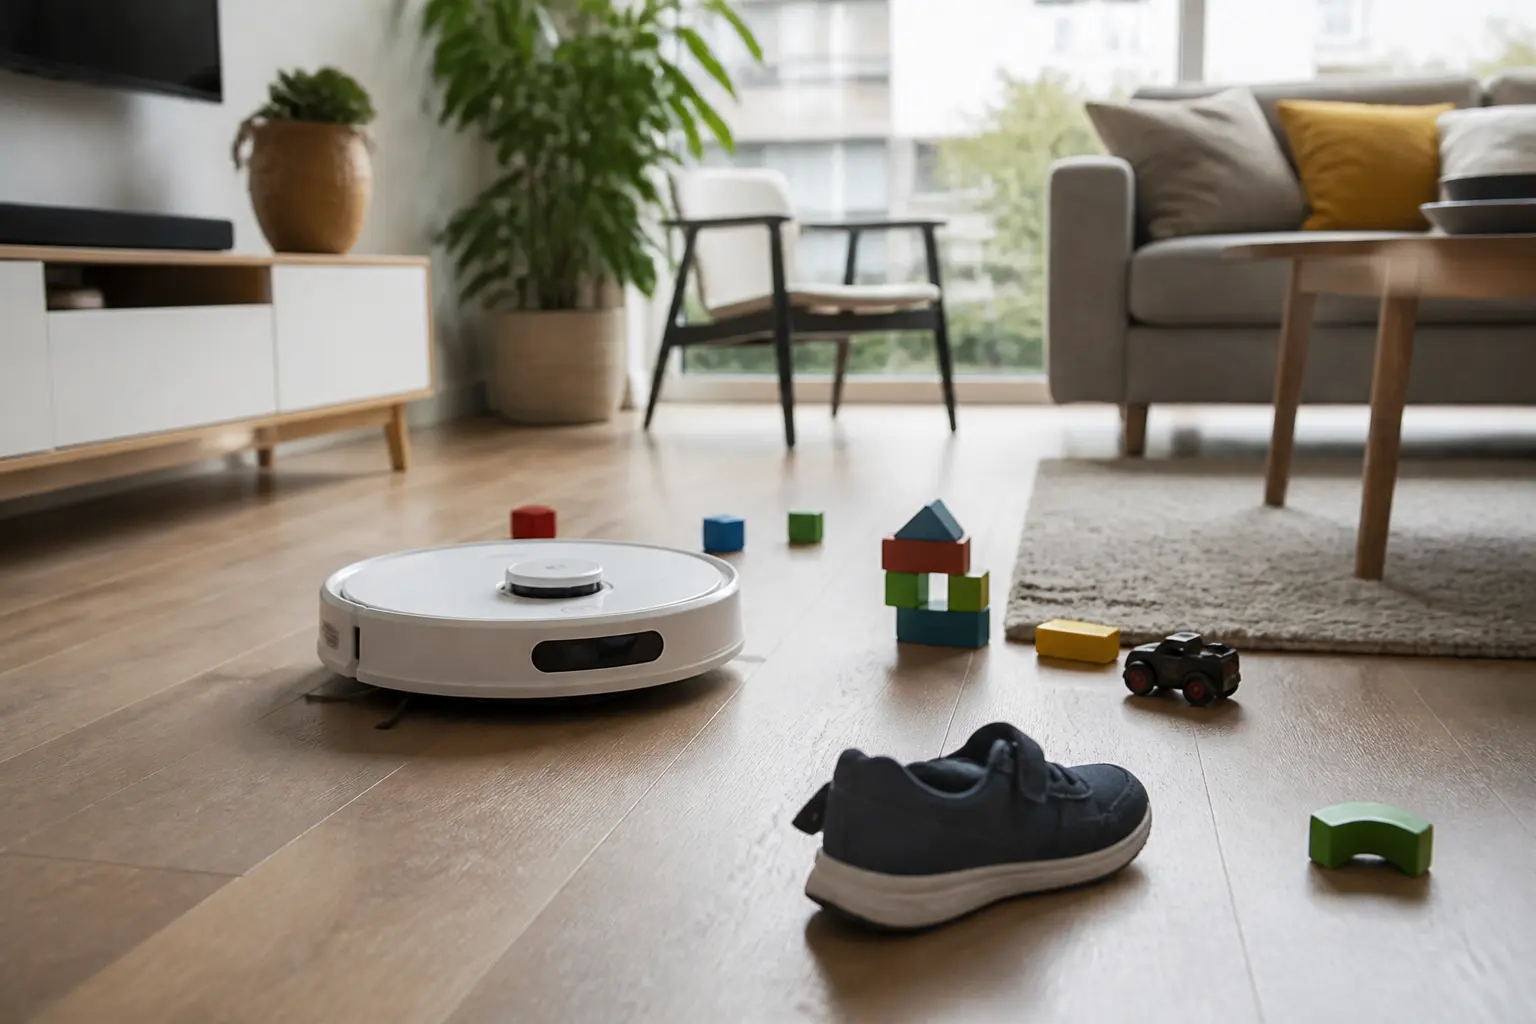
- Смартфоны. Часть функций распознавания лица, голоса, обработки фото и перевода может выполняться локально. Конкретная функция может также обращаться к облаку, поэтому режим нужно проверять по документации устройства и приложения.
- Автомобили. Критическое распознавание для систем помощи водителю выполняется на борту из-за требований к задержке и доступности. Облачные сервисы могут дополнять систему картами, телеметрией и обновлениями, но не должны быть единственным звеном немедленной реакции.
- Видеонаблюдение. Камера или локальный шлюз может обнаруживать движение, номера или объекты и отправлять только события. Другие конфигурации хранят или передают видео, поэтому объем и место обработки нужно проверять для конкретной системы.
- Промышленность. Датчики с TinyML-моделями слушают вибрацию станка и замечают признаки поломки раньше, чем она произойдет. Это основа предупредительного обслуживания: ремонт по факту потребности, а не после аварии.
- Медицина и здоровье. Некоторые носимые устройства локально выявляют ритм сердца или падение, но результаты могут синхронизироваться с телефоном или сервисом. Локальный анализ уменьшает передачу сырых данных только тогда, когда так настроен весь продукт.
- Бытовая техника. Пылесосы распознают предметы на полу, стиральные машины подбирают режим под ткань, холодильники отслеживают продукты.
- Сельское хозяйство. Дроны и опрыскиватели с компьютерным зрением различают сорняки и культурные растения прямо в поле, где интернета может не быть вообще.
Общее во всех этих примерах — решение нужно здесь и сейчас, а данные либо слишком объемные, либо слишком чувствительные, чтобы гонять их через сеть.
Агенты и модели на устройствах: куда движется технология
Компактные языковые и мультимодальные модели уже запускаются на смартфонах и ноутбуках. Они могут поддерживать офлайн-функции, но многие ассистенты остаются гибридными и передают часть запросов в облако. Режим обработки и политику данных нужно проверять для конкретного продукта.
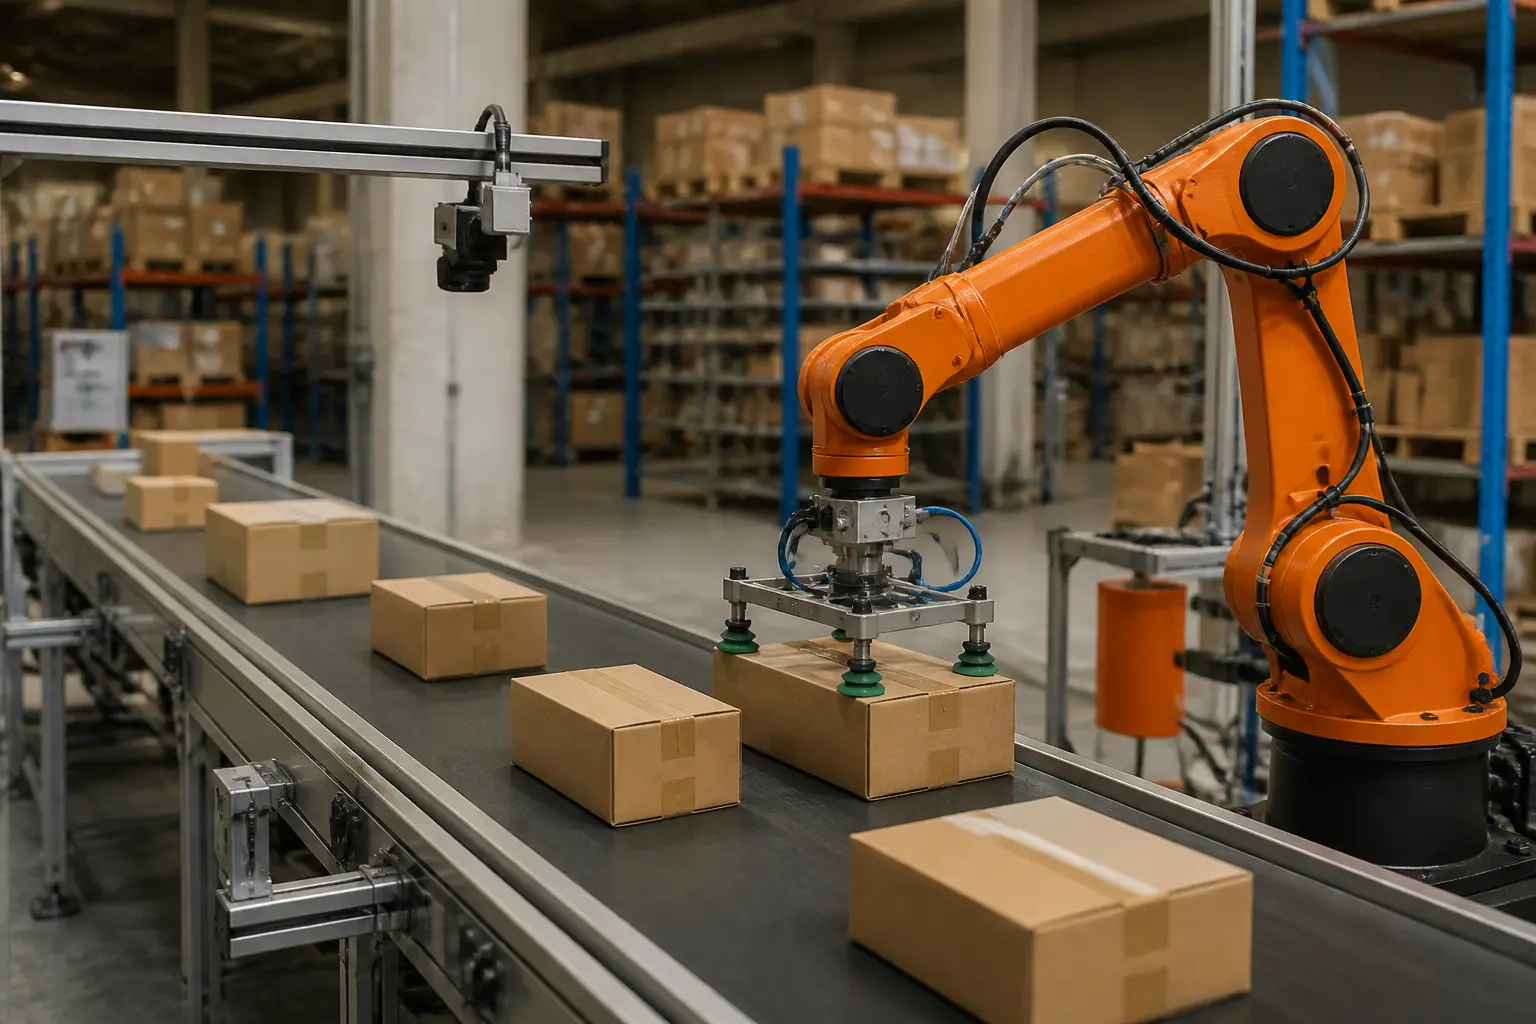
Агенты на устройстве могут выполнять последовательность шагов, использовать камеру или микрофон и управлять функциями системы. В робототехнике локальное компьютерное зрение широко применяется, но связь с сервером может использоваться для координации, журналов, обновлений или более сложных задач.
Федеративное обучение позволяет вычислять обновления на многих устройствах без прямого сбора всех сырых данных в одном месте. Это уменьшает часть рисков, но не гарантирует приватность: обновления также требуют защиты, агрегации и проверки. Возможности локальных моделей растут, однако темп зависит от задачи и класса устройства.
Ограничения, о которых стоит знать
Edge AI не является универсальным ответом, и его слабые места проистекают из тех же причин, что и сильные.
Ресурсы edge-узла ограничены памятью, вычислительной мощностью, тепловым режимом и энергией. На современных телефонах уже работают компактные генеративные модели, но больший контекст, высокая пропускная способность или большие базы знаний часто требуют облака или локального сервера.
Энергопотребление. Постоянная работа нейросети на аккумуляторе — это компромисс между функциональностью и автономностью. Разработчикам приходится тщательно балансировать частоту инференса и сложность модели.
Облачную модель можно обновить централизованно, но новая версия также требует тестирования и развертывания. Модели на устройствах зависят от обновлений приложения или прошивки и совместимости оборудования, поэтому парк версий обычно разнообразнее.
Сжатие может ухудшить точность, оставить ее почти неизменной или иногда улучшить отдельную метрику благодаря дополнительному обучению. Вывод делают по тесту на репрезентативных данных, особенно для критических применений.
Как понять, нужен ли edge-подход в вашем проекте
Если вы выбираете архитектуру для собственного продукта — будь то разработчик или предприниматель, — практическое решение сводится к нескольким вопросам:
- Критична ли задержка? Если реакция должна быть гарантированно быстрой, критическую функцию стоит размещать на устройстве или близком edge-узле и проверять ее при худших условиях сети.
- Будет ли система работать без стабильного интернета? Если да, локальный инференс обязателен.
- Насколько чувствительны данные? Биометрия, медицинские показатели, домашнее видео — весомые аргументы обрабатывать все на устройстве.
- Каков объем сырых данных? Если каждое из тысяч устройств генерирует гигабайты в день, отправка всего в облако экономически бессмысленна.
- Хватит ли мощности модели? Если задача требует большой языковой модели с широким контекстом, edge будет лишь дополнением к облаку.
На практике чаще всего выигрывает гибрид: простой и быстрый слой решений на устройстве, сложная аналитика и обучение — в облаке. Именно по такому принципу построены почти все массовые продукты с edge AI сегодня.
Часто задаваемые вопросы об edge AI
Нужен ли интернет для работы edge AI?
Edge AI может работать без интернета, если модель, нужные данные и логика полностью размещены локально. Но edge-система может зависеть от сети для авторизации, облачной части модели, синхронизации или обновлений, поэтому офлайн-режим не является автоматическим свойством каждого продукта.
Чем edge AI отличается от edge computing?
Edge computing — более широкое понятие: вычисления выполняются ближе к источнику данных, в том числе на устройстве, шлюзе или периферийном сервере. Edge AI — случай, когда на одном из этих узлов работает AI-модель или процесс ее обучения.
Можно ли обучать модели прямо на смартфоне?
Большие модели обычно обучают на серверной инфраструктуре, но небольшие модели можно обучать или дообучать на смартфоне и других edge-узлах. Федеративное и персонализированное обучение также использует локальные вычисления; возможность зависит от модели, данных и ресурсов.
Безопаснее ли edge AI для приватности?
Потенциально да, если система минимизирует передачу данных и правильно защищает устройство. Однако edge создает собственные риски: физический доступ, уязвимые обновления, утечка локального хранилища или параметров модели. NIST рекомендует оценивать приватность и безопасность всей системы.
Заменит ли edge AI облачный искусственный интеллект?
Нет. Эти подходы решают разные задачи и все чаще работают в паре: устройство реагирует мгновенно и приватно, облако обеспечивает обучение, масштаб и самые мощные модели.