Команда хранит терабайты логов в дешёвом объектном хранилище, но для отчёта финансистам данные приходится еженедельно копировать в отдельное хранилище данных. Между двумя системами возникают расхождения, аналитики работают с устаревшими выгрузками, а инженеры тратят время на поддержку конвейеров копирования. Именно эту проблему призвана решить архитектура lakehouse — подход, который пытается дать одной платформе преимущества обоих классических решений.
Ниже разберём термин простыми словами, посмотрим, как lakehouse работает технически, чем он отличается от data lake и data warehouse, и при каких условиях его внедрение действительно имеет смысл.
- Что такое lakehouse простыми словами
- Откуда взялась проблема: ограничения data lake и data warehouse
- Слабые места data lake
- Слабые места data warehouse
- Как работает lakehouse: ключевые слои архитектуры
- Слой хранения
- Табличный слой
- Вычислительный слой
- Слой каталога и управления
- Чем lakehouse отличается от data lake и data warehouse
- Примеры lakehouse-платформ и технологий
- Когда lakehouse уместен, а когда — излишен
- Практические шаги для внедрения
- Часто задаваемые вопросы о lakehouse
- Заменяет ли lakehouse полностью data warehouse?
- Можно ли построить lakehouse в собственном дата-центре, без облака?
- Что такое medallion-архитектура, о которой говорят в контексте lakehouse?
- Подходит ли lakehouse малому бизнесу?
Что такое lakehouse простыми словами
Lakehouse — это архитектура платформы данных, сочетающая в одной системе возможности озера данных (data lake) и хранилища данных (data warehouse). Название сложилось из двух слов: lake (озеро) и warehouse (хранилище). Значение термина прямо отражает суть: вместо двух отдельных инфраструктур компания строит одну, которая умеет и дёшево хранить любые сырые данные, и быстро выполнять структурированные SQL-запросы с гарантиями целостности.
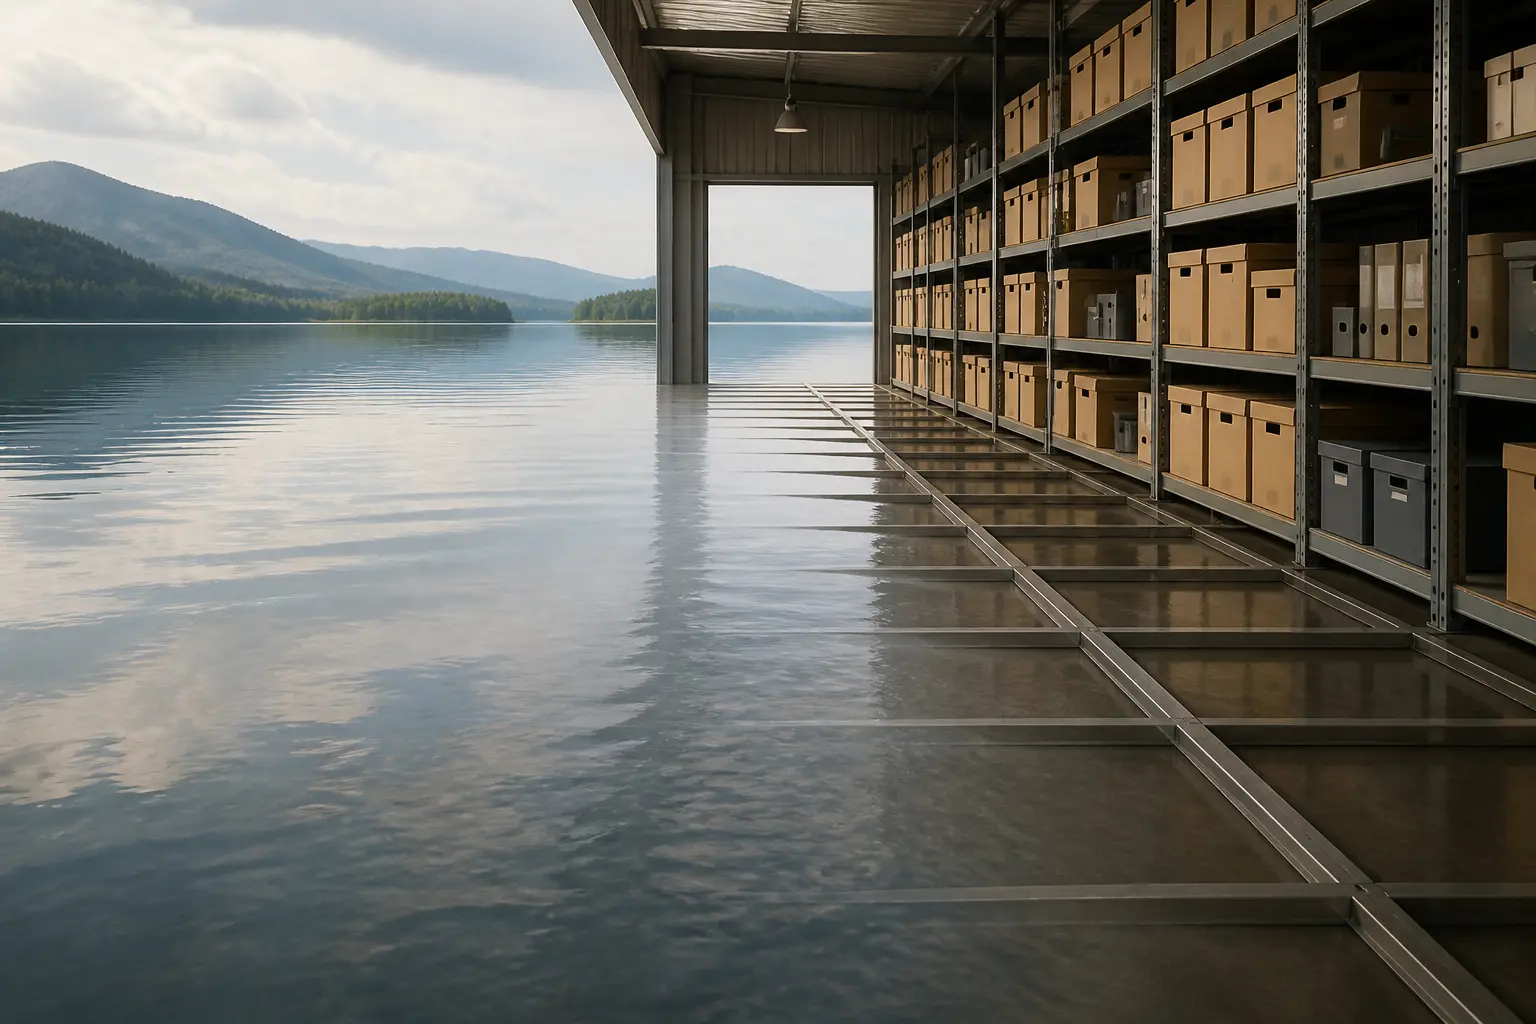
Если объяснять совсем просто: data lake — это большое хранилище, куда можно сбросить файлы любого формата почти без подготовки, но доставать из них полезную информацию трудно и медленно. Data warehouse — наоборот, аккуратная библиотека, где всё структурировано и легко искать, однако положить туда данные можно только после серьёзной обработки, и хранение обходится дорого. Lakehouse предлагает компромисс: файлы лежат в дешёвом открытом хранилище, а поверх них работает слой, который добавляет порядок — таблицы, транзакции, схемы, права доступа.
Термин приобрёл популярность после 2020 года, когда компания Databricks начала активно продвигать эту концепцию как ответ на типичную дилемму крупных организаций: содержать параллельно озеро для машинного обучения и хранилище для бизнес-аналитики слишком дорого и запутанно.
Откуда взялась проблема: ограничения data lake и data warehouse
Чтобы понять, зачем вообще понадобился lakehouse, стоит кратко вспомнить, с чем столкнулись команды, работавшие с классической двухсистемной схемой.
Слабые места data lake
Озёра данных дёшевы и гибки, но без дополнительных механизмов они быстро превращаются в так называемое «болото данных» (data swamp): файлы без схем, дубликаты, невозможность точно обновить или удалить запись, отсутствие гарантий, что данные не повредятся во время сбоя записи. Аналитик, желающий сделать SQL-запрос прямо по файлам Parquet, часто сталкивается с низкой скоростью и непредсказуемыми результатами.
Слабые места data warehouse
Хранилища данных отлично справляются с отчётностью, но имеют собственные ограничения:
- данные нужно сначала структурировать и загрузить через ETL-процессы, что стоит времени и денег;
- полуструктурированные и неструктурированные данные — JSON-логи, изображения, аудио, сырые события — помещаются в них плохо или не помещаются вообще;
- лицензионная модель и привязка к конкретному вендору усложняют масштабирование;
- команды машинного обучения обычно не могут работать с warehouse напрямую и требуют отдельных выгрузок данных.
В результате многие компании оказались в ситуации, когда одни и те же данные хранятся дважды-трижды: в сыром виде в озере, в обработанном — в хранилище, в виде выгрузок — в ноутбуках дата-сайентистов. Каждая копия — это расходы, риск расхождений и дополнительные конвейеры, которые нужно поддерживать.
Как работает lakehouse: ключевые слои архитектуры
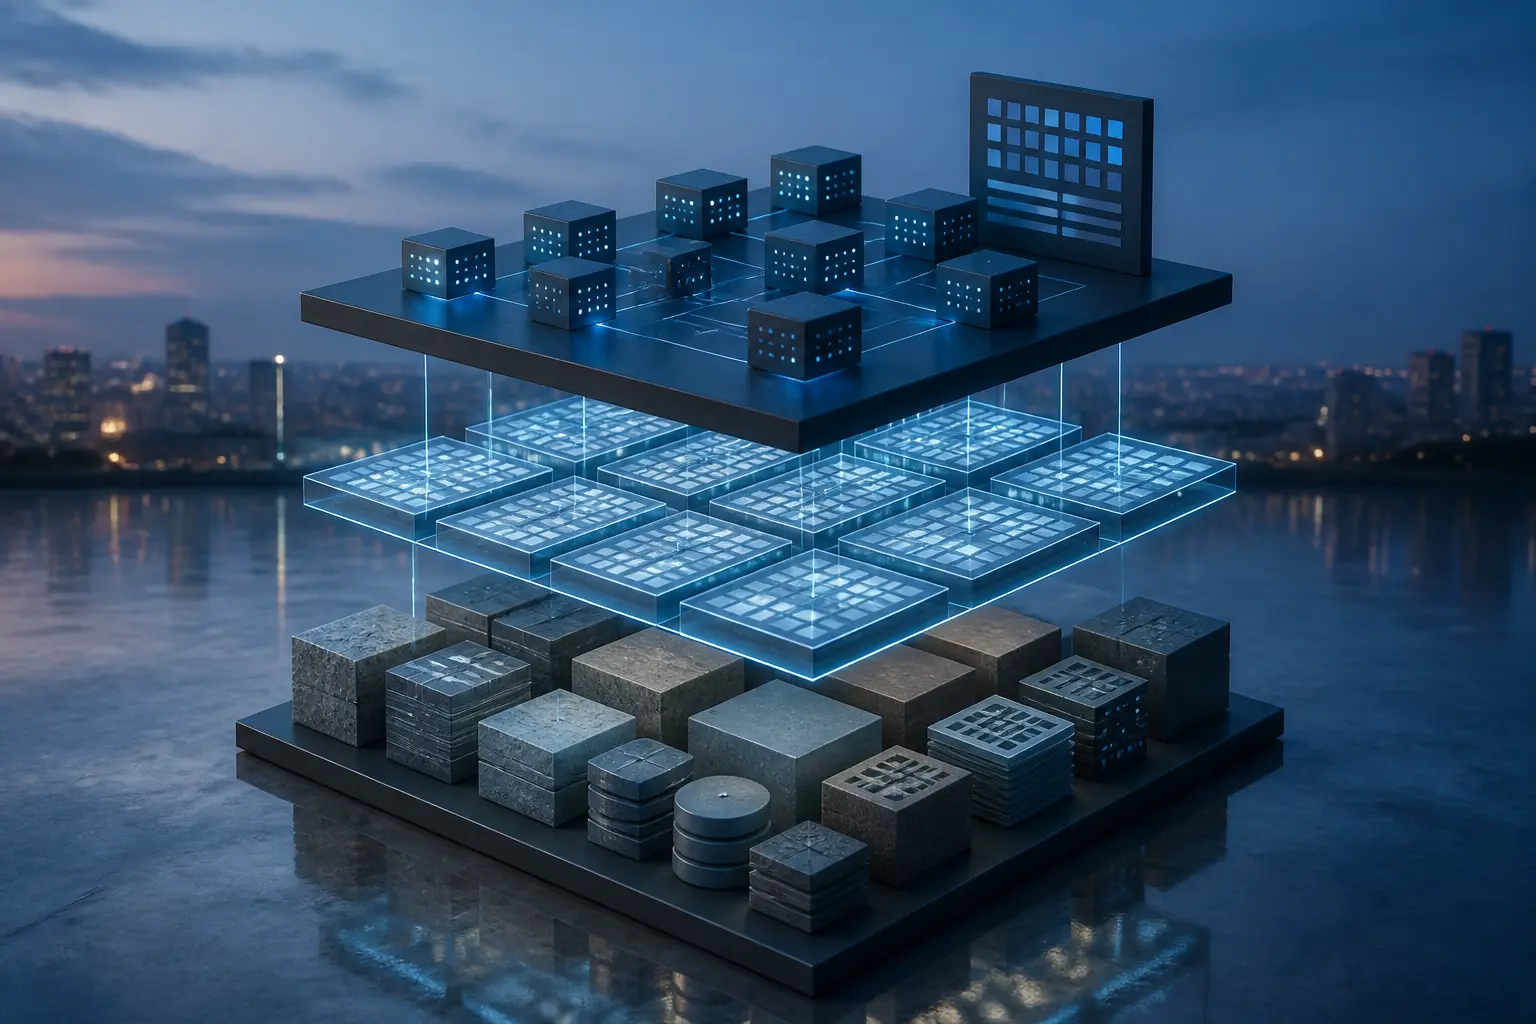
Технически lakehouse — это не отдельный продукт, а набор компонентов, работающих вместе. Понимание этих слоёв помогает оценивать и конкретные платформы, и собственные решения.
Слой хранения
Основа — дешёвое объектное хранилище: Amazon S3, Azure Data Lake Storage, Google Cloud Storage или локальное S3-совместимое решение в собственном дата-центре. Данные хранятся в открытых столбцовых форматах, чаще всего Parquet. Это означает, что файлы не привязаны ни к одному вендору: их может читать любой инструмент, поддерживающий формат.
Табличный слой
Это сердце концепции. Форматы вроде Delta Lake, Apache Iceberg или Apache Hudi добавляют поверх файлов табличную семантику: ACID-транзакции, эволюцию схемы, контроль версий (time travel), эффективные обновления и удаления строк. Именно этот слой превращает кучу файлов в полноценные таблицы, с которыми можно работать почти как с базой данных, не меняя сами файлы под капотом радикальным образом.
Вычислительный слой
К таблицам подключаются различные движки: SQL-движок для BI-запросов, Apache Spark для потоковой и пакетной обработки, библиотеки машинного обучения для тренировки моделей. Важное свойство — вычисления отделены от хранения, поэтому их можно масштабировать независимо: больше ресурсов на период отчётности, меньше ночью.
Слой каталога и управления
Каталог метаданных (например, Unity Catalog, Hive Metastore или облачные аналоги) описывает, какие таблицы существуют, кто имеет к ним доступ, какие колонки содержат персональные данные. Без этого слоя lakehouse повторяет судьбу озера-«болота»: технически данные есть, практически ими управлять невозможно.
Чем lakehouse отличается от data lake и data warehouse
Сравнение трёх подходов удобно свести в таблицу — она хорошо показывает, где именно lakehouse занимает промежуточную позицию.
| Критерий | Data lake | Data warehouse | Lakehouse |
|---|---|---|---|
| Типы данных | Любые, включая неструктурированные | Преимущественно структурированные | Любые, с возможностью структурирования |
| Гарантии целостности | Минимальные | Полные ACID-транзакции | ACID через табличный слой |
| Стоимость хранения | Низкая | Высокая | Низкая |
| Скорость SQL-запросов | Низкая или средняя | Высокая | Средняя-высокая, зависит от движка |
| Пригодность для ML | Высокая | Низкая | Высокая |
| Привязка к вендору | Низкая | Часто высокая | Обычно низкая благодаря открытым форматам |
| Сложность администрирования | Низкая на старте, высокая со временем | Средняя | Средняя-высокая |
Одна из целей lakehouse — уменьшить дублирование и число конвейеров между озером и хранилищем, но результат зависит от архитектуры и миграции. Аналитик и дата-сайентист работают с одними и теми же таблицами: первый — через SQL, второй — через Python-ноутбук. При правильной реализации обе команды могут работать с одним табличным слоем, хотя отдельные копии, кеши и специализированные витрины иногда сохраняются.
Примеры lakehouse-платформ и технологий
Концепцию реализуют разные экосистемы — и облачные сервисы, и открытые проекты. Несколько характерных примеров:
- Databricks Lakehouse Platform — коммерческая платформа вокруг Delta Lake, которая фактически запустила популяризацию термина; сочетает Spark, SQL-эндпоинты и инструменты ML.
- Apache Iceberg — открытый табличный формат, который поддерживают Snowflake, Trino, Flink, Spark и ряд облачных сервисов; часто становится основой независимого от вендора lakehouse.
- Apache Hudi — формат с сильными возможностями инкрементальной обработки, популярный в потоковых сценариях.
- Облачные решения: комбинации вроде S3 + Iceberg + Trino/Athena, Azure Data Lake Storage + Synapse/Fabric, Google Cloud Storage + BigLake позволяют собрать lakehouse из управляемых сервисов.
- Snowflake с поддержкой внешних таблиц Iceberg — пример того, как классические хранилища движутся навстречу концепции со своей стороны.
Заметная тенденция: граница между «хранилищем» и «lakehouse» размывается. Вендоры warehouse добавляют поддержку открытых форматов, а платформы озёр — быстрые SQL-движки. Открытый формат может уменьшить зависимость от вендора, но каталоги, управление доступом и фирменные сервисы всё равно могут создавать привязку.
Когда lakehouse уместен, а когда — излишен
Архитектура не является универсальным ответом. Решение о внедрении стоит принимать, глядя на реальный профиль нагрузок, а не на модный термин в презентации.
Lakehouse даёт заметную выгоду, когда:
- в организации уже существуют и озеро, и хранилище, а расходы на их синхронизацию стали ощутимыми;
- команды аналитики и машинного обучения работают с одними и теми же данными и страдают от расхождений копий;
- есть значительные объёмы полуструктурированных данных — логи, телеметрия, события — наряду с классической отчётностью;
- важна независимость от конкретного вендора и открытость форматов хранения.
А вот спешить не стоит, если потребности просты. Компании, которой достаточно нескольких источников и стандартной BI-отчётности, часто проще и дешевле поднять один управляемый data warehouse. Lakehouse требует квалифицированных инженеров: настройка табличного слоя, каталога, оптимизации запросов и компакции файлов — это работа, которую классическое управляемое хранилище берёт на себя. Экономия на хранении может «съесться» стоимостью команды, если масштаб данных невелик.
Отдельная оговорка касается миграции: переход на lakehouse — это не замена одного инструмента другим, а перестройка конвейеров, практик управления данными и навыков команды. Реалистично планировать поэтапный перенос: сначала новые домены данных, затем постепенно — существующие витрины.
Практические шаги для внедрения
Если решение принято, полезно придерживаться краткого алгоритма, который снижает риск типичных ошибок:
- Проведите аудит существующих данных: какие источники, объёмы, форматы, кто потребители, где сейчас дублируются копии.
- Определите два-три пилотных сценария с измеримым результатом — например, убрать ночное копирование конкретного набора данных в хранилище.
- Выберите табличный формат (Delta Lake, Iceberg, Hudi) с учётом движков, которые уже использует команда.
- Сразу настройте каталог метаданных и модель доступа — откладывать governance «на потом» означает повторить путь к болоту данных.
- Постройте один полный конвейер от сырых данных до BI-отчёта, измерьте стоимость и скорость запросов, и только затем масштабируйте на другие домены.
Ключевой принцип: сначала докажите ценность на маленьком контуре, затем инвестируйте в миграцию всего ландшафта. Масштабная миграция без проверенного пилота повышает риск затрат без измеримого результата.
Часто задаваемые вопросы о lakehouse
Заменяет ли lakehouse полностью data warehouse?
В части сценариев lakehouse может взять на себя функции warehouse, особенно когда отчётность строится поверх того же табличного слоя. Но организации со сложными требованиями к производительности BI или существующими крупными инвестициями в warehouse иногда оставляют обе системы, используя lakehouse как источник.
Можно ли построить lakehouse в собственном дата-центре, без облака?
Да. Понадобится S3-совместимое объектное хранилище (например, MinIO), вычислительный кластер со Spark или Trino и выбранный табличный формат. Облако упрощает старт, но не является обязательным условием архитектуры.
Что такое medallion-архитектура, о которой говорят в контексте lakehouse?
Это практика разделения данных на слои по степени обработки: bronze — сырые данные как есть, silver — очищенные и приведённые к схеме, gold — агрегированные витрины для отчётов. Она не является обязательной частью lakehouse, но хорошо ложится на его возможности, потому что все слои живут в одной системе.
Подходит ли lakehouse малому бизнесу?
Часто нет: при небольших объёмах данных и простых потребностях выгода может не покрыть сложности. Lakehouse раскрывается там, где есть разнородные данные, несколько команд-потребителей и ощутимые расходы на поддержку параллельных систем.