Модель машинного навчання після розгортання поводиться не так, як вебзастосунок. Сервер або працює, або ні, а модель може відповідати швидко й без помилок — і водночас помилятися у змісті: видавати неточні прогнози, зміщуватися в бік однієї групи клієнтів, вигадувати факти. Класичний моніторинг інфраструктури цього не бачить. Саме для таких ситуацій виникла практика, яку називають AI observability — спостережуваність систем штучного інтелекту.
Простими словами, AI observability — це сукупність методів, метрик і інструментів для спостереження за AI-системою в реальній експлуатації: що вона робить, наскільки її результати відповідають визначеним критеріям і які сигнали допомагають розслідувати відхилення. Термін пов’язаний з інженерією надійності, але для AI до логів, метрик і трейсів додаються дані про модель, вхідні дані, оцінки якості та ризики.
- Що таке AI observability простими словами
- Чим спостережуваність моделей відрізняється від класичного моніторингу
- Які сигнали збирають системи AI observability
- Технічні метрики сервісу
- Моніторинг вхідних даних
- Моніторинг передбачень і якості
- Сигнали, специфічні для LLM і агентів
- Дрейф даних і дрейф концепції: головні вороги моделі в продакшені
- Як працює AI observability на практиці
- Інструменти та приклади з реальної практики
- З чого почати впровадження: короткий чекліст
- Часті запитання про AI observability
- Чи потрібна AI observability, якщо модель лише одна і трафік невеликий
- Чим AI observability відрізняється від MLOps
- Чи можна відстежувати якість LLM без ручної розмітки
- Що спостерігати в агентних системах понад звичайне
Що таке AI observability простими словами
Уявіть банківську модель скорингу, яка схвалює чи відхиляє заявки на кредит. Після запуску вона щодня обробляє тисячі заявок. Технічно все працює: запити приймаються, відповіді повертаються за мілісекунди. Але через пів року портрет заявників змінився — наприклад, через економічну кризу чи новий маркетинговий канал. Модель продовжує працювати, проте її прогнози дедалі менше відповідають реальності, і ніхто цього не помічає, доки не зросте рівень прострочених кредитів.
AI observability могла б раніше показати зміну профілю заявників або розподілу прогнозів, але сам статистичний сигнал не доводить падіння точності. Для висновку потрібні фактичні результати, перевірка сегментів і контекст бізнес-процесу.
Значення терміна виходить за межі простого дашборда з графіками. Повноцінна спостережуваність включає:
- збір необхідних сигналів — характеристик вхідних даних, передбачень, затримок, помилок і версій компонентів; тексти запитів та відповідей зберігають лише за потреби, з урахуванням мінімізації даних, доступу й строків зберігання;
- обчислення похідних метрик — точності, дрейфу, зміщення, частки галюцинацій;
- діагностику — можливість простежити конкретну відповідь до конкретних вхідних даних, версії моделі й промпта;
- алертинг — повідомлення, коли показники деградують;
- аудит — історію поведінки для розслідування інцидентів і регуляторних вимог.
На відміну від простого логування, observability поєднує сигнали з контекстом, щоб звузити коло можливих причин і відтворити інцидент. Вона не гарантує автоматичної відповіді на запитання «чому»: причинний висновок часто потребує експерименту, доменного аналізу та фактичних міток.
Чим спостережуваність моделей відрізняється від класичного моніторингу
У традиційному DevOps моніторинг перевіряє заздалегідь відомі режими відмови: сервер не відповідає, диск заповнений, база даних перевантажена. Помилка визначена однозначно — або відповідь є, або її немає.
З моделями машинного навчання ситуація інша. Модель не «падає» — вона тихо деградує. Відповідь надходить вчасно, код відповіді 200, але зміст передбачення неправильний. Більше того, саме поняття «неправильний» часто неможливо перевірити миттєво: чи справді клієнт не поверне кредит, стане відомо лише через кілька місяців. Ця затримка зворотного зв’язку — одна з головних причин, чому моделі потребують окремого підходу до спостереження. Саме тому для таких систем окремо вибудовують процес model evaluation із власними наборами тестів і метриками.
Друга відмінність — залежність якості від даних, а не від коду. Код моделі після розгортання не змінюється, але світ довкола змінюється постійно. Тому AI observability стежить не лише за сервісом, а й за статистичними властивостями потоку даних, який цей сервіс обробляє.
Третя відмінність стосується генеративних систем. Для великих мовних моделей і агентів поняття коректності розмите: на одне питання може бути десять прийнятних відповідей і ще сто — правдоподібних, але хибних. Оцінити якість такої відповіді автоматично складніше, ніж перевірити код помилки, і це породило окремий напрям — LLM observability.
Які сигнали збирають системи AI observability
Практична система спостереження за моделлю зазвичай працює з кількома шарами сигналів, і кожен шар відповідає за свій клас проблем.
Технічні метрики сервісу
Це той самий класичний моніторинг: затримка відповіді, пропускна здатність, частота помилок, споживання пам’яті та GPU, вартість інференсу. Для LLM сюди додають кількість токенів на запит і витрати на API — у комерційних моделей рахунок може зростати непомітно швидко, якщо промпт роздувається або агент потрапляє в цикл повторних викликів.
Моніторинг вхідних даних
Тут відстежують розподіли ознак: середні значення, частоти категорій, частку пропущених значень, появу нових категорій, яких не було в навчальній вибірці. Якщо модель навчалася на даних, де вік клієнтів переважно 25–45 років, а тепер половина заявок — від людей старших за 60, це привід для тривоги навіть без перевірки точності: модель працює поза межами того, що вона бачила.
Моніторинг передбачень і якості
Зміна розподілу самих передбачень — теж симптом. Якщо антифрод-модель раптом почала позначати як підозрілі 30% транзакцій замість звичних 3%, щось пішло не так, навіть якщо реальні мітки шахрайства ще невідомі. Коли ж фактичні результати стають доступними (клієнт повернув кредит, користувач позначив відповідь як некорисну), обчислюють повноцінні метрики якості — точність, precision, recall, MAE залежно від типу задачі.
Сигнали, специфічні для LLM і агентів
Для генеративних систем і агентів, які викликають інструменти та моделі ланцюжком, збирають додаткові дані:
- повні трейси запиту — промпт, контекст, версії моделі, проміжні кроки агента, виклики зовнішніх інструментів;
- оцінки якості відповідей — релевантність контексту, фактична обґрунтованість (groundedness), наявність галюцинацій;
- зворотний зв’язок користувачів — оцінки, скарги, повторні запитання;
- безпекові сигнали — спроби prompt injection, витік персональних даних, токсичні відповіді.
Оцінку відповідей LLM часто виконує інша модель (підхід LLM-as-a-judge) або набір автоматичних перевірок, бо ручна розмітка тисяч відповідей на день неможлива. Це дає наближену, але оперативну картину якості.
Дрейф даних і дрейф концепції: головні вороги моделі в продакшені
Найчастіша причина деградації моделі — не помилка в коді, а дрейф. У практиці розрізняють кілька його видів, і системи observability навчені виявляти кожен окремо.
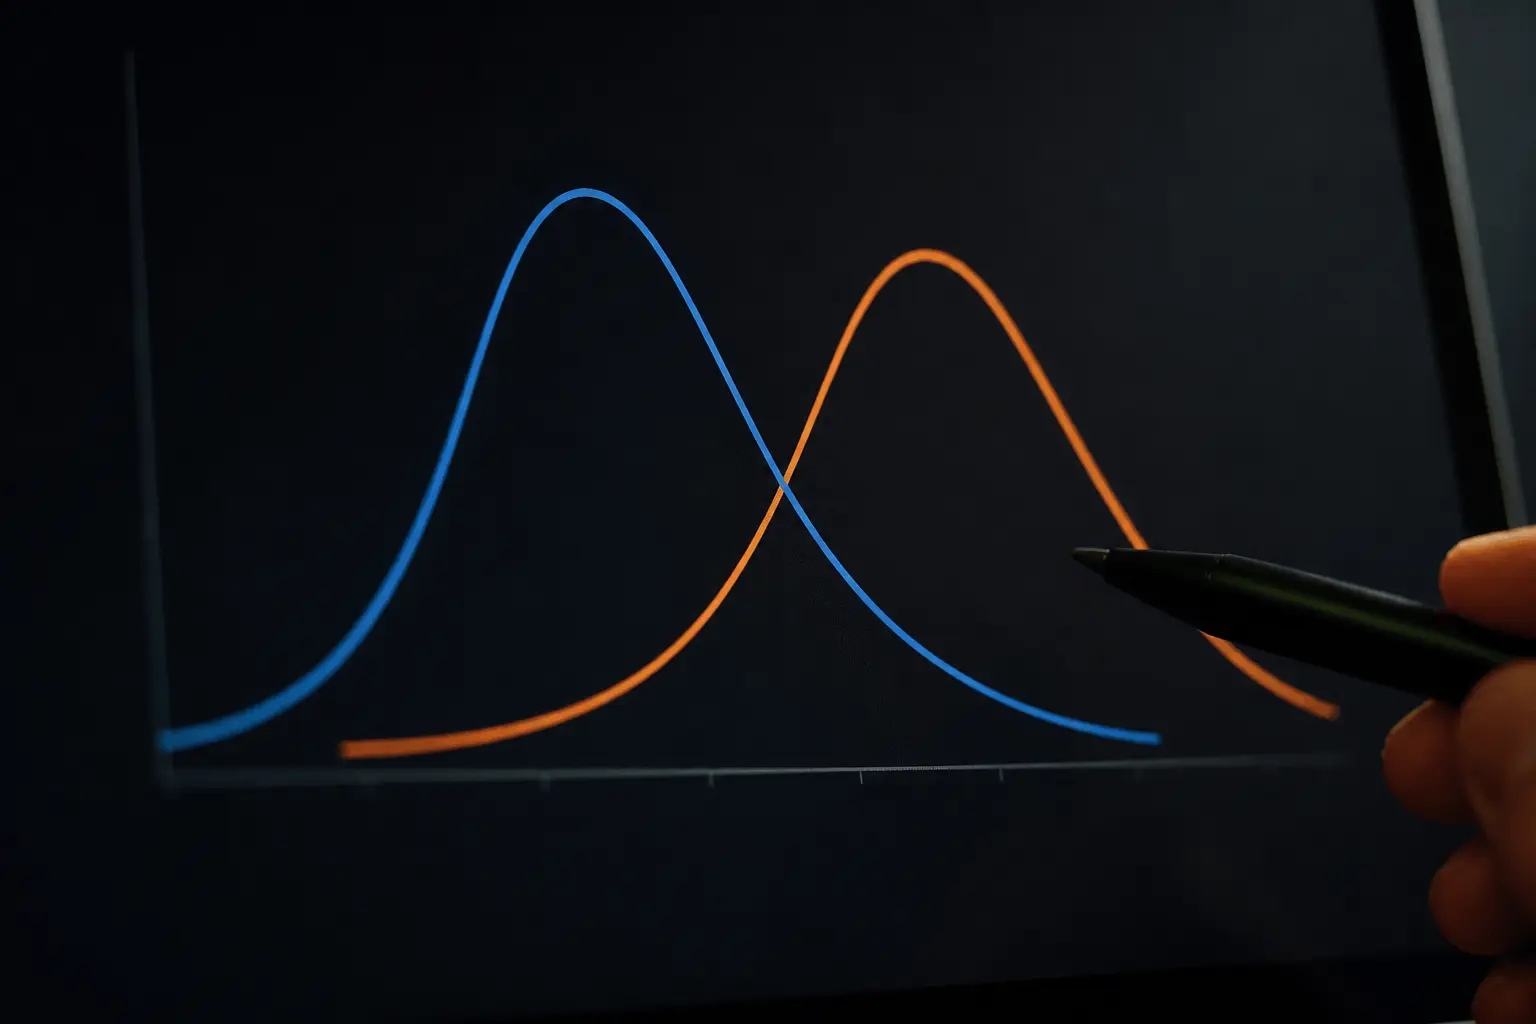
Дрейф даних (data drift) — загальна назва зміни статистичних властивостей даних. Коваріатний зсув — окремий випадок, коли змінюється розподіл вхідних ознак. Такі зміни виявляють порівнянням поточних і базових розподілів за доречними тестами та відстанями; PSI і дивергенція Кульбака—Лейблера мають різні припущення й не є взаємозамінними універсальними тестами.
Дрейф концепції (concept drift) — зміна самого зв’язку між ознаками та результатом. Наприклад, шахраї змінюють тактику, і старі ознаки перестають вказувати на шахрайство, хоча розподіл самих ознак може майже не змінитися. Цей тип дрейфу неможливо побачити без фактичних міток, тому він найнебезпечніший: єдиний надійний спосіб його виявити — відстежувати метрики якості на нових даних із підтвердженими результатами.
Дрейф міток означає зміну розподілу цільової змінної, наприклад базової частоти шахрайства. Реальні системи можуть одночасно мати кілька типів зсуву, а вибір реакції — зміна порогу, перевірка даних, перенавчання або зупинка — залежить від ризику й підтвердженої причини.
Важливе застереження: алерти про дрейф — це статистичні сигнали, а не вирок. Частина спрацьовувань буде хибною, особливо на малих обсягах даних. Занадто чутлива система вчить команду ігнорувати сповіщення, тому пороги налаштовують поступово, дивлячись на реальні інциденти.
Як працює AI observability на практиці
Типовий робочий цикл починається з документованих еталонних показників і критеріїв прийнятності. У продакшені збирають мінімально необхідні сигнали разом із версіями моделі, промпта, даних та інструментів. Чутливі поля, персональні дані й секрети потрібно маскувати або не записувати; доступ і строк зберігання визначають політикою ризику.
Далі система спостереження у потоці або за розкладом обчислює поточні статистики й порівнює їх із базовими. Перевищення порогу створює алерт, який потрапляє команді в месенджер або систему інцидентів. Інженер відкриває трейс проблемних запитів і може пройти весь ланцюжок: які дані надійшли, що відповіла модель, чи змінилася поведінка на конкретному сегменті — наприклад, тільки для мобільних користувачів чи тільки для нового регіону.
Для агентних систем трасування особливо важливе. Агент, який сам планує кроки й викликає інструменти, може помилитися на третьому із семи кроків, і без повного трейсу знайти це майже неможливо. Запис кожного проміжного рішення дозволяє відтворити сценарій і зрозуміти, де логіка зламалася — у промпті, у даних чи у самій моделі.
Останній елемент циклу — дія. За результатами розслідування команда або коригує пороги й фільтри, або оновлює дані, або запускає перенавчання, або відкочує версію. Система observability цінна лише тоді, коли сигнал з неї закінчується конкретним рішенням, а не черговим графіком, на який ніхто не дивиться.
Інструменти та приклади з реальної практики
Інструменти умовно поділяють на моніторинг моделей і даних, трасування та оцінювання LLM/агентів і загальні платформи observability. Серед відомих прикладів — Evidently, whylogs, NannyML, Fiddler, Langfuse, LangSmith, Arize Phoenix, W&B Weave, Datadog і Grafana. Це приклади різних за ліцензією та функціями продуктів, а не один клас відкритих бібліотек; актуальні можливості треба перевіряти перед вибором.
Кілька характерних прикладів застосування:
- Фінтех відстежує дрейф ознак скорингової моделі та частку схвалень за сегментами; різке зростання відмов у певній віковій групі стає сигналом перевірити зміщення моделі.
- Служба підтримки з LLM-чатботом оцінює кожну відповідь на релевантність і фактичність; падіння середньої оцінки після зміни промпта дозволяє швидко відкотити зміну.
- Ритейлер моніторить модель прогнозування попиту і помічає дрейф концепції після зміни логістики, перш ніж помилки прогнозу перетворяться на порожні полиці.
- Гіпотетичний приклад: команда агентної системи за трейсами бачить повторні виклики одного інструмента, які збільшують затримку й витрати. Конкретний відсоток зациклення треба обчислювати на власному трафіку, а не переносити з умовного сценарію.
У цих сценаріях спільна мета — скоротити час між появою відхилення, його виявленням і керованою реакцією. Observability сама не гарантує запобігання збиткам: користь залежить від якості метрик, міток, порогів і процесу реагування. NIST AI RMF прямо рекомендує плани построзгортального моніторингу, відповідальних осіб та механізми реагування.
З чого почати впровадження: короткий чекліст
Для команди, яка тільки розгорнула першу модель, не потрібно одразу купувати платформу. Розумна послідовність виглядає так:
- Почніть логувати вхідні дані, передбачення та версію моделі з першого дня продакшену — це неминуче знадобиться для будь-якого розслідування.
- Визначте 3–5 ключових метрик: одну технічну (затримка або вартість), одну-дві за даними (дрейф основних ознак) і одну за якістю, навіть якщо вона обчислюється із затримкою.
- Зафіксуйте базовий ряд на етапі навчання, інакше нема з чим порівнювати.
- Налаштуйте алерти з консервативними порогами та власником для кожного алерту — сповіщення без відповідального не працює.
- Для LLM додайте трасування запитів і хоча б просту автоматичну оцінку відповідей, перш ніж масштабувати трафік.
- Періодично переглядайте, які алерти були хибними, а які інциденти система пропустила, і коригуйте пороги. Частоту перегляду визначайте за ризиком, обсягом змін і вимогами галузі; універсального квартального інтервалу немає.
Головна помилка на старті — намагатися відстежувати все одразу. Система спостереження, яка генерує сотні сповіщень на день, гірша за її відсутність: команда перестає реагувати. Краще мати п’ять метрик із зрозумілою реакцією на кожну, ніж п’ятдесят графіків без власників.
Часті запитання про AI observability
Чи потрібна AI observability, якщо модель лише одна і трафік невеликий
Базовий рівень версіонування й журналювання потрібен навіть для однієї моделі, але він не є безкоштовним і не повинен означати збереження всіх сирих запитів. Обсяг телеметрії визначають за ризиком, вартістю, приватністю та вимогами безпеки. Повні платформи виправдані, коли модель істотно впливає на гроші, права, безпеку або досвід користувачів.
Чим AI observability відрізняється від MLOps
MLOps — це ширша дисципліна: конвеєри навчання, версіонування, розгортання, тестування моделей. Observability — одна з її складових, відповідальна за те, що відбувається з моделлю після розгортання. Можна мати MLOps-процеси без глибокої спостережуваності, але це означає керувати моделлю наосліп.
Чи можна відстежувати якість LLM без ручної розмітки
Частково. Автоматичні оцінювачі — евристики, перевірки на вихідні дані, моделі-судді — дають оперативну картину, але вони самі помиляються. Практичний компроміс: автоматична оцінка всього потоку плюс регулярна ручна перевірка невеликої випадкової вибірки для калібрування.
Що спостерігати в агентних системах понад звичайне
Повні трейси ланцюжка кроків, кількість і послідовність викликів інструментів, частку зациклень і невдалих спроб, а також підсумкову вартість виконання задачі. Саме агенти найчастіше «несподівано» споживають бюджет на токени через повторні виклики, які без трасування непомітні.