Коли ви вводите в пошук «як відновити доступ до акаунта», а система знаходить статтю під назвою «Відновлення пароля: покрокова інструкція», — це не магія і не вдача. Слова в запиті й у тексті різні, але смисл збігається, і саме за смислом, а не за літерами, сучасний AI навчився шукати. Технологія, що стоїть за цим, називається vector database — векторна база даних. Розберімося, що це таке, як вона працює зсередини і чому без неї сьогодні неможливі ані чат-боти, що відповідають по документах компанії, ані пошук схожих фото, ані розумні рекомендації.
- Що таке vector database простими словами
- Від чого відштовхується пошук за смислом: ембединги
- Як працює vector database зсередини
- Запис і індексація
- Метрики близькості
- Приблизний пошук і його цінність
- Чим vector database відрізняється від звичайних баз даних
- Де векторні бази застосовуються на практиці
- Які vector database існують і як обрати
- Інфраструктура: хмари, дата-центри і ресурси
- Обмеження та типові помилки
- Поширені запитання
- Чи можна обійтися без векторної бази для невеликого проєкту?
- Чим векторний пошук відрізняється від повнотекстового?
- Скільки коштує векторна база?
- Чи підходить vector database для структурованих даних?
- Як почати працювати з векторною базою: короткий алгоритм
Що таке vector database простими словами
Vector database — це спеціалізована база даних, що зберігає інформацію у вигляді векторів, тобто масивів чисел, і вміє швидко знаходити серед мільйонів таких масивів ті, що найближчі один до одного за смислом. Термін простими словами: уявіть карту міста, де кожен текст, зображення чи звук має свою точку з координатами. Точки з близьким змістом опиняються поруч: статті про паролі — біля статей про акаунти, фото котів — біля фото кошенят. Векторна база даних зберігає цю «карту» і шукає на запитання: які точки лежать найближче до заданої? Саме тому векторні бази дедалі частіше розгортають у хмарі, адже cloud computing з моделями IaaS, PaaS і SaaS дає змогу масштабувати обчислення під навантаження.
Значення слова «вектор» тут математичне: це просто упорядкований набір чисел, наприклад [0.12, -0.87, 0.44, …]. Тільки координат не дві-три, як на карті, а сотні чи тисячі. Кожна вісь такого багатовимірного простору відповідає якомусь прихованому смисловому ознаку, яке модель навчилася розрізняти. Людина в цих числах нічого не прочитає, але для алгоритму відстань між двома векторами — це відстань між двома смислами.
Звичайна база даних відповідає на питання «знайди записи, де поле дорівнює X». Векторна база відповідає на інше питання: «знайди записи, найбільш схожі на X». Ця різниця принципова. Точний збіг працює, коли ви знаєте точне значення — номер замовлення, артикул, дату. Але мова, зображення та поведінка людей так не працюють: один і той самий смисл виражається десятками способів, і для них потрібен пошук за подібністю.
Від чого відштовхується пошук за смислом: ембединги
За межами бази даних існує ще один обов’язковий елемент — модель ембедингів. Це нейронна мережа, натренована перетворювати текст, зображення, аудіо або відео у вектор фіксованої довжини. На вхід — речення «кіт спить на дивані», на вихід —, скажімо, 768 чисел. Речення «кошеня дрімає на канапі» дасть дуже близький набір чисел, хоча жодне слово не збігається. А «біржові індекси впали» — набір зовсім інший, віддалений від котячої тематики.
Моделі ембедингів тренують на величезних корпусах даних так, щоб схожі за змістом об’єкти отримували близькі вектори. Це і є та «карта смислів», про яку йшлося вище: модель задає систему координат, а vector database лише зберігає точки та вміє по них ефективно шукати. Важливо розуміти поділ праці: якість смислового пошуку на 80% визначається моделлю ембедингів, а база відповідає за швидкість, масштаб і зручність роботи. Загалом векторні бази — лише одна з ланок ширшого ландшафту, де технології та інновації охоплюють AI, хмари, чипи й кібербезпеку.
Ембединги бувають різної розмірності — типово від 384 до 3072 чисел на об’єкт, залежно від моделі. Більша розмірність може кодувати тонші відтінки змісту, але коштує дорожче: більше пам’яті, повільніші обчислення. На практиці часто обирають компроміс, а деякі сучасні моделі дозволяють обрізати вектор до меншої довжини майже без втрати якості.
Як працює vector database зсередини
Робота векторної бази складається з трьох етапів: запис, індексація та пошук. Розглянемо кожен.
Запис і індексація
Коли документ потрапляє в систему, він спочатку проходить через модель ембедингів і перетворюється на вектор. База зберігає цей вектор разом із метаданими: ідентифікатором документа, текстом-джерелом, датою, тегами. Але просто зберігати мало — треба шукати. Наївний підхід «порівняти запит із кожним вектором» працює на тисячах записів, проте на сотнях мільйонів він би займав хвилини на один запит. А коли векторний пошук поєднують із потоковими даними, відкриваються можливості real-time analytics для аналізу даних майже миттєво.
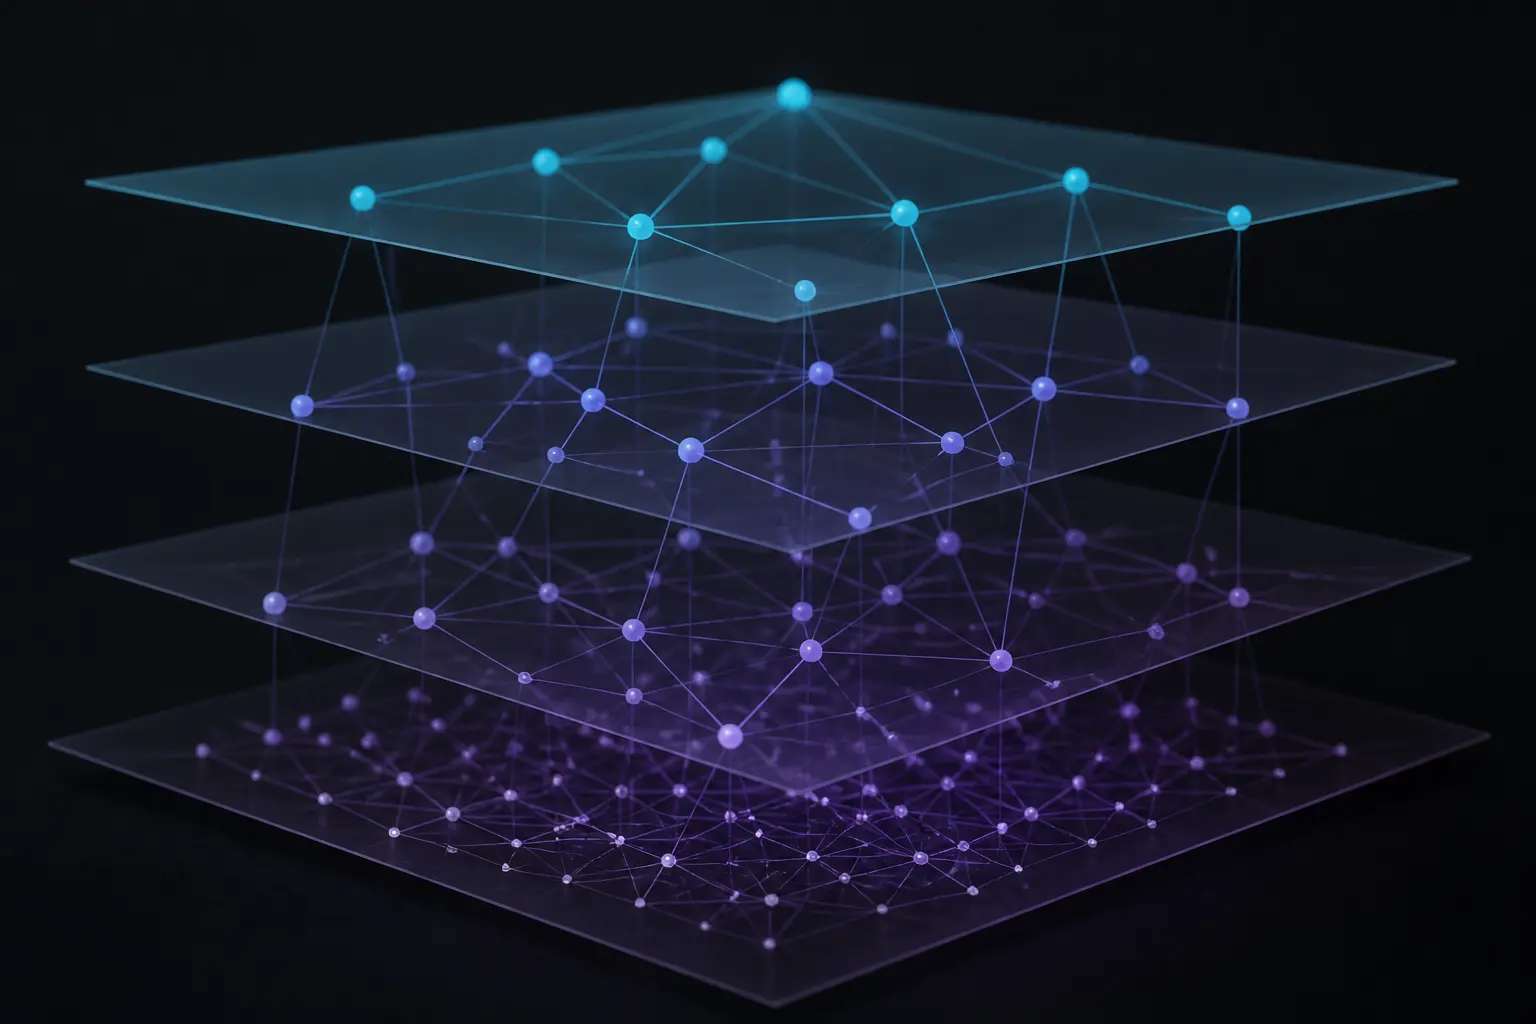
Тому векторні бази будують спеціальні індекси — структури даних, що дозволяють відсіяти 99% непотрібних кандидатів, не рахуючи відстань до них. Один із поширених алгоритмів — HNSW (ієрархічні навіговані маленькі світи): вектори організовуються у багатошаровий граф, де верхні шари дають грубу навігацію простором, а нижні — точне уточнення. Пошук у такому графі нагадує спуск гірською дорогою: спочатку швидкі широкі кроки, потім дедалі дрібніші — і за десятки мілісекунд ви біля найближчих сусідів. Існують й інші сімейства алгоритмів, наприклад IVF (кластеризація простору на комірки) або дискові індекси на кшталт DiskANN для великих обсягів.
Метрики близькості
Щоб сказати, який вектор «ближчий», потрібна міра відстані. Найчастіше використовують косинусну близькість — кут між векторами: чим менший кут, тим ближчі смисли, незалежно від довжини векторів. Також застосовують евклідову відстань (пряма лінія між точками) та скалярний добуток. Вибір метрики зазвичай продиктований моделлю ембедингів: якщо модель тренувалася під косинусну схожість, базу треба налаштувати так само, інакше результати будуть спотворені.
Приблизний пошук і його цінність
Ключовий факт про векторні бази: для великих наборів вони часто використовують приблизний пошук найближчих сусідів (ANN), але деякі системи підтримують і точний пошук. Приблизний індекс обмінює частину повноти пошуку (recall) на швидкість і пам’ять. Якість не має універсальних 98%: її вимірюють на власних запитах за обраних налаштувань. Прискорення, затримку та втрату recall вимірюють на власних даних: результат залежить від індексу, параметрів, фільтрів і обладнання. Прийнятний компроміс визначають вимоги конкретного продукту. Зростання попиту на такі системи вже помітно впливає на глобальні IT-витрати 2026 та структуру ринку AI-інфраструктури.
Чим vector database відрізняється від звичайних баз даних
Реляційні бази оперують точними значеннями та зв’язками: рівність, діапазони, об’єднання таблиць. Повнотекстові системи шукають за збігом слів та їхніх форм. Векторні бази оперують близькістю у багатовимірному просторі. Порівняння за ключовими ознаками:
| Критерій | Реляційна БД | Повнотекстовий пошук | Vector database |
|---|---|---|---|
| Тип запиту | Точна умова (WHERE) | Збіг слів і форм | Смислова близькість |
| Основні дані | Структуровані рядки | Текст | Вектори + метадані |
| Індекс | B-tree, hash | Інвертований індекс | ANN-індекс (HNSW, IVF) |
| Розуміє синоніми | Ні | Частково, через словники | Залежить від embedding-моделі |
| Працює з медіа | Ні | Ні | Так: фото, аудіо, відео |
| Типові сценарії | Транзакції, облік | Пошук за ключовими словами | Семантичний пошук, RAG |
Це не конкуренти, а доповнення. У реальних системах вони працюють разом: замовлення зберігається в PostgreSQL, каталог індексується пошуковим рушієм, а смисловий пошук і рекомендації обслуговує векторна база. Більше того, межі розмиваються: розширення pgvector для PostgreSQL дозволяє зберігати вектори просто в реляційній базі, що для невеликих проєктів виявляється практичнішим, ніж окрема система.
Де векторні бази застосовуються на практиці
Найгучніший сценарій останніх років — RAG, retrieval-augmented generation. Велика мовна модель сама по собі знає лише те, що було в її навчальних даних, і схильна впевнено вигадувати факти. Схема RAG працює так: документи компанії розбиваються на фрагменти, перетворюються на вектори й складаються у vector database; коли користувач ставить запитання, система знаходить найближчі за смислом фрагменти й передає їх моделі як контекст. Модель відповідає, спираючись на реальні документи, а не на власну «пам’ять». Так будують корпоративних помічників, боти підтримки з базою знань, юридичні й медичні довідкові системи.
Інші поширені приклади застосування:
- Семантичний пошук у магазинах і каталогах: запит «щось тепле для походу восени» знаходить фліски й термобілизну без точного збігу слів.
- Рекомендаційні системи: товари, фільми чи музика з близькими векторами до історії користувача — це і є «схоже на те, що вам сподобалося».
- Пошук зображень та відео: по фото або опису знаходяться візуально схожі об’єкти; так працює пошук дублікатів і модерація контенту.
- Виявлення шахрайства та аномалій: транзакція чи дія, чий вектор далекий від типової поведінки клієнта, отримує підвищену увагу.
- Дедуплікація: служби підтримки автоматично склеюють звернення про ту саму проблему, сформульовані по-різному.
Спільне у всіх цих сценаріїв одне: дані неструктуровані, а «схожість» важливіша за точний збіг. Саме тому зростання кількості AI-продуктів так різко підняло попит на векторну інфраструктуру.
Які vector database існують і як обрати
Ринок поділяється на кілька категорій. Спеціалізовані векторні бази — Pinecone, Weaviate, Qdrant, Milvus, Chroma — побудовані навколо векторного пошуку й дають максимум можливостей: гнучкі індекси, фільтрацію за метаданими, горизонтальне масштабування. Розширення класичних СУБД, насамперед pgvector для PostgreSQL, дозволяють тримати вектори поруч із основними даними без окремої системи. Пошукові рушії — Elasticsearch, OpenSearch — додали векторний пошук до повнотекстового, що зручно для гібридних сценарій. Нарешті, хмарні провайдери пропонують керовані сервіси у власних хмарах, де векторні сховища інтегровані з платформами машинного навчання.
Обираючи рішення, дивіться на кілька практичних параметрів:
- Обсяг і темп зростання. pgvector або локальна бібліотека FAISS можуть бути достатніми, але межа залежить від розмірності, навантаження, фільтрів, latency, оновлень і доступної пам’яті. Сотні мільйонів векторів вимагають розподіленої системи.
- Вимоги до затримки. Чат-бот у реальному часі потребує відповідей за десятки мілісекунд; пакетна обробка архіву — ні.
- Фільтрація за метаданими. У бізнес-задачах майже завжди треба шукати «схожі документи, але лише цього клієнта й лише за цей рік». Якість поєднання векторного пошуку з фільтрами — важливий відмітний ознака систем.
- Модель розгортання. Власна інфраструктура, приватна хмара чи керований сервіс — питання вартості, вимог безпеки даних і наявності команди.
- Екосистема: наявність SDK під ваш стек, інтеграції з фреймворками на кшталт LangChain чи LlamaIndex, зрілість документації.
Реалістична порада: починайте з найпростішого варіанта, що закриває задачу. Перехід від pgvector до спеціалізованої бази на етапі зростання — нормальний шлях, а переплачувати за розподілений кластер заради двох мільйонів векторів — ні.
Інфраструктура: хмари, дата-центри і ресурси
Векторний пошук — ресурсомістке навантаження, і це варто враховувати при плануванні інфраструктури. Продукти з HNSW використовують різні схеми зберігання, кешування й завантаження графа. Нестиснений масив самих векторів має значний обсяг: мільярд векторів розмірністю 1536 у форматі float — це терабайти RAM до врахування структури графа. Тому великі векторні кластери — це сервери з сотнями гігабайтів пам’яті, швидкі NVMe-диски для дискових індексів та передбачувана мережева затримка між вузлами.
Хмарні провайдери закривають цю потребу двома шляхами: керованими векторними сервісами, де інфраструктура невидима для клієнта, та віртуальними машинами з великою пам’яттю для самостійного розгортання Milvus чи Qdrant. Окреме питання — обчислення ембедингів: перетворення мільйонів документів у вектори вигідно робити на GPU, тоді як сам пошук за індексом зазвичай виконується на CPU. Географія дата-центрів теж має значення: для інтерактивних застосунків векторну базу розміщують у тому ж регіоні, що й застосунок, щоб не додавати десятки мілісекунд мережевої затримки до кожного запиту.
Технології в цій галузі розвиваються швидко: з’являються квантовані індекси, що можуть суттєво стискати вектори, але коефіцієнт стиснення і втрата recall залежать від методу та даних, дискові алгоритми, що знімають залежність від дорогої RAM, і гібридний пошук, що комбінує векторну близькість із класичним збігом ключових слів. Інновації тут рухаються простим стимулом: кожен заощаджений гігабайт пам’яті на мільярді векторів — це відчутні гроші.
Обмеження та типові помилки
Векторна база — не універсальна відповідь, і корисно знати її слабкі місця. По-перше, якість результатів повністю залежить від моделі ембедингів: модель, натренована переважно на англійських текстах, буде посередньо розрізняти українські синоніми. По-друге, точні значення — номери, коди, рідкісні власні назви — векторний пошук часто «розмиває»: він шукає схожість, а не збіг. Саме тому гібридний пошук (вектори плюс ключові слова) став практичним стандартом.
Поширені помилки команд, які починають працювати з vector database:
- Занадто великі фрагменти тексту при індексації: вектор усереднює смисл цілого фрагмента, і конкретне запитання «тоне» в загальному тексті. Розмір фрагмента треба підбирати експериментально з урахуванням моделі, структури документа, перекриття та якості відповідей.
- Зміна моделі ембедингів без переіндексації: вектори різних моделей живуть у різних просторах і непорівнювані між собою.
- Ігнорування метаданих: без фільтрів система повертає глобально схожі, але не релевантні конкретному користувачеві результати.
- Очікування детермінованості: приблизний пошук може давати трохи різний порядок результатів між запитами — це нормально, а не збій.
Поширені запитання
Чи можна обійтися без векторної бази для невеликого проєкту?
Так. Для десятків тисяч документів достатньо бібліотеки FAISS усередині застосунку або pgvector у наявній базі PostgreSQL. Окрема спеціалізована система виправдана, коли з’являються мільйони векторів, високе навантаження або потреба в розподіленому зберіганні.
Чим векторний пошук відрізняється від повнотекстового?
Повнотекстовий пошук шукає збіг слів і їхніх форм, векторний — близькість смислів. Перший краще знаходить точні назви та терміни, другий — синоніми та перефразування. На практиці найкращі результати дає комбінація обох.
Скільки коштує векторна база?
Рішення з відкритим кодом — Qdrant, Weaviate, Milvus, pgvector — безкоштовні, витрати йдуть на сервери та адміністрування. Керовані хмарні сервіси тарифікуються за обсяг даних, кількість запитів або виділені ресурси; для старту часто достатньо безкоштовного рівня.
Чи підходить vector database для структурованих даних?
Ні, це не її призначення. Замовлення, платежі, залишки на складі — територія реляційних баз. Векторна база доповнює їх там, де дані неструктуровані: тексти, зображення, аудіо, поведінкові патерни.
Як почати працювати з векторною базою: короткий алгоритм
Якщо ви хочете додати смисловий пошук у власний продукт, практична послідовність виглядає так: оберіть модель ембедингів, що якісно працює з вашою мовою та доменом; розбийте документи на фрагменти розумного розміру й збережіть разом із векторами корисні метадані; розгорніть pgvector або легку спеціалізовану базу; реалізуйте запит у два кроки — спочатку векторний пошук кандидатів, потім фільтрація за метаданими; і лише після вимірювання реальних метрик якості та затримки вирішуйте, чи потрібен перехід на важчу інфраструктуру. Саме вимірювання, а не мода на технології, має керувати цими рішеннями: векторна база — це інструмент, який окупається тоді, коли схожість смислів справді є ядром вашої задачі.