Модель машинного обучения после развёртывания ведёт себя не так, как веб-приложение. Сервер либо работает, либо нет, а модель может отвечать быстро и без ошибок — и при этом ошибаться по содержанию: выдавать неточные прогнозы, смещаться в сторону одной группы клиентов, выдумывать факты. Классический мониторинг инфраструктуры этого не видит. Именно для таких ситуаций возникла практика, которую называют AI observability — наблюдаемость систем искусственного интеллекта.
Простыми словами, AI observability — это совокупность методов, метрик и инструментов для наблюдения за AI-системой в реальной эксплуатации: что она делает, насколько её результаты соответствуют определённым критериям и какие сигналы помогают расследовать отклонения. Термин связан с инженерией надёжности, но для AI к логам, метрикам и трейсам добавляются данные о модели, входные данные, оценки качества и риски.
- Что такое AI observability простыми словами
- Чем наблюдаемость моделей отличается от классического мониторинга
- Какие сигналы собирают системы AI observability
- Технические метрики сервиса
- Мониторинг входных данных
- Мониторинг предсказаний и качества
- Сигналы, специфичные для LLM и агентов
- Дрейф данных и дрейф концепции: главные враги модели в продакшене
- Как работает AI observability на практике
- Инструменты и примеры из реальной практики
- С чего начать внедрение: короткий чек-лист
- Частые вопросы о AI observability
- Нужна ли AI observability, если модель всего одна и трафик небольшой
- Чем AI observability отличается от MLOps
- Можно ли отслеживать качество LLM без ручной разметки
- Что наблюдать в агентных системах сверх обычного
Что такое AI observability простыми словами
Представьте банковскую модель скоринга, которая одобряет или отклоняет заявки на кредит. После запуска она ежедневно обрабатывает тысячи заявок. Технически всё работает: запросы принимаются, ответы возвращаются за миллисекунды. Но через полгода портрет заявителей изменился — например, из-за экономического кризиса или нового маркетингового канала. Модель продолжает работать, однако её прогнозы всё меньше соответствуют реальности, и никто этого не замечает, пока не вырастет уровень просроченных кредитов.
AI observability могла бы раньше показать изменение профиля заявителей или распределения прогнозов, но сам статистический сигнал не доказывает падения точности. Для вывода нужны фактические результаты, проверка сегментов и контекст бизнес-процесса.
Значение термина выходит за пределы простого дашборда с графиками. Полноценная наблюдаемость включает:
- сбор необходимых сигналов — характеристик входных данных, предсказаний, задержек, ошибок и версий компонентов; тексты запросов и ответов сохраняют лишь при необходимости, с учётом минимизации данных, доступа и сроков хранения;
- вычисление производных метрик — точности, дрейфа, смещения, доли галлюцинаций;
- диагностику — возможность проследить конкретный ответ до конкретных входных данных, версии модели и промпта;
- алертинг — уведомления, когда показатели деградируют;
- аудит — историю поведения для расследования инцидентов и регуляторных требований.
В отличие от простого логирования, observability соединяет сигналы с контекстом, чтобы сузить круг возможных причин и воспроизвести инцидент. Она не гарантирует автоматического ответа на вопрос «почему»: причинный вывод часто требует эксперимента, доменного анализа и фактических меток.
Чем наблюдаемость моделей отличается от классического мониторинга
В традиционном DevOps мониторинг проверяет заранее известные режимы отказа: сервер не отвечает, диск заполнен, база данных перегружена. Ошибка определена однозначно — либо ответ есть, либо его нет.
С моделями машинного обучения ситуация иная. Модель не «падает» — она тихо деградирует. Ответ поступает вовремя, код ответа 200, но содержание предсказания неправильное. Более того, само понятие «неправильный» часто невозможно проверить мгновенно: действительно ли клиент не вернёт кредит, станет известно лишь через несколько месяцев. Эта задержка обратной связи — одна из главных причин, почему модели требуют отдельного подхода к наблюдению.
Второе отличие — зависимость качества от данных, а не от кода. Код модели после развёртывания не меняется, но мир вокруг меняется постоянно. Поэтому AI observability следит не только за сервисом, но и за статистическими свойствами потока данных, который этот сервис обрабатывает.
Третье отличие касается генеративных систем. Для больших языковых моделей и агентов понятие корректности размыто: на один вопрос может быть десять приемлемых ответов и ещё сто — правдоподобных, но ложных. Оценить качество такого ответа автоматически сложнее, чем проверить код ошибки, и это породило отдельное направление — LLM observability.
Какие сигналы собирают системы AI observability
Практическая система наблюдения за моделью обычно работает с несколькими слоями сигналов, и каждый слой отвечает за свой класс проблем.
Технические метрики сервиса
Это тот самый классический мониторинг: задержка ответа, пропускная способность, частота ошибок, потребление памяти и GPU, стоимость инференса. Для LLM сюда добавляют количество токенов на запрос и расходы на API — у коммерческих моделей счёт может расти незаметно быстро, если промпт раздувается или агент попадает в цикл повторных вызовов.
Мониторинг входных данных
Здесь отслеживают распределения признаков: средние значения, частоты категорий, долю пропущенных значений, появление новых категорий, которых не было в обучающей выборке. Если модель обучалась на данных, где возраст клиентов преимущественно 25–45 лет, а теперь половина заявок — от людей старше 60, это повод для тревоги даже без проверки точности: модель работает за пределами того, что она видела.
Мониторинг предсказаний и качества
Изменение распределения самих предсказаний — тоже симптом. Если антифрод-модель вдруг начала помечать как подозрительные 30% транзакций вместо привычных 3%, что-то пошло не так, даже если реальные метки мошенничества ещё неизвестны. Когда же фактические результаты становятся доступными (клиент вернул кредит, пользователь отметил ответ как бесполезный), вычисляют полноценные метрики качества — точность, precision, recall, MAE в зависимости от типа задачи.
Сигналы, специфичные для LLM и агентов
Для генеративных систем и агентов, которые вызывают инструменты и модели цепочкой, собирают дополнительные данные:
- полные трейсы запроса — промпт, контекст, версии модели, промежуточные шаги агента, вызовы внешних инструментов;
- оценки качества ответов — релевантность контекста, фактическая обоснованность (groundedness), наличие галлюцинаций;
- обратную связь пользователей — оценки, жалобы, повторные вопросы;
- сигналы безопасности — попытки prompt injection, утечка персональных данных, токсичные ответы.
Оценку ответов LLM часто выполняет другая модель (подход LLM-as-a-judge) или набор автоматических проверок, ведь ручная разметка тысяч ответов в день невозможна. Это даёт приближённую, но оперативную картину качества.
Дрейф данных и дрейф концепции: главные враги модели в продакшене
Самая частая причина деградации модели — не ошибка в коде, а дрейф. В практике различают несколько его видов, и системы observability научены выявлять каждый отдельно.
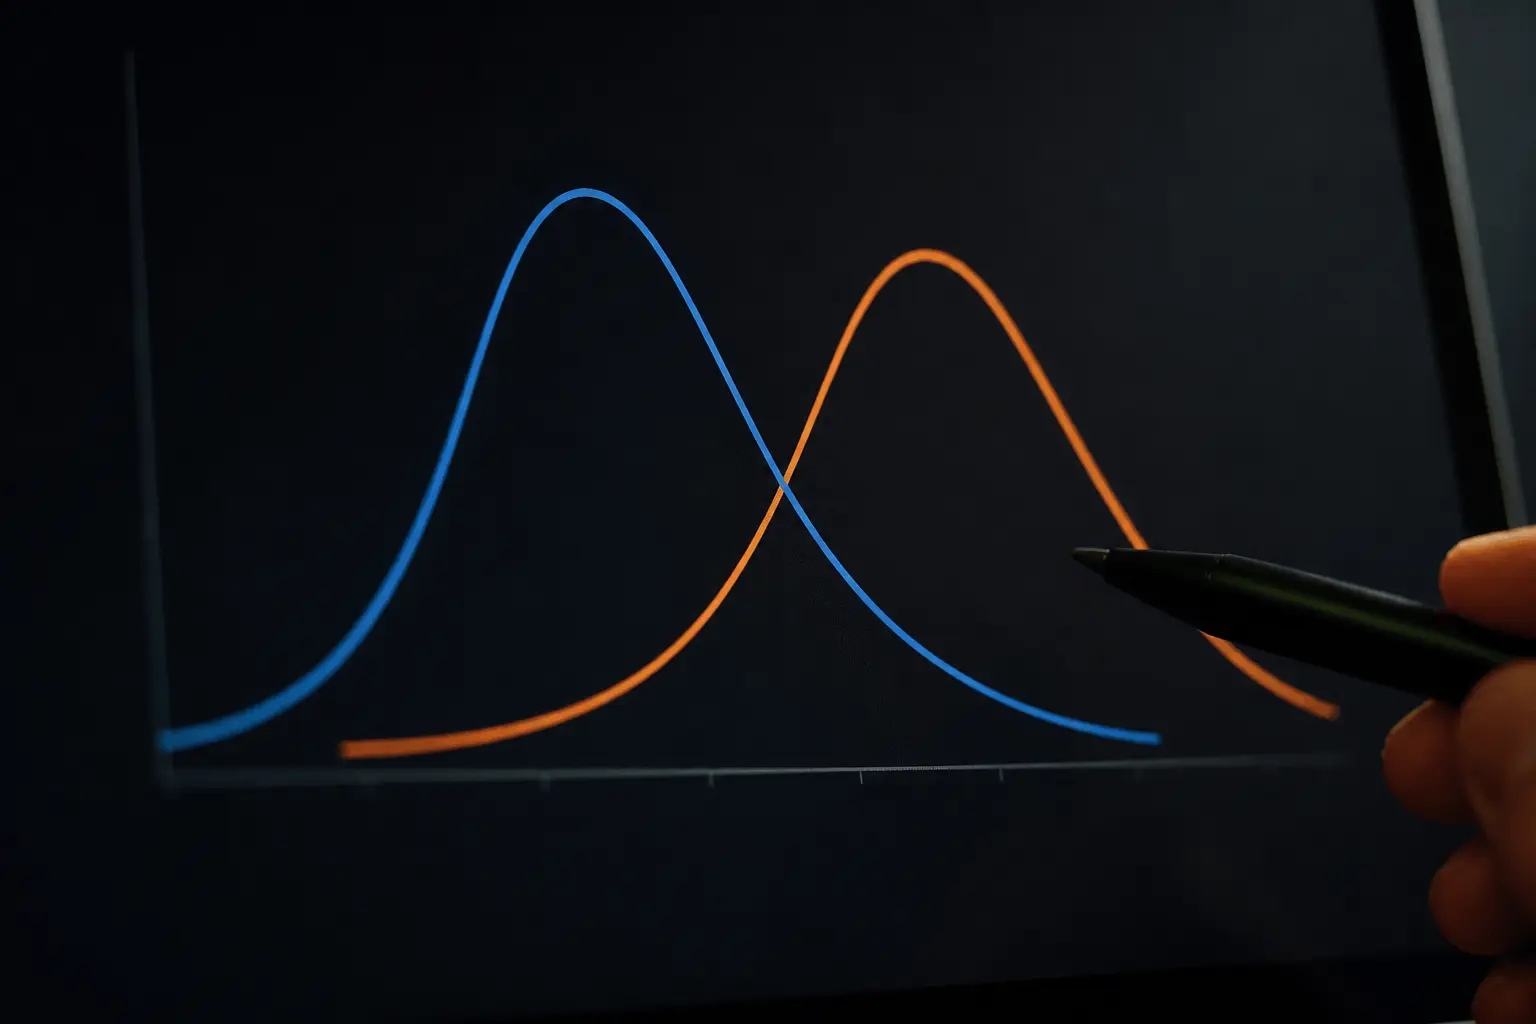
Дрейф данных (data drift) — общее название изменения статистических свойств данных. Ковариатный сдвиг — отдельный случай, когда меняется распределение входных признаков. Такие изменения выявляют сравнением текущих и базовых распределений по подходящим тестам и расстояниям; PSI и дивергенция Кульбака—Лейблера имеют разные допущения и не являются взаимозаменяемыми универсальными тестами.
Дрейф концепции (concept drift) — изменение самой связи между признаками и результатом. Например, мошенники меняют тактику, и старые признаки перестают указывать на мошенничество, хотя распределение самих признаков может почти не измениться. Этот тип дрейфа невозможно увидеть без фактических меток, поэтому он самый опасный: единственный надёжный способ его выявить — отслеживать метрики качества на новых данных с подтверждёнными результатами.
Дрейф меток означает изменение распределения целевой переменной, например базовой частоты мошенничества. Реальные системы могут одновременно иметь несколько типов сдвига, а выбор реакции — изменение порога, проверка данных, переобучение или остановка — зависит от риска и подтверждённой причины.
Важное предостережение: алерты о дрейфе — это статистические сигналы, а не приговор. Часть срабатываний будет ложной, особенно на малых объёмах данных. Слишком чувствительная система учит команду игнорировать уведомления, поэтому пороги настраивают постепенно, глядя на реальные инциденты.
Как работает AI observability на практике
Типичный рабочий цикл начинается с документированных эталонных показателей и критериев приемлемости. В продакшене собирают минимально необходимые сигналы вместе с версиями модели, промпта, данных и инструментов. Чувствительные поля, персональные данные и секреты нужно маскировать или не записывать; доступ и сроки хранения определяют политикой риска.
Далее система наблюдения в потоке или по расписанию вычисляет текущие статистики и сравнивает их с базовыми. Превышение порога создаёт алерт, который попадает команде в мессенджер или систему инцидентов. Инженер открывает трейс проблемных запросов и может пройти всю цепочку: какие данные поступили, что ответила модель, изменилось ли поведение на конкретном сегменте — например, только для мобильных пользователей или только для нового региона.
Для агентных систем трассировка особенно важна. Агент, который сам планирует шаги и вызывает инструменты, может ошибиться на третьем из семи шагов, и без полного трейса найти это почти невозможно. Запись каждого промежуточного решения позволяет воспроизвести сценарий и понять, где логика сломалась — в промпте, в данных или в самой модели.
Последний элемент цикла — действие. По результатам расследования команда либо корректирует пороги и фильтры, либо обновляет данные, либо запускает переобучение, либо откатывает версию. Система observability ценна лишь тогда, когда сигнал из неё заканчивается конкретным решением, а не очередным графиком, на который никто не смотрит.
Инструменты и примеры из реальной практики
Инструменты условно делят на мониторинг моделей и данных, трассировку и оценивание LLM/агентов и общие платформы observability. Среди известных примеров — Evidently, whylogs, NannyML, Fiddler, Langfuse, LangSmith, Arize Phoenix, W&B Weave, Datadog и Grafana. Это примеры разных по лицензии и функциям продуктов, а не один класс открытых библиотек; актуальные возможности надо проверять перед выбором.
Несколько характерных примеров применения:
- Финтех отслеживает дрейф признаков скоринговой модели и долю одобрений по сегментам; резкий рост отказов в определённой возрастной группе становится сигналом проверить смещение модели.
- Служба поддержки с LLM-чатботом оценивает каждый ответ на релевантность и фактичность; падение средней оценки после изменения промпта позволяет быстро откатить изменение.
- Ритейлер мониторит модель прогнозирования спроса и замечает дрейф концепции после изменения логистики, прежде чем ошибки прогноза превратятся в пустые полки.
- Гипотетический пример: команда агентной системы по трейсам видит повторные вызовы одного инструмента, которые увеличивают задержку и расходы. Конкретный процент зацикливания надо вычислять на собственном трафике, а не переносить из условного сценария.
В этих сценариях общая цель — сократить время между появлением отклонения, его выявлением и управляемой реакцией. Observability сама не гарантирует предотвращения убытков: польза зависит от качества метрик, меток, порогов и процесса реагирования. NIST AI RMF прямо рекомендует планы постразвёртывающего мониторинга, ответственных лиц и механизмы реагирования.
С чего начать внедрение: короткий чек-лист
Для команды, которая только развернула первую модель, не нужно сразу покупать платформу. Разумная последовательность выглядит так:
- Начните логировать входные данные, предсказания и версию модели с первого дня продакшена — это неизбежно понадобится для любого расследования.
- Определите 3–5 ключевых метрик: одну техническую (задержка или стоимость), одну-две по данным (дрейф основных признаков) и одну по качеству, даже если она вычисляется с задержкой.
- Зафиксируйте базовый ряд на этапе обучения, иначе не с чем сравнивать.
- Настройте алерты с консервативными порогами и владельцем для каждого алерта — уведомление без ответственного не работает.
- Для LLM добавьте трассировку запросов и хотя бы простую автоматическую оценку ответов, прежде чем масштабировать трафик.
- Периодически пересматривайте, какие алерты были ложными, а какие инциденты система пропустила, и корректируйте пороги. Частоту пересмотра определяйте по риску, объёму изменений и требованиям отрасли; универсального квартального интервала нет.
Главная ошибка на старте — пытаться отслеживать всё сразу. Система наблюдения, которая генерирует сотни уведомлений в день, хуже её отсутствия: команда перестаёт реагировать. Лучше иметь пять метрик с понятной реакцией на каждую, чем пятьдесят графиков без владельцев.
Частые вопросы о AI observability
Нужна ли AI observability, если модель всего одна и трафик небольшой
Базовый уровень версионирования и журналирования нужен даже для одной модели, но он не является бесплатным и не должен означать сохранение всех сырых запросов. Объём телеметрии определяют по риску, стоимости, приватности и требованиям безопасности. Полные платформы оправданы, когда модель существенно влияет на деньги, права, безопасность или опыт пользователей.
Чем AI observability отличается от MLOps
MLOps — это более широкая дисциплина: конвейеры обучения, версионирование, развёртывание, тестирование моделей. Observability — одна из её составляющих, ответственная за то, что происходит с моделью после развёртывания. Можно иметь MLOps-процессы без глубокой наблюдаемости, но это означает управлять моделью вслепую.
Можно ли отслеживать качество LLM без ручной разметки
Частично. Автоматические оцениватели — эвристики, проверки на выходные данные, модели-судьи — дают оперативную картину, но они сами ошибаются. Практический компромисс: автоматическая оценка всего потока плюс регулярная ручная проверка небольшой случайной выборки для калибровки.
Что наблюдать в агентных системах сверх обычного
Полные трейсы цепочки шагов, количество и последовательность вызовов инструментов, долю зацикливаний и неудачных попыток, а также итоговую стоимость выполнения задачи. Именно агенты чаще всего «неожиданно» потребляют бюджет на токены из-за повторных вызовов, которые без трассировки незаметны.