Когда вы вводите в поиск «как восстановить доступ к аккаунту», а система находит статью под названием «Восстановление пароля: пошаговая инструкция», — это не магия и не удача. Слова в запросе и в тексте разные, но смысл совпадает, и именно по смыслу, а не по буквам, современный AI научился искать. Технология, стоящая за этим, называется vector database — векторная база данных. Разберёмся, что это такое, как она работает изнутри и почему без неё сегодня невозможны ни чат-боты, отвечающие по документам компании, ни поиск похожих фото, ни умные рекомендации.
- Что такое vector database простыми словами
- От чего отталкивается поиск по смыслу: эмбеддинги
- Как работает vector database изнутри
- Запись и индексация
- Метрики близости
- Приблизительный поиск и его ценность
- Чем vector database отличается от обычных баз данных
- Где векторные базы применяются на практике
- Какие vector database существуют и как выбрать
- Инфраструктура: облака, дата-центры и ресурсы
- Ограничения и типичные ошибки
- Часто задаваемые вопросы
- Можно ли обойтись без векторной базы для небольшого проекта?
- Чем векторный поиск отличается от полнотекстового?
- Сколько стоит векторная база?
- Подходит ли vector database для структурированных данных?
- Как начать работать с векторной базой: короткий алгоритм
Что такое vector database простыми словами
Vector database — это специализированная база данных, которая хранит информацию в виде векторов, то есть массивов чисел, и умеет быстро находить среди миллионов таких массивов те, которые ближайшие друг к другу по смыслу. Термин простыми словами: представьте карту города, где каждый текст, изображение или звук имеет свою точку с координатами. Точки с близким содержанием оказываются рядом: статьи о паролях — возле статей об аккаунтах, фото котов — возле фото котят. Векторная база данных хранит эту «карту» и ищет на вопрос: какие точки лежат ближе всего к заданной?
Значение слова «вектор» здесь математическое: это просто упорядоченный набор чисел, например [0.12, -0.87, 0.44, …]. Только координат не две-три, как на карте, а сотни или тысячи. Каждая ось такого многомерного пространства соответствует какому-то скрытому смысловому признаку, который модель научилась различать. Человек в этих числах ничего не прочитает, но для алгоритма расстояние между двумя векторами — это расстояние между двумя смыслами.
Обычная база данных отвечает на вопрос «найди записи, где поле равно X». Векторная база отвечает на другой вопрос: «найди записи, наиболее похожие на X». Эта разница принципиальна. Точное совпадение работает, когда вы знаете точное значение — номер заказа, артикул, дату. Но язык, изображения и поведение людей так не работают: один и тот же смысл выражается десятками способов, и для них нужен поиск по сходству.
От чего отталкивается поиск по смыслу: эмбеддинги
За пределами базы данных существует ещё один обязательный элемент — модель эмбеддингов. Это нейронная сеть, натренированная преобразовывать текст, изображения, аудио или видео в вектор фиксированной длины. На вход — предложение «кот спит на диване», на выход —, скажем, 768 чисел. Предложение «котёнок дремлет на диване» даст очень близкий набор чисел, хотя ни одно слово не совпадает. А «биржевые индексы упали» — набор совершенно другой, отдалённый от кошачьей тематики.
Модели эмбеддингов тренируют на огромных корпусах данных так, чтобы похожие по содержанию объекты получали близкие векторы. Это и есть та «карта смыслов», о которой шла речь выше: модель задаёт систему координат, а vector database лишь хранит точки и умеет по ним эффективно искать. Важно понимать разделение труда: качество смыслового поиска на 80% определяется моделью эмбеддингов, а база отвечает за скорость, масштаб и удобство работы.
Эмбеддинги бывают разной размерности — типично от 384 до 3072 чисел на объект, в зависимости от модели. Большая размерность может кодировать более тонкие оттенки содержания, но стоит дороже: больше памяти, медленнее вычисления. На практике часто выбирают компромисс, а некоторые современные модели позволяют обрезать вектор до меньшей длины почти без потери качества.
Как работает vector database изнутри
Работа векторной базы состоит из трёх этапов: запись, индексация и поиск. Рассмотрим каждый.
Запись и индексация
Когда документ попадает в систему, он сначала проходит через модель эмбеддингов и преобразуется в вектор. База хранит этот вектор вместе с метаданными: идентификатором документа, текстом-источником, датой, тегами. Но просто хранить мало — надо искать. Наивный подход «сравнить запрос с каждым вектором» работает на тысячах записей, однако на сотнях миллионов он бы занимал минуты на один запрос.
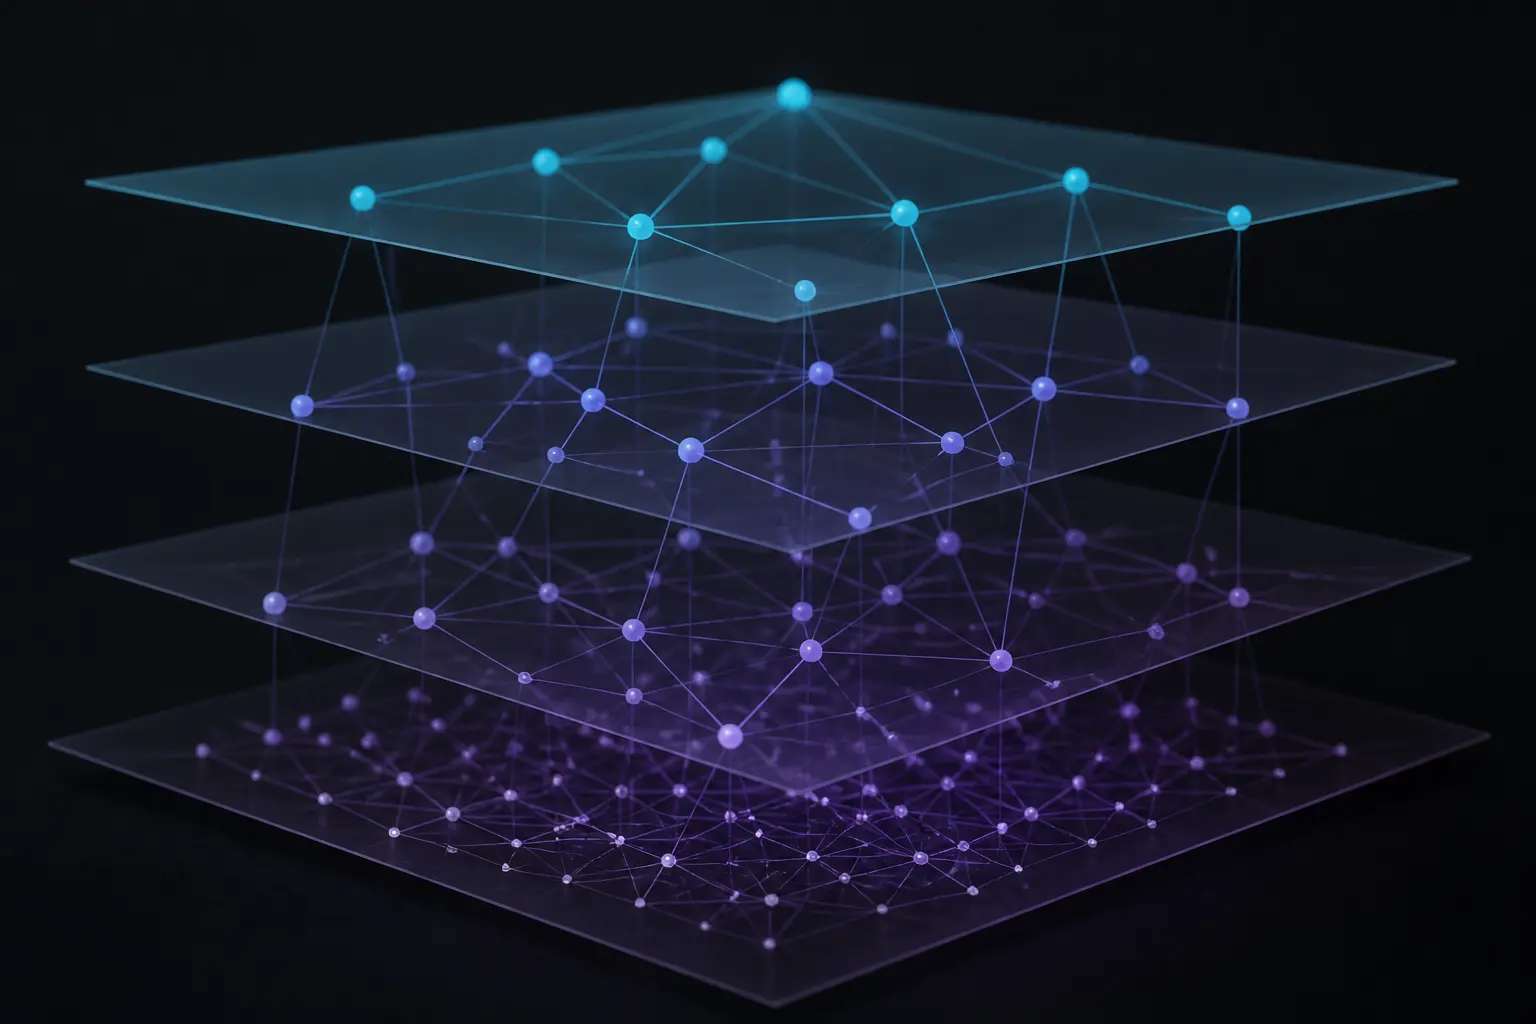
Поэтому векторные базы строят специальные индексы — структуры данных, позволяющие отсеять 99% ненужных кандидатов, не считая расстояние до них. Один из распространённых алгоритмов — HNSW (иерархические навигируемые маленькие миры): векторы организуются в многослойный граф, где верхние слои дают грубую навигацию по пространству, а нижние — точное уточнение. Поиск в таком графе напоминает спуск по горной дороге: сначала быстрые широкие шаги, затем всё более мелкие — и за десятки миллисекунд вы возле ближайших соседей. Существуют и другие семейства алгоритмов, например IVF (кластеризация пространства на ячейки) или дисковые индексы вроде DiskANN для больших объёмов.
Метрики близости
Чтобы сказать, какой вектор «ближе», нужна мера расстояния. Чаще всего используют косинусную близость — угол между векторами: чем меньше угол, тем ближе смыслы, независимо от длины векторов. Также применяют евклидово расстояние (прямая линия между точками) и скалярное произведение. Выбор метрики обычно продиктован моделью эмбеддингов: если модель тренировалась под косинусное сходство, базу надо настроить так же, иначе результаты будут искажены.
Приблизительный поиск и его ценность
Ключевой факт о векторных базах: для больших наборов они часто используют приблизительный поиск ближайших соседей (ANN), но некоторые системы поддерживают и точный поиск. Приблизительный индекс обменивает часть полноты поиска (recall) на скорость и память. Качество не имеет универсальных 98%: его измеряют на своих запросах при выбранных настройках. Ускорение, задержку и потерю recall измеряют на собственных данных: результат зависит от индекса, параметров, фильтров и оборудования. Приемлемый компромисс определяют требования конкретного продукта.
Чем vector database отличается от обычных баз данных
Реляционные базы оперируют точными значениями и связями: равенство, диапазоны, объединения таблиц. Полнотекстовые системы ищут по совпадению слов и их форм. Векторные базы оперируют близостью в многомерном пространстве. Сравнение по ключевым признакам:
| Критерий | Реляционная БД | Полнотекстовый поиск | Vector database |
|---|---|---|---|
| Тип запроса | Точное условие (WHERE) | Совпадение слов и форм | Смысловая близость |
| Основные данные | Структурированные строки | Текст | Векторы + метаданные |
| Индекс | B-tree, hash | Инвертированный индекс | ANN-индекс (HNSW, IVF) |
| Понимает синонимы | Нет | Частично, через словари | Зависит от embedding-модели |
| Работает с медиа | Нет | Нет | Да: фото, аудио, видео |
| Типичные сценарии | Транзакции, учёт | Поиск по ключевым словам | Семантический поиск, RAG |
Это не конкуренты, а дополнения. В реальных системах они работают вместе: заказ хранится в PostgreSQL, каталог индексируется поисковым движком, а смысловой поиск и рекомендации обслуживает векторная база. Более того, границы размываются: расширение pgvector для PostgreSQL позволяет хранить векторы прямо в реляционной базе, что для небольших проектов оказывается практичнее, чем отдельная система.
Где векторные базы применяются на практике
Самый громкий сценарий последних лет — RAG, retrieval-augmented generation. Большая языковая модель сама по себе знает только то, что было в её обучающих данных, и склонна уверенно выдумывать факты. Схема RAG работает так: документы компании разбиваются на фрагменты, преобразуются в векторы и складываются в vector database; когда пользователь задаёт вопрос, система находит ближайшие по смыслу фрагменты и передаёт их модели как контекст. Модель отвечает, опираясь на реальные документы, а не на собственную «память». Так строят корпоративных помощников, ботов поддержки с базой знаний, юридические и медицинские справочные системы.
Другие распространённые примеры применения:
- Семантический поиск в магазинах и каталогах: запрос «что-то тёплое для похода осенью» находит флиски и термобельё без точного совпадения слов.
- Рекомендательные системы: товары, фильмы или музыка с близкими векторами к истории пользователя — это и есть «похожее на то, что вам понравилось».
- Поиск изображений и видео: по фото или описанию находятся визуально похожие объекты; так работает поиск дубликатов и модерация контента.
- Выявление мошенничества и аномалий: транзакция или действие, чей вектор далёк от типичного поведения клиента, получает повышенное внимание.
- Дедупликация: службы поддержки автоматически склеивают обращения об одной и той же проблеме, сформулированные по-разному.
Общее у всех этих сценариев одно: данные неструктурированы, а «сходство» важнее точного совпадения. Именно поэтому рост количества AI-продуктов так резко поднял спрос на векторную инфраструктуру.
Какие vector database существуют и как выбрать
Рынок делится на несколько категорий. Специализированные векторные базы — Pinecone, Weaviate, Qdrant, Milvus, Chroma — построены вокруг векторного поиска и дают максимум возможностей: гибкие индексы, фильтрацию по метаданным, горизонтальное масштабирование. Расширения классических СУБД, прежде всего pgvector для PostgreSQL, позволяют держать векторы рядом с основными данными без отдельной системы. Поисковые движки — Elasticsearch, OpenSearch — добавили векторный поиск к полнотекстовому, что удобно для гибридных сценариев. Наконец, облачные провайдеры предлагают управляемые сервисы в собственных облаках, где векторные хранилища интегрированы с платформами машинного обучения.
Выбирая решение, смотрите на несколько практических параметров:
- Объём и темп роста. pgvector или локальная библиотека FAISS могут быть достаточными, но предел зависит от размерности, нагрузки, фильтров, latency, обновлений и доступной памяти. Сотни миллионов векторов требуют распределённой системы.
- Требования к задержке. Чат-бот в реальном времени требует ответов за десятки миллисекунд; пакетная обработка архива — нет.
- Фильтрация по метаданным. В бизнес-задачах почти всегда надо искать «похожие документы, но только этого клиента и только за этот год». Качество сочетания векторного поиска с фильтрами — важный отличительный признак систем.
- Модель развёртывания. Собственная инфраструктура, частное облако или управляемый сервис — вопрос стоимости, требований безопасности данных и наличия команды.
- Экосистема: наличие SDK под ваш стек, интеграции с фреймворками вроде LangChain или LlamaIndex, зрелость документации.
Реалистичный совет: начинайте с самого простого варианта, который закрывает задачу. Переход от pgvector к специализированной базе на этапе роста — нормальный путь, а переплачивать за распределённый кластер ради двух миллионов векторов — нет.
Инфраструктура: облака, дата-центры и ресурсы
Векторный поиск — ресурсоёмкая нагрузка, и это стоит учитывать при планировании инфраструктуры. Продукты с HNSW используют разные схемы хранения, кеширования и загрузки графа. Несжатый массив самих векторов имеет значительный объём: миллиард векторов размерностью 1536 в формате float — это терабайты RAM без учёта структуры графа. Поэтому большие векторные кластеры — это серверы с сотнями гигабайт памяти, быстрые NVMe-диски для дисковых индексов и предсказуемая сетевая задержка между узлами.
Облачные провайдеры закрывают эту потребность двумя путями: управляемыми векторными сервисами, где инфраструктура невидима для клиента, и виртуальными машинами с большой памятью для самостоятельного развёртывания Milvus или Qdrant. Отдельный вопрос — вычисление эмбеддингов: преобразование миллионов документов в векторы выгодно делать на GPU, тогда как сам поиск по индексу обычно выполняется на CPU. География дата-центров тоже имеет значение: для интерактивных приложений векторную базу размещают в том же регионе, что и приложение, чтобы не добавлять десятки миллисекунд сетевой задержки к каждому запросу.
Технологии в этой области развиваются быстро: появляются квантованные индексы, которые могут существенно сжимать векторы, но коэффициент сжатия и потеря recall зависят от метода и данных, дисковые алгоритмы, снимающие зависимость от дорогой RAM, и гибридный поиск, комбинирующий векторную близость с классическим совпадением ключевых слов. Инновации здесь движутся простым стимулом: каждый сэкономленный гигабайт памяти на миллиарде векторов — это ощутимые деньги.
Ограничения и типичные ошибки
Векторная база — не универсальный ответ, и полезно знать её слабые места. Во-первых, качество результатов полностью зависит от модели эмбеддингов: модель, натренированная преимущественно на английских текстах, будет посредственно различать украинские синонимы. Во-вторых, точные значения — номера, коды, редкие собственные названия — векторный поиск часто «размывает»: он ищет сходство, а не совпадение. Именно поэтому гибридный поиск (векторы плюс ключевые слова) стал практическим стандартом.
Распространённые ошибки команд, начинающих работать с vector database:
- Слишком большие фрагменты текста при индексации: вектор усредняет смысл целого фрагмента, и конкретный вопрос «тонет» в общем тексте. Размер фрагмента нужно подбирать экспериментально с учётом модели, структуры документа, перекрытия и качества ответов.
- Смена модели эмбеддингов без переиндексации: векторы разных моделей живут в разных пространствах и несравнимы между собой.
- Игнорирование метаданных: без фильтров система возвращает глобально похожие, но не релевантные конкретному пользователю результаты.
- Ожидание детерминированности: приблизительный поиск может давать немного разный порядок результатов между запросами — это нормально, а не сбой.
Часто задаваемые вопросы
Можно ли обойтись без векторной базы для небольшого проекта?
Да. Для десятков тысяч документов достаточно библиотеки FAISS внутри приложения или pgvector в существующей базе PostgreSQL. Отдельная специализированная система оправдана, когда появляются миллионы векторов, высокая нагрузка или потребность в распределённом хранении.
Чем векторный поиск отличается от полнотекстового?
Полнотекстовый поиск ищет совпадение слов и их форм, векторный — близость смыслов. Первый лучше находит точные названия и термины, второй — синонимы и перефразирования. На практике лучшие результаты даёт комбинация обоих.
Сколько стоит векторная база?
Решения с открытым кодом — Qdrant, Weaviate, Milvus, pgvector — бесплатны, расходы идут на серверы и администрирование. Управляемые облачные сервисы тарифицируются по объёму данных, количеству запросов или выделенным ресурсам; для старта часто достаточно бесплатного уровня.
Подходит ли vector database для структурированных данных?
Нет, это не её назначение. Заказы, платежи, остатки на складе — территория реляционных баз. Векторная база дополняет их там, где данные неструктурированы: тексты, изображения, аудио, поведенческие паттерны.
Как начать работать с векторной базой: короткий алгоритм
Если вы хотите добавить смысловой поиск в собственный продукт, практическая последовательность выглядит так: выберите модель эмбеддингов, качественно работающую с вашим языком и доменом; разбейте документы на фрагменты разумного размера и сохраните вместе с векторами полезные метаданные; разверните pgvector или лёгкую специализированную базу; реализуйте запрос в два шага — сначала векторный поиск кандидатов, затем фильтрация по метаданным; и только после измерения реальных метрик качества и задержки решайте, нужен ли переход на более тяжёлую инфраструктуру. Именно измерение, а не мода на технологии, должно управлять этими решениями: векторная база — это инструмент, который окупается тогда, когда сходство смыслов действительно является ядром вашей задачи.