GPU cloud — це оренда хмарних обчислень із графічними прискорювачами для навчання моделей, інференсу, наукових розрахунків і рендерингу. Він дає змогу отримати один GPU або кластер без купівлі серверів, але доступність, час запуску й ціна залежать від провайдера, регіону та типу ресурсу. Ця модель оренди ресурсів є частиною ширшого явища — cloud computing та його моделей IaaS, PaaS і SaaS, де обчислення, платформа й застосунки надаються як послуги.
Але чому звичайний CPU-хостинг для цього не годиться? І чим GPU-хмара відрізняється від простої оренди виділеного сервера з відеокартою? Розбираємось по суті, без маркетингових обгорток.
- Чому AI потребує саме GPU, а не звичайних процесорів
- Що таке GPU cloud і чим він відрізняється від звичайної хмари
- Як працює GPU cloud: від запиту до готового кластера
- Кому і коли потрібен GPU cloud, а не власний сервер
- Реальні приклади використання GPU cloud
- Як обрати провайдера GPU cloud: на що дивитися, крім ціни
- Приховані ризики та як їх уникнути
- GPU cloud vs. CPU cloud: ключові відмінності в одній таблиці
- Практичний чекліст перед запуском у GPU cloud
- Поширені запитання
- Чи можна використовувати GPU cloud для ігрового стрімінгу?
- Яка мінімальна конфігурація потрібна для fine-tuning BERT?
- Чи можна тренувати модель на кількох GPU різних провайдерів одночасно?
- Що робити, якщо модель не вміщується у VRAM однієї карти?
Чому AI потребує саме GPU, а не звичайних процесорів
CPU оптимізований для широкого набору послідовних і керуючих задач, а GPU — для великої кількості паралельних операцій. Кількість ядер, операцій за такт і перевага в швидкості залежать від архітектури та алгоритму, тому фіксовані межі на кшталт «до 64 ядер» не є визначенням CPU.
Навчання нейромереж широко використовує матричні операції, які добре паралеляться на GPU. Прискорення порівняно з CPU може бути значним, але не має універсального множника 10–50: воно залежить від моделі, точності, розміру пакета, пам’яті, програмного стеку та завантаження даних.
Сучасні прискорювачі мають спеціалізовані матричні блоки для форматів на кшталт FP16, BF16, TF32 та інших. Назва Tensor Cores належить NVIDIA; AMD використовує власні матричні обчислювальні блоки. Перевага проявляється лише тоді, коли фреймворк і модель ефективно використовують підтримуваний формат.
Що таке GPU cloud і чим він відрізняється від звичайної хмари
GPU cloud може надавати bare-metal сервери, віртуальні машини, контейнери, цілу карту або її ізольовану частину. Доступ не обов’язково є прямим і без гіпервізора; важливо з’ясувати модель віртуалізації, гарантії ізоляції та фактичну продуктивність.
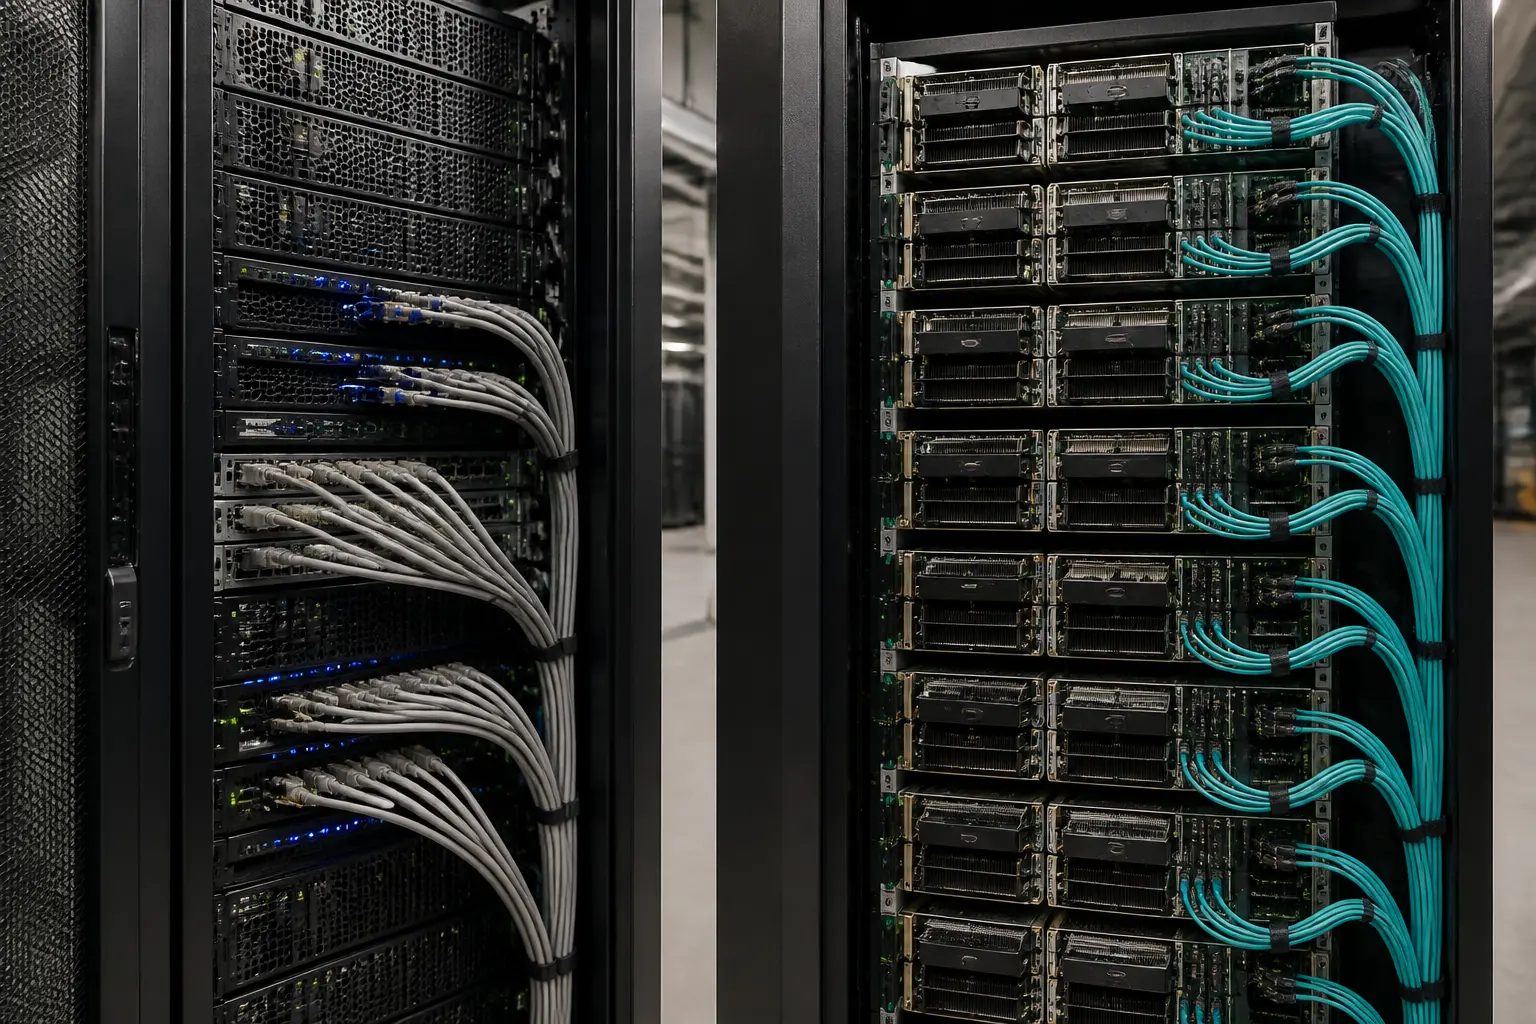
Для великих задач важливі не лише GPU, а й CPU, оперативна пам’ять, локальне та об’єктне сховище, пропускна здатність і затримка мережі. NVLink і NVSwitch з’єднують GPU у підтримуваних системах, тоді як між вузлами зазвичай використовують InfiniBand або Ethernet/RoCE; це різні рівні інфраструктури.
Як працює GPU cloud: від запиту до готового кластера
Провайдер може запускати готовий образ, контейнер або bare-metal систему з драйверами й бібліотеками. Склад образу, версії CUDA, PyTorch чи TensorFlow та час розгортання не є однаковими; їх потрібно фіксувати в конфігурації для відтворюваності. Для легких задач без постійного завантаження GPU інколи краще підходить serverless computing, де код запускається без керування серверами.
GPU може передаватися контейнеру через драйвер, виділятися віртуальній машині, ділитися через vGPU або розбиватися на ізольовані MIG-інстанси. Накладні витрати та функціональні обмеження залежать від способу, тому твердження, що GPU «не віртуалізується», надто широке.
Розподілене навчання потребує бібліотеки колективних операцій, планувальника й правильної топології. NCCL не налаштовує кластер автоматично, NVSwitch працює переважно всередині підтримуваної системи, а між вузлами потрібна швидка мережа. Додаткові GPU дають виграш лише за достатньої ефективності масштабування.
Кому і коли потрібен GPU cloud, а не власний сервер
Власний сервер може бути вигідним за стабільного завантаження, але межа залежить від ціни обладнання, електроенергії, охолодження, персоналу, фінансування, строку служби та вартості простою. Цілодобове завантаження не є універсальним критерієм.
У хмарі обчислення часто оплачуються за час використання, проте після зупинки інстансу можуть залишатися платежі за диски, знімки, зарезервовані ресурси, IP-адреси або вихідний трафік. Перед запуском потрібні бюджетні ліміти, автоматичне вимкнення й перевірка тарифів.
Попит на GPU-хмари безпосередньо впливає на те, як зростають глобальні IT-витрати 2026 року, адже AI-інфраструктура дедалі більше визначає структуру ринку.
Ось основні сценарії, де GPU cloud дає відчутну перевагу:
- Стартапи без інфраструктурного бюджету, яким потрібна гнучкість.
- Дослідницькі команди, що перевіряють десятки гіпотез і не хочуть чекати в черзі на єдиний сервер.
- Пікові навантаження — наприклад, підготовка до дедлайну конференції, коли потрібно одночасно тренувати кілька моделей.
- Георозподілені команди, яким потрібен спільний керований доступ до ресурсів із урахуванням затримки, правил експорту технологій і вимог до даних.
Реальні приклади використання GPU cloud
Щоб зрозуміти цінність, досить поглянути на кілька типових кейсів із практики ML-інженерів.
Донавчання мовної моделі. Потреба в GPU залежить від розміру моделі, довжини контексту, формату ваг, оптимізатора та методу — повного fine-tuning чи PEFT/LoRA. Не кожна задача вимагає 4–8 A100, а тижнева ціна змінюється за провайдером і моделлю оплати.
Навчання дифузійної моделі. Пам’ять визначають роздільна здатність, batch size, архітектура й оптимізації. Stable Diffusion не має універсальної вимоги в десятки гігабайт VRAM; для різних режимів можливі споживчі GPU, професійні карти або кілька прискорювачів.
Інференс у реальному часі. Розміщення ближче до користувача може зменшити мережеву затримку, але загальний час також залежить від черг, холодного старту, batch scheduling, моделі й передачі даних. Регіон потрібно обирати разом із вимогами до резидентності даних.
Як обрати провайдера GPU cloud: на що дивитися, крім ціни
На ринку десятки провайдерів, і ціна за годину — лише один із факторів. Не менш важливі:
- Тип GPU і VRAM. Потреба може становити від кількох до сотень гігабайт залежно від моделі та режиму. Перевірте точний GPU, формат чисел, пропускну здатність пам’яті й доступну топологію між картами.
- Мережа. Не існує універсальної вимоги 100 Гбіт/с на GPU. Потрібну пропускну здатність і RDMA/RoCE/InfiniBand визначають розмір моделі, кількість вузлів, шаблон обміну та цільова ефективність масштабування.
- Зберігання даних. Оцініть послідовну й випадкову швидкість, IOPS, кешування, пропускну здатність до об’єктного сховища та вартість. Наявність NVMe сама по собі не гарантує, що конвеєр постачає дані GPU без простою.
- Географія дата-центрів. Якщо ви розробляєте AI-сервіс із жорсткими вимогами до latency, наявність дата-центру у вашому регіоні може бути вирішальною.
- API та автоматизація. Для CI/CD-пайплайнів потрібна можливість керувати інстансами через API або Terraform-провайдер, а не лише через веб-панель.
Перевірте квоти, черги, гарантію ємності та момент початку тарифікації. Одні сервіси беруть плату лише після запуску ресурсу, інші мають резервування або мінімальні зобов’язання; це потрібно читати в умовах конкретного тарифу.
Приховані ризики та як їх уникнути
GPU-хмара знімає багато проблем, але створює свої. Найпоширеніша помилка новачків — залишити інстанс увімкненим після завершення тренування. Провайдер продовжує списувати кошти за годину, навіть якщо GPU простоює. Тому варто налаштувати автоматичне вимкнення за таймаутом або використовувати скрипти, які зупиняють інстанс після завершення скрипта тренування.
Частковий GPU не обов’язково означає приховану конкуренцію. NVIDIA MIG розділяє підтримуваний GPU на ізольовані інстанси з виділеними ресурсами пам’яті, але має обмеження, зокрема для частини між-GPU комунікацій. Порівнюйте профіль MIG із повною картою та вимогами задачі.
Для конфіденційних даних перевіряйте шифрування, керування ключами, журнали доступу, регіон зберігання, резервні копії, умови видалення та відповідність потрібним стандартам. Знищення інстансу не завжди автоматично видаляє диски, знімки або копії.
GPU cloud vs. CPU cloud: ключові відмінності в одній таблиці
| Критерій | GPU cloud | Звичайна хмара (CPU) |
|---|---|---|
| Основний ресурс | Графічні процесори (GPU) | Центральні процесори (CPU) |
| Призначення | Паралельні обчислення, AI/ML, рендеринг | Вебсервери, бази даних, бізнес-логіка |
| Мережева інфраструктура | NVLink, InfiniBand, RDMA | Ethernet, стандартні мережі |
| Сховище | NVMe SSD з низькою затримкою | SSD/HDD зі стандартною затримкою |
| Цінова модель | Погодинна, за GPU-годину | Погодинна, за vCPU/ОЗП |
| Типове використання | Тренування нейромереж, інференс | Хостинг, обробка транзакцій |
Практичний чекліст перед запуском у GPU cloud
- Оцініть реальну потребу у VRAM для вашої моделі з урахуванням розміру батчу.
- Перевірте, чи підтримує провайдер потрібну версію CUDA та драйверів.
- Налаштуйте автоматичне вимкнення інстансу після завершення тренування.
- Використовуйте контейнеризацію для відтворюваності середовища.
- Моніторте використання GPU під час тренування, щоб виявити вузькі місця.
- Переконайтеся, що дані завантажуються досить швидко, щоб GPU не простоювали.
Поширені запитання
Чи можна використовувати GPU cloud для ігрового стрімінгу?
Так, якщо провайдер і ліцензії це дозволяють, але обчислювальний GPU cloud не завжди оптимізований для інтерактивного відео. Для гри важливі кодувальник, мережевий маршрут, затримка вводу й готовий клієнт; спеціалізований сервіс часто простіший.
Яка мінімальна конфігурація потрібна для fine-tuning BERT?
Єдиної мінімальної конфігурації немає. Вона залежить від варіанта BERT, довжини послідовності, batch size, точності, оптимізатора та повного або параметр-ефективного донавчання. Потрібну VRAM краще виміряти на малому запуску, а не визначати лише назвою T4 чи A10.
Чи можна тренувати модель на кількох GPU різних провайдерів одночасно?
Технічно окремі етапи конвеєра можна рознести між провайдерами, але синхронне розподілене навчання через публічні мережі зазвичай ускладнюють затримка, нестабільна пропускна здатність, безпека й вартість трафіку. Для одного тренувального job практичніше використовувати узгоджений кластер.
Що робити, якщо модель не вміщується у VRAM однієї карти?
Використовуйте gradient checkpointing, mixed precision, accumulation, sharding, offload, model/tensor/pipeline parallelism або модель із більшою пам’яттю. NVLink може допомогти на підтримуваній топології, але не є обов’язковою умовою багатокарткового запуску; важливі також PCIe, NVSwitch і міжвузлова мережа.