GPU cloud — это аренда облачных вычислений с графическими ускорителями для обучения моделей, инференса, научных расчётов и рендеринга. Он позволяет получить один GPU или кластер без покупки серверов, но доступность, время запуска и цена зависят от провайдера, региона и типа ресурса.
Но почему обычный CPU-хостинг для этого не годится? И чем GPU-облако отличается от простой аренды выделенного сервера с видеокартой? Разбираемся по сути, без маркетинговых оберток.
- Почему AI нуждается именно в GPU, а не в обычных процессорах
- Что такое GPU cloud и чем он отличается от обычного облака
- Как работает GPU cloud: от запроса до готового кластера
- Кому и когда нужен GPU cloud, а не собственный сервер
- Реальные примеры использования GPU cloud
- Как выбрать провайдера GPU cloud: на что смотреть, кроме цены
- Скрытые риски и как их избежать
- GPU cloud vs. CPU cloud: ключевые отличия в одной таблице
- Практический чеклист перед запуском в GPU cloud
- Часто задаваемые вопросы
- Можно ли использовать GPU cloud для игрового стриминга?
- Какая минимальная конфигурация нужна для fine-tuning BERT?
- Можно ли тренировать модель на нескольких GPU разных провайдеров одновременно?
- Что делать, если модель не помещается в VRAM одной карты?
Почему AI нуждается именно в GPU, а не в обычных процессорах
CPU оптимизирован для широкого набора последовательных и управляющих задач, а GPU — для большого числа параллельных операций. Количество ядер, операций за такт и преимущество в скорости зависят от архитектуры и алгоритма, поэтому фиксированные границы вроде «до 64 ядер» не являются определением CPU.
Обучение нейросетей широко использует матричные операции, которые хорошо распараллеливаются на GPU. Ускорение по сравнению с CPU может быть значительным, но не имеет универсального множителя 10–50: оно зависит от модели, точности, размера пакета, памяти, программного стека и загрузки данных.
Современные ускорители имеют специализированные матричные блоки для форматов вроде FP16, BF16, TF32 и других. Название Tensor Cores принадлежит NVIDIA; AMD использует собственные матричные вычислительные блоки. Преимущество проявляется только тогда, когда фреймворк и модель эффективно используют поддерживаемый формат.
Что такое GPU cloud и чем он отличается от обычного облака
GPU cloud может предоставлять bare-metal серверы, виртуальные машины, контейнеры, целую карту или её изолированную часть. Доступ не обязательно является прямым и без гипервизора; важно выяснить модель виртуализации, гарантии изоляции и фактическую производительность.
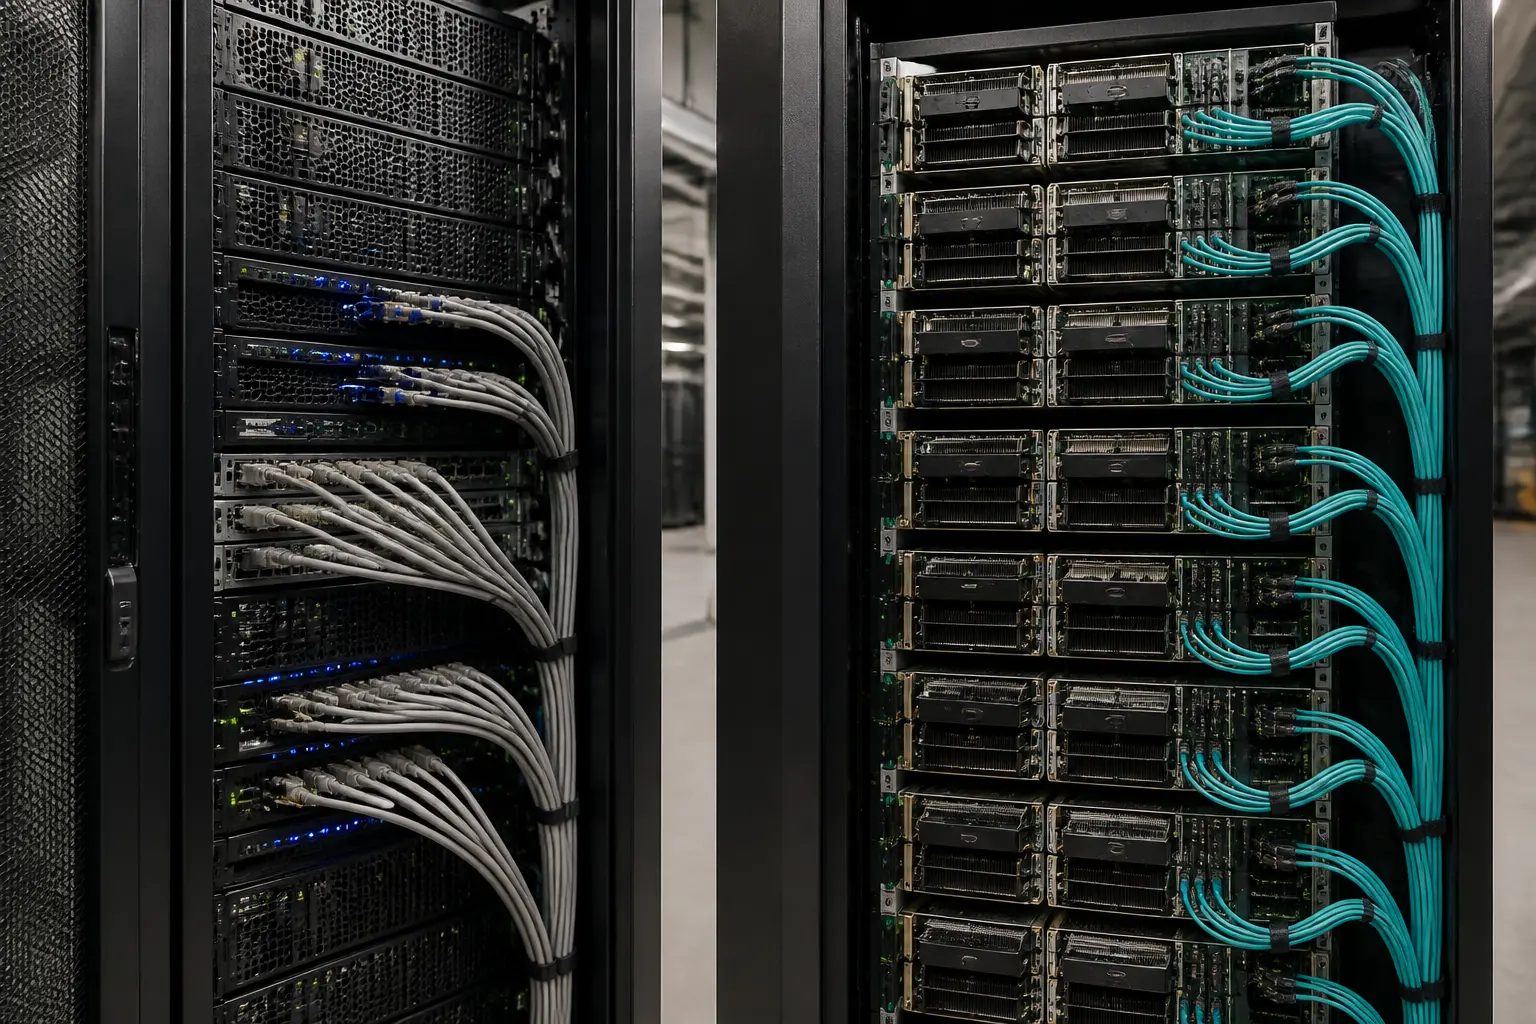
Для больших задач важны не только GPU, но и CPU, оперативная память, локальное и объектное хранилище, пропускная способность и задержка сети. NVLink и NVSwitch соединяют GPU в поддерживаемых системах, тогда как между узлами обычно используют InfiniBand или Ethernet/RoCE; это разные уровни инфраструктуры.
Как работает GPU cloud: от запроса до готового кластера
Провайдер может запускать готовый образ, контейнер или bare-metal систему с драйверами и библиотеками. Состав образа, версии CUDA, PyTorch или TensorFlow и время развёртывания неодинаковы; их нужно фиксировать в конфигурации для воспроизводимости.
GPU может передаваться контейнеру через драйвер, выделяться виртуальной машине, разделяться через vGPU или разбиваться на изолированные MIG-инстансы. Накладные расходы и функциональные ограничения зависят от способа, поэтому утверждение, что GPU «не виртуализируется», слишком широкое.
Распределённое обучение требует библиотеки коллективных операций, планировщика и правильной топологии. NCCL не настраивает кластер автоматически, NVSwitch работает преимущественно внутри поддерживаемой системы, а между узлами нужна быстрая сеть. Дополнительные GPU дают выигрыш только при достаточной эффективности масштабирования.
Кому и когда нужен GPU cloud, а не собственный сервер
Собственный сервер может быть выгоден при стабильной загрузке, но граница зависит от цены оборудования, электроэнергии, охлаждения, персонала, финансирования, срока службы и стоимости простоя. Круглосуточная загрузка не является универсальным критерием.
В облаке вычисления часто оплачиваются за время использования, однако после остановки инстанса могут оставаться платежи за диски, снимки, зарезервированные ресурсы, IP-адреса или исходящий трафик. Перед запуском нужны бюджетные лимиты, автоматическое выключение и проверка тарифов.
Вот основные сценарии, где GPU cloud дает ощутимое преимущество:
- Стартапы без инфраструктурного бюджета, которым нужна гибкость.
- Исследовательские команды, проверяющие десятки гипотез и не желающие ждать в очереди на единственный сервер.
- Пиковые нагрузки — например, подготовка к дедлайну конференции, когда нужно одновременно тренировать несколько моделей.
- Геораспределённые команды, которым нужен общий управляемый доступ к ресурсам с учётом задержки, правил экспорта технологий и требований к данным.
Реальные примеры использования GPU cloud
Чтобы понять ценность, достаточно взглянуть на несколько типичных кейсов из практики ML-инженеров.
Дообучение языковой модели. Потребность в GPU зависит от размера модели, длины контекста, формата весов, оптимизатора и метода — полного fine-tuning или PEFT/LoRA. Не каждая задача требует 4–8 A100, а недельная цена меняется по провайдеру и модели оплаты.
Обучение диффузионной модели. Память определяют разрешение, batch size, архитектура и оптимизации. Stable Diffusion не имеет универсального требования в десятки гигабайт VRAM; для разных режимов возможны потребительские GPU, профессиональные карты или несколько ускорителей.
Инференс в реальном времени. Размещение ближе к пользователю может снизить сетевую задержку, но общее время также зависит от очередей, холодного старта, batch scheduling, модели и передачи данных. Регион нужно выбирать вместе с требованиями к резидентности данных.
Как выбрать провайдера GPU cloud: на что смотреть, кроме цены
На рынке десятки провайдеров, и цена за час — лишь один из факторов. Не менее важны:
- Тип GPU и VRAM. Потребность может составлять от нескольких до сотен гигабайт в зависимости от модели и режима. Проверьте точный GPU, формат чисел, пропускную способность памяти и доступную топологию между картами.
- Сеть. Не существует универсального требования 100 Гбит/с на GPU. Нужную пропускную способность и RDMA/RoCE/InfiniBand определяют размер модели, число узлов, шаблон обмена и целевая эффективность масштабирования.
- Хранение данных. Оцените последовательную и случайную скорость, IOPS, кэширование, пропускную способность до объектного хранилища и стоимость. Наличие NVMe само по себе не гарантирует, что конвейер подаёт данные GPU без простоя.
- География дата-центров. Если вы разрабатываете AI-сервис с жесткими требованиями к latency, наличие дата-центра в вашем регионе может быть решающим.
- API и автоматизация. Для CI/CD-пайплайнов нужна возможность управлять инстансами через API или Terraform-провайдер, а не только через веб-панель.
Проверьте квоты, очереди, гарантию ёмкости и момент начала тарификации. Одни сервисы берут плату только после запуска ресурса, другие имеют резервирование или минимальные обязательства; это нужно читать в условиях конкретного тарифа.
Скрытые риски и как их избежать
GPU-облако снимает многие проблемы, но создает свои. Самая распространенная ошибка новичков — оставить инстанс включенным после завершения тренировки. Провайдер продолжает списывать средства за час, даже если GPU простаивает. Поэтому стоит настроить автоматическое выключение по таймауту или использовать скрипты, которые останавливают инстанс после завершения скрипта тренировки.
Частичный GPU не обязательно означает скрытую конкуренцию. NVIDIA MIG разделяет поддерживаемый GPU на изолированные инстансы с выделенными ресурсами памяти, но имеет ограничения, в том числе для части меж-GPU коммуникаций. Сравнивайте профиль MIG с полной картой и требованиями задачи.
Для конфиденциальных данных проверяйте шифрование, управление ключами, журналы доступа, регион хранения, резервные копии, условия удаления и соответствие нужным стандартам. Уничтожение инстанса не всегда автоматически удаляет диски, снимки или копии.
GPU cloud vs. CPU cloud: ключевые отличия в одной таблице
| Критерий | GPU cloud | Обычное облако (CPU) |
|---|---|---|
| Основной ресурс | Графические процессоры (GPU) | Центральные процессоры (CPU) |
| Назначение | Параллельные вычисления, AI/ML, рендеринг | Веб-серверы, базы данных, бизнес-логика |
| Сетевая инфраструктура | NVLink, InfiniBand, RDMA | Ethernet, стандартные сети |
| Хранилище | NVMe SSD с низкой задержкой | SSD/HDD со стандартной задержкой |
| Ценовая модель | Почасовая, за GPU-час | Почасовая, за vCPU/ОЗУ |
| Типичное использование | Обучение нейросетей, инференс | Хостинг, обработка транзакций |
Практический чеклист перед запуском в GPU cloud
- Оцените реальную потребность в VRAM для вашей модели с учетом размера батча.
- Проверьте, поддерживает ли провайдер нужную версию CUDA и драйверов.
- Настройте автоматическое выключение инстанса после завершения обучения.
- Используйте контейнеризацию для воспроизводимости среды.
- Мониторьте использование GPU во время обучения, чтобы выявить узкие места.
- Убедитесь, что данные загружаются достаточно быстро, чтобы GPU не простаивали.
Часто задаваемые вопросы
Можно ли использовать GPU cloud для игрового стриминга?
Да, если провайдер и лицензии это позволяют, но вычислительный GPU cloud не всегда оптимизирован для интерактивного видео. Для игры важны кодировщик, сетевой маршрут, задержка ввода и готовый клиент; специализированный сервис часто проще.
Какая минимальная конфигурация нужна для fine-tuning BERT?
Единой минимальной конфигурации нет. Она зависит от варианта BERT, длины последовательности, batch size, точности, оптимизатора и полного или параметр-эффективного дообучения. Нужную VRAM лучше измерить на малом запуске, а не определять только названием T4 или A10.
Можно ли тренировать модель на нескольких GPU разных провайдеров одновременно?
Технически отдельные этапы конвейера можно разнести между провайдерами, но синхронное распределённое обучение через публичные сети обычно осложняют задержка, нестабильная пропускная способность, безопасность и стоимость трафика. Для одного тренировочного job практичнее использовать согласованный кластер.
Что делать, если модель не помещается в VRAM одной карты?
Используйте gradient checkpointing, mixed precision, accumulation, sharding, offload, model/tensor/pipeline parallelism или модель с большей памятью. NVLink может помочь на поддерживаемой топологии, но не является обязательным условием многокарточного запуска; важны также PCIe, NVSwitch и межузловая сеть.